
평균, 분산, 표준편차
송찬우 9분 분량
대한민국 초등학교 수학 교육과정에서는 본격적인 확률론·통계학을 다루지는 않지만, ‘자료와 가능성’ 영역을 통해 자료를 표와 그래프로 나타내고 ‘평균’의 개념을 익히며 기초를 쌓는다.
이후 중학교·고등학교 수학에서는 ‘확률과 통계(Probability and Statistics)’ 과목을 통해 이를 체계적으로 학습하게 되며, 대학교 수학 과정에서도 계속 다뤄질 만큼 중요한 분야로 자리 잡고 있다.
이번 포스트에서는 그 확률과 통계의 첫걸음이라 할 수 있는 평균(Mean), 분산(Variance), 표준편차(Standard Deviation)을 다루고자 한다.
평균(Mean)
분산과 표준편차 개념은 와닿진 않더라도 ‘평균’이라는 개념은 우리 일상 속에서 정말 많이 접한다. ‘평균 성적’, ‘~의 평균값’
사전에 따르면 평균은 아래와 같이 정의된다.
「1」 여러 사물의 질이나 양 따위를 통일적으로 고르게 한 것.
「2」 『수학』 여러 수나 같은 종류의 양의 중간값을 갖는 수. 산술 평균, 기하 평균, 조화 평균 따위가 있는데 일반적으로 산술 평균을 이른다. ≒연등, 중수, 평균값, 평균수, 평균치.
- 국립국어원 표준국어대사전
보통 우리가 말하는 평균은 ‘산술 평균(arithmetic mean)’을 이른다고 한다.
이번 포스트에서는 산술 평균 개념만을 다루겠다. 다른 기하 평균과 조화 평균은 다른 포스트에서 다루겠다.
자료들을 대표하는 값인 대푯값(representative value)은 평균(mean), 중앙값(median value), 최빈값(mode), 사분위수(quartile), 백분위수(percentile), 절사평균(trimmed mean) 등이 있다.
그중에서도 ‘평균’은 대표적으로 사용되는 대푯값이다.
평균(산술 평균)은 자료들의 값을 다 더한 후, 자료의 개수로 나눈 값이다. 이를 수식으로 아래와 같이 표현할 수 있다.
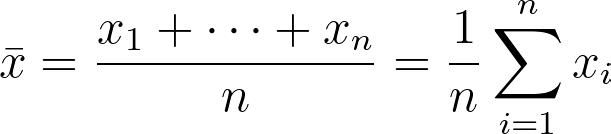
확률과 통계 과목에서 평균값을 나타내는 기호로 μ(mu)와 x̄(x bar)를 많이 봤을 텐데, μ 값은 모집단(Population)에서의 평균(모평균)을, x̄ 값은 모집단에서 추출한 표본(Sample)에서의 평균(표본평균)을 말한다.
여기서, ‘확률변수’를 배운 사람이라면
‘기댓값(Expected Value)’은 평균이다.
라는 말을 들어본 적 있을 것이다.
기댓값이란, 같은 확률 실험을 같은 조건에서 여러 번 반복했을 때 그 결과값들의 평균이 점점 가까워지는 값을 말한다.
‘기댓값’은 다음 ‘확률변수’ 포스트에서 더 자세히 다루도록 하겠다.
예를 들어, 공평한 동전을 던질 때 앞면이 나오면 1,000원을 받고, 뒷면이 나오면 0원을 받는 게임을 생각해 보자. 앞면과 뒷면이 나올 확률은 각각 50%이다. 몇 번 던져 보면 0원만 받을 수도 있고, 1,000원만 받을 수도 있지만, 이 실험을 충분히 많이 반복하면 한 번당 벌게 되는 돈의 평균은 500원 근처로 모이게 된다. 처음에는 얼마나 얻을지는 모르지만, 더 많이 동전을 던져보면 평균적으로 500원을 얻을 수 있을 것이다. 기댓값을 계산해보면 500원을 얻을 수 있는 것을 알 수 있다.
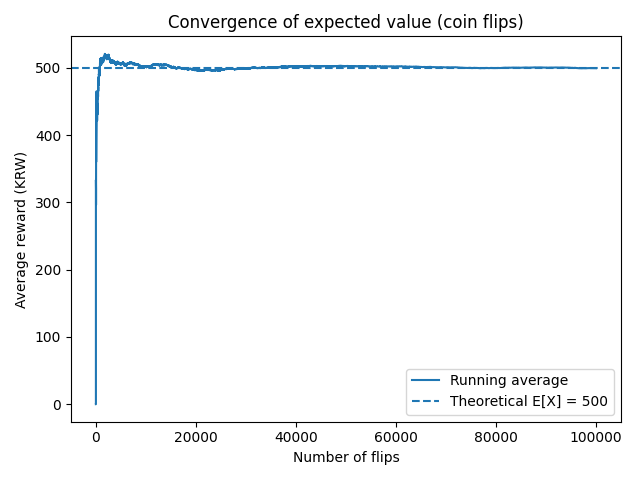
위 그래프는 Python으로 랜덤 함수를 활용해 시행을 10만 번 돌렸을 때 평균값을 구한 그래프이다.
즉, 1,000원과 0원이 각각 절반의 확률로 나올 때 그 “평균값”이 500원이 되는 것처럼, 기댓값을 ‘확률변수가 가지는 평균’으로 이해할 수 있다.
분산(Variance)
우리는 일상 속에서 ‘~는 잘 분산되어 있다’라는 말을 쓰곤 한다. 여기서 말하는 ‘분산’은 풀어서 말하면 ‘고르게 잘 퍼져있다’와 같은 의미로 쓸 수 있을 것이다. 예를 들어, 아래와 같은 A반과 B반의 10명의 시험 성적(0 ~ 100점) 자료가 있다고 하자.
- A반: 78, 79, 80, 80, 81, 82, 79, 81, 80, 80
- B반: 50, 60, 70, 80, 90, 90, 95, 100, 85, 80
A반의 성적들은 눈으로 보기에도 대체로 80점 근처에 있는 것을 확인할 수 있다. 반면, B반은 정확히 몇 점 근처에 성적이 분포하고 있다고 말하긴 어렵다.
내가 생각하는 ‘분산’의 의미는 이런 것이다. B반과 같은 자료가 하나 더 있다면, 어느 반이 더 고르게 분포되어 있는지 수치적으로 나타낼 수 있는 지표.
「3」 『수학』 통곗값과 평균값의 차이인 편차를 제곱하여 얻은 값들의 산술 평균. 분산이 작으면 자료는 평균값 주위에 모여 있게 되고, 분산이 크면 자료 가운데 평균값에서 멀리 떨어진 것이 많게 된다.
수학적 ‘분산’의 정의를 이해하기 위해서는 통곗값과 평균값의 차이인 ‘편차’, 이들을 제곱해 얻은 값들의 평균값임을 이해해야 한다.
‘편차(Deviation)’라는 것을 구하기 위해서는 자료들의 ‘평균’을 얻어야 하며, 각각의 자료값들마다 평균과의 차이를 구해준다. 수식으로 표현한다면 아래와 같을 것이다.
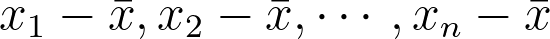
위를 제곱해 모두 더해준 뒤, 자료의 개수(n)로 나눠주면(평균), ‘분산’을 구할 수 있다. 수식으로는 아래와 같을 것이다.
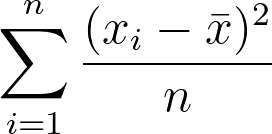
위 성적 자료들을 가지고, 분산을 구하면 아래와 같다.
- A반 분산: 1.2
- B반 분산: 225.0
분산이 적을 수록, 자료들이 고르게 분포됨을 알 수 있다.
다만, 여기서 포인트는 편차의 ‘제곱’ 합이라는 것이다. 왜 그냥 차이를 더해도 될 것 같은데 제곱해서 더하는 것일까?
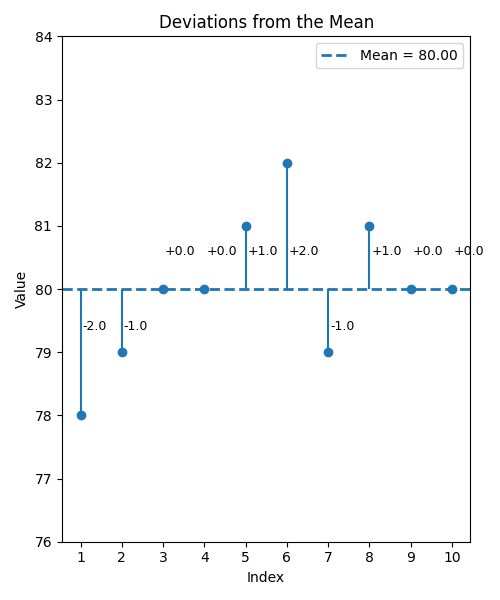
우선, 가장 큰 문제로는, 편차의 합은 0이라는 것이다. 정말로 그런지 궁금한 사람들은 위 제시했던 성적 자료들을 가지고 편차를 구해서 더해봐라. 위 자료들의 평균은 80이다. 편차를 구해 모두 더해보면 결국 0으로 수렴한다.
수학적으로 증명하려고 한다면 아래와 같다.
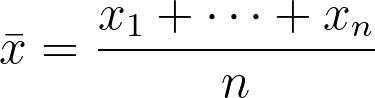
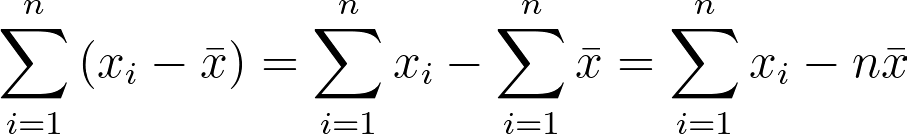
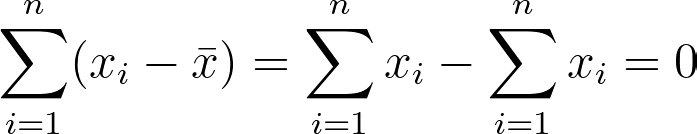
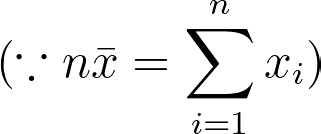
위를 통해 편차의 합은 0이라는 것을 알 수 있다.
그렇다면, “음수와 양수가 서로 상쇄되는 문제”만 해결하면 되니, 언뜻 보면 편차를 절댓값 씌워 더하면 될 것 같은 생각이 든다. 그런데 왜 하필이면 제곱일까?
여기에는 여러 가지 이유가 있다.
1. 수학적으로 다루기 훨씬 편하다.
미분을 아는 사람이라면 알겠지만, 절댓값 |x| 함수는 첨점(cusp point)이 생기기 때문에 모든 구간에서 미분이 가능하지 않다. (x = 0에서 미분 불가능)
우린 이후에 오차의 합이 최소가 되도록 하는 값을 찾아야 한다. 이때 미분을 사용하면 최소값을 효율적으로 구할 수 있기 때문에, 함수가 미분 가능하다는 점이 중요하다.
확률·통계의 많은 이론이 ‘평균’을 중심에 두고 전개되다 보니, 자연스럽게 제곱편차가 표준 선택이 된 셈이다.
2. 성립하는 성질들이 뒤따라온다.
이후 확률변수를 다루면서 아래와 같은 성질들을 다룰 것이다.
- Var(aX + b) = a²Var(X)
- Var(X + Y) = Var(X) + Var(Y) (확률변수 X와 Y가 독립일 때)
이러한 관계들은 ‘제곱편차’를 사용하기 때문에 성립한다. 덕분에 여러 확률변수의 합 등을 다룰 때, 분산을 손쉽게 계산하고 나중에 배울 신뢰구간·가설검정 같은 이론도 체계적으로 전개할 수 있다.
3. 큰 편차가 더 강하게 반영한다.
제곱을 활용했다는 것은 곧, ‘기하급수적’인 변화를 기대할 수 있다.
평균에서 멀리 떨어진 극단값이 있을 경우, 분산은 이를 더욱 크게 반영해주는 효과를 기대할 수 있다.
위같은 이유로 파생되는 평균 오차 제곱(Mean Squared Error, MSE) 등과 같은 개념들이 많이 나온다. 이런 이야기들은 통계 및 머신러닝 쪽으로 들어가면 끝도 없어, 관심있는 사람들은 꼭 한번씩 찾아보며 확장하는 것을 추천한다.
표준편차(Standard Deviation)
표준편차는 확률과 통계 과목을 공부하면서 정말 많이 만날 친구이니, 개념을 잘 정리하길 바란다.
표준편차는 간단히 말해, 분산에 제곱근을 씌운 값이다.
『수학』 자료의 분산 정도를 나타내는 수치. 분산의 양의 제곱근으로, 표준 편차가 작은 것은 평균값 주위의 분산의 정도가 작은 것을 나타낸다.
보통 모집단에서의 표준편차는 σ(sigma)를, 추출한 표본에서의 표준편차는 s를 쓴다. 분산은 표준편차의 제곱이기 때문에, 각각 σ², s²을 쓰게 된다.
그렇다면 분산이 분산이지, 왜 ‘분산의 정도’를 표준편차라는 걸로 다시 정의하는 걸까?
우선, 퍼져있는 정도의 ‘단위’를 맞춰주기 위함도 있다.
분산은 편차의 제곱합. 제곱이라는 것에 초점을 맞춰 생각해보자.
예를 들어 자료 하나에 대한 편차의 제곱이 아래와 같다고 하자. (성적에 대한 자료이므로, 단위는 ‘점’이라고 하자.)
(75점 – 80점)² = (-5점)² = 25점² ?
우리가 살면서 “~점이다.” 라는 것은 이해해도, ‘~점²’라는 것을 본 적이 있던가?
이러한 점에서 제곱근을 적용함으로써 우리가 직관적으로 이해할 수 있는 단위로 맞춰주기 위함이 있다. 위 예시만 보더라도, ‘25점²만큼의 퍼짐이 있다.’라는 것보다는 ‘평균으로부터 5점 내외에 분포하고 있다.’라는 말이 더욱 와닿을 것이다.
스케일을 우리가 직관적으로 이해할 수 있게끔 줄여주고, 단위를 맞춰줄 수 있다는 점에 있어서 표준편차는 분산의 제곱근을 사용한다.
또한, 이후 다룰 ‘정규분포’에서도 분산보다는, 표준편차로 일반화된다.
단순히 생각해봐도, 공식에서 분산의 제곱근을 쓰는 것보다는 제곱근이 이미 적용된 표준편차를 쓰는 것이 편할 것이다.
물론 쓰기 편하기 때문에 표준편차를 쓰는 것은 아니지만, 정규분포에서 ‘분포의 폭’을 직접적으로 조절하는 건 σ(표준편차)이다.
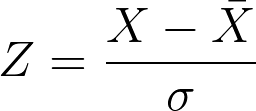
나중에 정규분포를 다룰 때 더 자세히 다루겠지만, 위와 같은 공식에서도 직접적으로 쓰이는 것은 σ(표준편차)이다.
표준편차는 자료를 전체적인 관점에서 해석할 때, 평균으로부터 얼마만큼의 정도로 분포하고 있는지 말할 수 있는 지표이다.
마무리
다음 포스트에서는 앞서 많이 언급했던 ‘확률변수(Random Variable)’와 ‘기댓값(Expected Value)’에 대해서 다뤄보도록 하겠다.