Kimi K3.1 Pro는 정말 Opus 5.5를 따라잡았을까?
송찬우 5분 분량
10월 23일(미국 시간) 중국 Moonshot AI가 Kimi K3.1 Pro를 공개했습니다. 6월에 가중치를 공개한 Kimi K3를 사후 학습으로 더 키운 모델이에요. 100만 토큰 문맥을 지원하고, 속도를 2~3배 높인 Kimi K3.1 Pro Highspeed도 같이 나왔습니다. 가중치는 11월 4일까지 공개한다고 밝혔고요.
반응도 큽니다. 해커뉴스에서 672점, 댓글 427개를 받았고, 모델 성능을 독립적으로 재는 Artificial Analysis는 Kimi K3.1 Pro가 지능 지수에서 Claude Opus 5.5, Claude Sonnet 5.5, Muse Wonder Full 다음으로 4위라고 발표했습니다. 가중치가 공개되면 오픈 모델 중 1위가 된다고 덧붙였어요. 그렇다면 Kimi K3.1 Pro는 정말 Opus 5.5를 따라잡았을까요?
결론부터 말하면, 에이전트 일은 따라잡았고 코딩은 아직입니다.
Moonshot이 공개한 비교표에는 Kimi K3.1 Pro와 Claude Fable 5.1, GPT-6 Astra, Claude Opus 5.5, DeepSeek-V4.1-Flash-1017, GLM-5.3이 벤치마크 46개에서 맞붙어 있습니다. 모두 추론 강도를 최대로 올린 결과예요.
46개 가운데 Kimi K3.1 Pro가 가장 높은 점수를 받은 건 16개로, 6개 모델 중 가장 많습니다. Opus 5.5는 14개, GPT-6 Astra는 11개였어요. Kimi K3.1 Pro와 Opus 5.5 둘만 놓고 보면 둘 다 점수가 있는 41개 중 Kimi가 21개에서 이기고 20개에서 졌습니다. 숫자로는 거의 동률입니다.
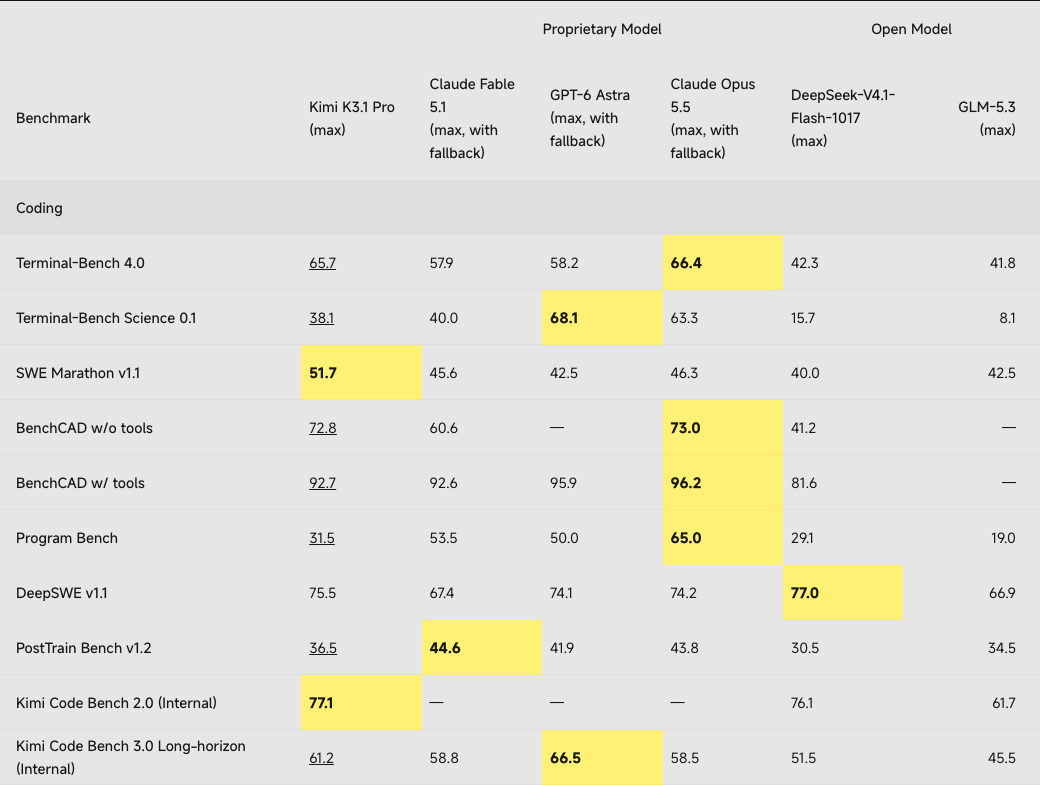
그런데 분야별로 나누면 그림이 달라집니다. 문서 분석, 웹 검색, 금융 업무처럼 여러 단계를 거치는 에이전트 벤치마크 25개에서는 Kimi가 Opus 5.5에 15승 7패로 앞섭니다. 반대로 코딩 벤치마크 10개에서는 3승 6패예요.
코딩은 Opus 5.5가 아직 앞섭니다.
Moonshot이 블로그 첫머리에 내세운 숫자는 Terminal-Bench 4.0입니다. 실제 터미널 환경에서 코딩 에이전트가 과제를 해내는지 보는 벤치마크인데, Kimi K3.1 Pro가 65.7%로 GPT-6 Astra(58.2%)보다 높고 Opus 5.5(66.4%)에 0.7포인트 뒤졌어요.
다른 코딩 벤치마크에서는 차이가 더 벌어집니다. Terminal-Bench Science 0.1은 38.1 대 63.3, Program Bench는 31.5 대 65.0으로 Opus 5.5가 크게 앞섭니다. Kimi가 이긴 건 오래 걸리는 소프트웨어 과제를 보는 SWE Marathon v1.1(51.7 대 46.3), DeepSWE v1.1(75.5 대 74.2), Moonshot 내부 벤치마크 정도예요.
에이전트 쪽은 다릅니다. 도구를 쓰며 푸는 Humanity’s Last Exam(HLE-Full)에서 70.0으로 Opus 5.5(67.7)보다 높고, 웹을 뒤져 답을 찾는 BrowseComp에서 92.1로 GPT-6 Astra(91.5), Opus 5.5(90.8)를 앞섭니다. 재무 문서를 분석하는 OfficeQA Pro v2도 64.4로 표에서 가장 높아요. Moonshot이 이번에 금융 업무와 3D 제작을 따로 강조한 이유가 여기 있습니다.
값은 Opus 5.5의 절반입니다.
Kimi API에서 Kimi K3.1 Pro는 100만 토큰당 입력 2달러(약 2,650원), 출력 10달러(약 1만 3,200원)입니다. Opus 5.5는 입력 4달러(약 5,300원), 출력 20달러(약 2만 6,500원)라 딱 절반이에요. 이전 모델 Kimi K3의 입력 3달러(약 4,000원), 출력 15달러(약 2만 원)보다도 쌉니다. Highspeed는 Kimi K3.1 Pro의 2배 값입니다.
다만 말이 많습니다. Artificial Analysis가 지능 지수를 재는 동안 Kimi K3.1 Pro는 출력 토큰 1억 5천만 개를 썼는데, 다른 모델들의 중간값은 8,700만 개였어요. 토큰값이 싸도 같은 일에 토큰을 더 쓰면 차이가 줄어듭니다. Artificial Analysis가 계산한 과제 하나당 비용은 2.11달러(약 2,800원)였고, 출력 속도는 초당 77.1토큰으로 186개 모델 중 106위입니다.
지난 10월 19일 ‘DeepSeek V4.1 Flash 1017은 정말 Opus 5를 이겼을까?’에서 본 것처럼, 오픈 모델은 값을 무기로 상위 모델을 쫓아왔습니다. Kimi K3.1 Pro는 그 추격이 Opus 5.5 바로 아래까지 왔다는 걸 보여 줍니다.
해킹 능력은 일부러 낮췄습니다.
이번 발표에서 가장 많이 이야기된 건 성능보다 사이버 보안 대목입니다. Moonshot은 사후 학습을 늘릴수록 취약점 연구 능력이 꾸준히 올라가는 걸 봤고, 원인을 추적해 보니 일반 학습 데이터와 강화 학습 환경에 사이버 보안 관련 데이터가 섞여 있었다고 밝혔어요. 그래서 오픈 웨이트로 공개할 Kimi K3.1 Pro에서는 이 데이터를 찾아 두 단계 모두에서 뺐습니다.
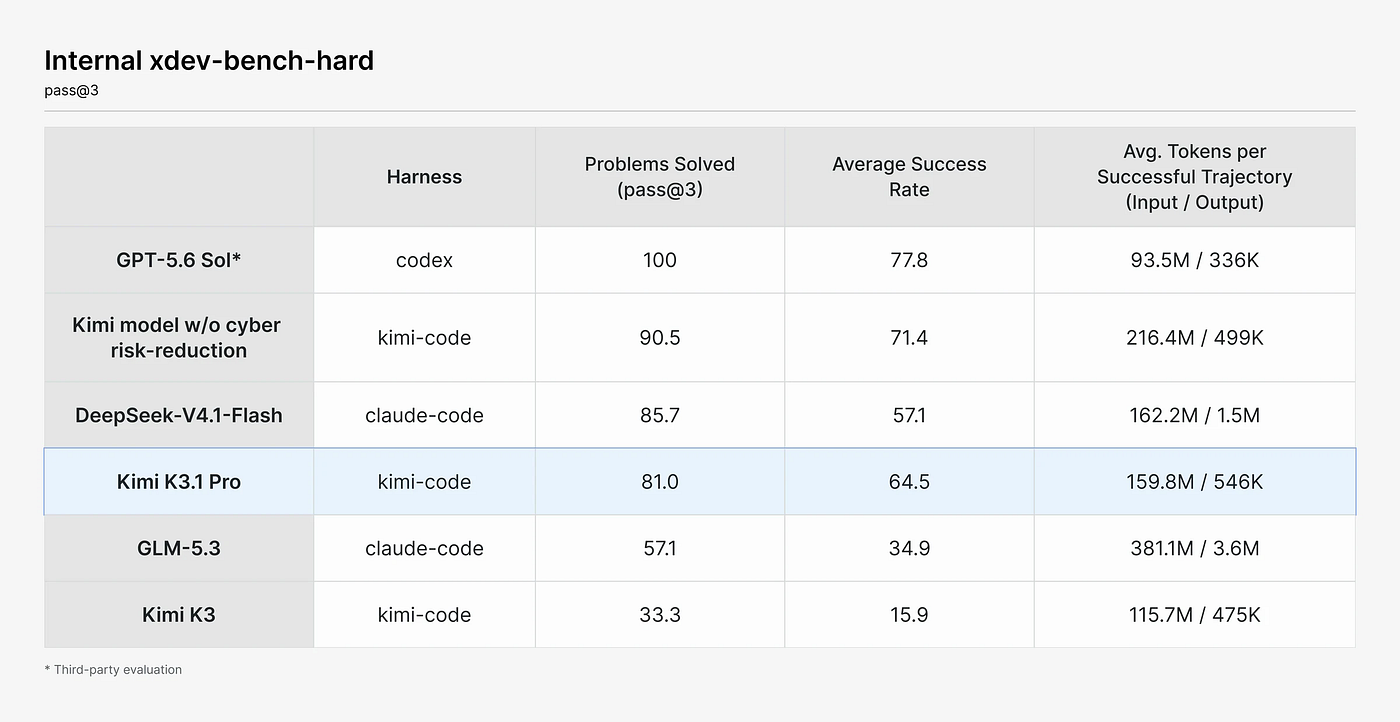
효과는 내부 벤치마크 xdev-bench-hard로 보여 줬습니다. 리눅스 커널, Node.js 같은 소프트웨어의 실제 취약점을 재현한 과제에서 공격 코드를 만들어 실행까지 해내야 하는 시험이에요. 데이터를 빼지 않은 같은 파이프라인의 모델은 문제의 90.5%를 풀었고, 공개용 Kimi K3.1 Pro는 81.0%를 풀었습니다. 그래도 이전 모델 Kimi K3(33.3%)보다는 훨씬 높아요.
Moonshot은 오픈 웨이트로 사이버 능력의 최전선을 넓히지는 않겠다고 했습니다. 공개 벤치마크에서도 Kimi K3.1 Pro는 ExploitBench 74.7로 Opus 5.5(91.0), GPT-6 Astra(100)보다 낮습니다. 동시에 오픈 웨이트에서 쓸 수 있는 사이버 능력은 조금씩 높여 가겠다고 밝혔어요. 직접 돌릴 수 있는 모델이 많아지면 보안 점검을 받기 어려운 오래된 시스템까지 더 많은 팀이 들여다볼 수 있다는 이유입니다.
해커뉴스에서도 이 대목에 가장 긴 토론이 붙었습니다. 일부러 능력을 낮췄다는 걸 인정한 거라며 주목하는 댓글이 있었고, 사이버 데이터를 뺀 건 아쉽다는 반응도 있었어요.
직접 돌리려면 GPU 서버 한 대가 통째로 필요합니다.
Kimi K3.1 Pro 가중치는 아직 공개 전입니다. 다만 Kimi K3를 사후 학습한 모델이라, 구조가 같다면 Kimi K3 기준으로 규모를 가늠할 수 있습니다. Kimi K3는 전체 매개변수 2.8조 개 중 토큰마다 1,040억 개만 쓰는 전문가 혼합(MoE) 모델이고, SFT 단계부터 4비트(MXFP4)에 맞춰 학습해 공개 파일 크기가 약 1,561GB(1,454GiB)예요.
vLLM 안내에는 GB300 GPU 8장 이상이 필요하다고 적혀 있습니다. AWS에서 같은 세대 B300 GPU 8장을 묶은 p6-b300.48xlarge는 GPU 메모리가 2,100GiB이고, 온디맨드 값이 시간당 142.4달러(약 18만 9천 원)입니다. 한 달 내내 켜 두면 약 10만 2,500달러(약 1억 3,600만 원)예요. 가중치를 올리고 남는 약 650GiB로 100만 토큰 문맥을 얼마나 처리할 수 있는지는 실제로 돌려 봐야 압니다.
더 작게 줄인 버전도 있습니다. Unsloth가 Kimi K3를 양자화한 파일은 가장 작은 1비트 버전이 466.4GB이고, Unsloth가 품질과 크기의 균형으로 권하는 UD-IQ1_S는 594GB입니다. Unsloth 안내 기준으로는 RAM과 VRAM을 합쳐 약 610GB가 있어야 해요. Kimi K3.1 Pro의 양자화 버전은 가중치가 공개된 뒤에 나올 것으로 보입니다.
다만 Moonshot이 직접 잰 숫자가 많습니다.
비교표의 점수 일부는 Moonshot이 직접 돌린 결과이고, 내부 벤치마크도 섞여 있습니다. Claude 모델은 일부 과제에서 대체 응답(fallback)이 섞였을 수 있다고 표 아래에 적혀 있고요. Terminal-Bench 4.0도 Kimi는 Claude Code 하네스로 평가했습니다. Kimi K3의 23.4%에서 8.3%로 줄였다는 환각 비율도 Moonshot 내부 시험이고, 일상적인 사용에서의 오류율이 아니라고 블로그에 밝혀 두었어요.
구독 요금제 사용량이 빠듯하다는 사용자 불만도 해커뉴스에 올라왔습니다. 99달러(약 13만 1천 원) 요금제에서 세션 하나로 47분 만에 5시간 한도에 걸렸다는 내용이에요. 한 사람의 경험이지만, 토큰을 많이 쓰는 모델이라는 점과 맞물려 있습니다.
그래도 흐름은 분명합니다. Moonshot은 Opus 5.5와 비슷한 수준의 모델을 절반 값에 내놓고 가중치까지 풀겠다고 했습니다. 코딩에서는 아직 차이가 남았지만, 에이전트 일에서는 오픈 모델과 최상위 모델의 차이가 거의 사라지고 있는 것 같습니다.