AI가 쓴 글은 왜 읽기 어려울까?
송찬우 5분 분량
10월 21일(미국 시간) 뉴욕대와 텍사스대 오스틴의 언어학자 세 명이 arXiv에 「Why is AI-generated language so hard to understand?」라는 논문을 올렸습니다. 제목 그대로 AI가 쓴 글은 왜 읽기 어려운지 따져 본 연구예요. Claude Opus 5.5, Fable 5, GPT-5.6 Sol 같은 최신 모델이 쓴 글을 심리언어학 지표로 뜯어봤습니다. 해커뉴스에서는 168점, 댓글 152개가 달렸고 GeekNews에도 올라왔습니다.
AI 답변을 읽다가 문장을 두 번 읽은 경험은 흔합니다. 틀린 말은 없는데 머리에 잘 안 들어오는 문장이죠. 그렇다면 AI가 쓴 글은 왜 읽기 어려울까요?
결론부터 말하면, 정답만 맞히도록 훈련한 탓일 수 있습니다.
연구진의 가설은 이렇습니다. 사람의 언어는 오랫동안 상대가 알아듣는 쪽으로 다듬어졌습니다. 그런데 요즘 모델은 수학, 코딩, 추론 문제에서 정답을 맞히면 보상을 받는 방식으로 길게 훈련합니다. 이 훈련에서는 알아듣기 쉬운지가 점수에 들어가지 않고, 문맥 창도 한정돼 있어 적은 토큰에 많은 정보를 담는 쪽이 유리합니다. 그 결과 사람이 읽기 힘든 압축된 문장이 늘었다는 겁니다.
논문 첫 문장부터 예시입니다. “Your instinct is right; the convoluted sentence you are currently reading is quietly eating its own reader-patience budget — footnote it.” 연구진은 이 문장을 보면 최신 LLM이 썼다고 의심할 거라며, 읽기 어렵게 만드는 특징 네 가지가 한 문장에 다 들어 있다고 설명합니다. that을 뺀 관계절, 명사를 그대로 동사로 쓴 footnote, 사람이 아닌 문장이 무언가를 먹는다는 표현, 그리고 명사 세 개를 붙인 reader-patience budget입니다.
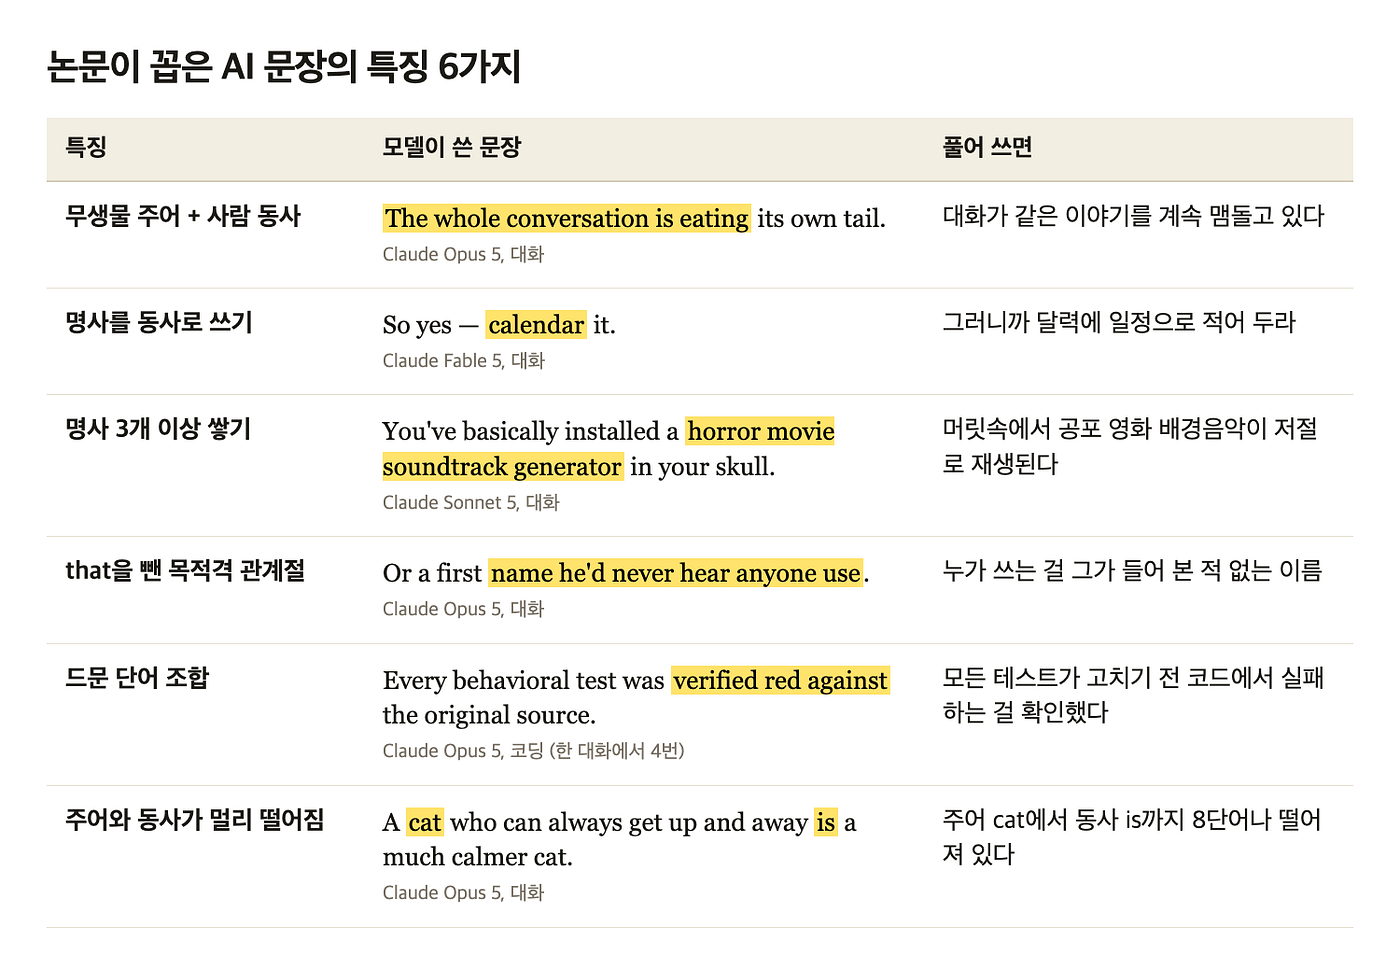
9개 모델 모두 사람보다 이런 문장을 많이 썼습니다.
연구진은 모델 14개로 글을 모았습니다. 최상위급 9개는 Claude Sonnet 5, Opus 5, Opus 5.5, Fable 5, GPT-5.6 Luna, Terra, Sol, GLM-5, Kimi K2.5이고, 비교용 작은 공개 모델 5개는 Llama 3.1 8B(base, Instruct)와 Olmo 3 7B(base, Instruct, Think)예요. 글은 세 가지 상황에서 받았습니다.
- 대화: 주제 10개로 12턴씩 120개 대화, 답변 1,428개. 사람 역할은 Claude Sonnet 4.6이 맡았습니다.
- 코딩: 실제 깃허브 저장소 5개에서 버그를 찾아 고치는 에이전트 세션 45개.
- 에세이: 미국 중고생 논술 과제 7개로 모델마다 70편, 모두 980편.
사람 쪽 기준은 영화 자막(대화), StackExchange(코딩), 같은 과제에서 높은 점수를 받은 학생 에세이 2,934편입니다. 모든 모델을 같은 에이전트 도구 Pi로 같은 프롬프트 아래 돌려서, 회사마다 다른 앱 설정이 끼어들지 않게 했어요.
결과는 분명했습니다. 최상위급 9개 모두 사람 글보다 무생물 주어에 사람 동사를 붙인 문장과 사람 글에서는 드문 단어 조합을 더 많이 썼습니다. 대화에서는 대부분의 모델이 주어와 동사 사이를 더 멀리 벌리고, 명사를 더 쌓고, that을 빼고 관계절을 더 자주 썼습니다.
번역기를 한 번 돌리면 문장이 쉬워집니다.
“원래 어려운 내용이라 문장도 어려운 것 아니냐”는 반론이 나올 수 있습니다. 연구진은 이를 왕복 번역으로 확인했습니다. 모델이 쓴 문장을 하나씩 메타의 번역 모델 NLLB-200으로 일본어로 옮겼다가 다시 영어로 옮기면, 뜻은 그대로 두고 표현만 흔한 형태로 바뀝니다. 이렇게 바꾼 문장에서 특징이 줄어든다면, 내용 때문이 아니라 모델이 일부러 그 표현을 골랐다는 뜻이 됩니다.
실제로 거의 모든 최상위급 모델에서 드문 단어 조합, 명사를 동사로 쓴 표현, 무생물 주어, that 없는 관계절이 줄었습니다. 반대로 Llama 모델과 Olmo base는 거의 변하지 않았어요. 드문 단어 조합에서는 같은 Olmo 안에서도 base, Instruct, 추론용 Think 순으로 차이가 커졌고, Olmo Think는 최상위급 모델만큼 컸습니다. 사전 학습만 한 모델은 사람처럼 쓰고, 사후 학습, 특히 추론 훈련을 거칠수록 문장이 달라진다는 이야기입니다.
상황별로는 단발 에세이보다 길게 주고받는 대화와 코딩에서 차이가 컸습니다. 연구진은 대화가 길어질수록 정보를 더 압축하려는 경향이 생기는 것 같다고 봤어요.
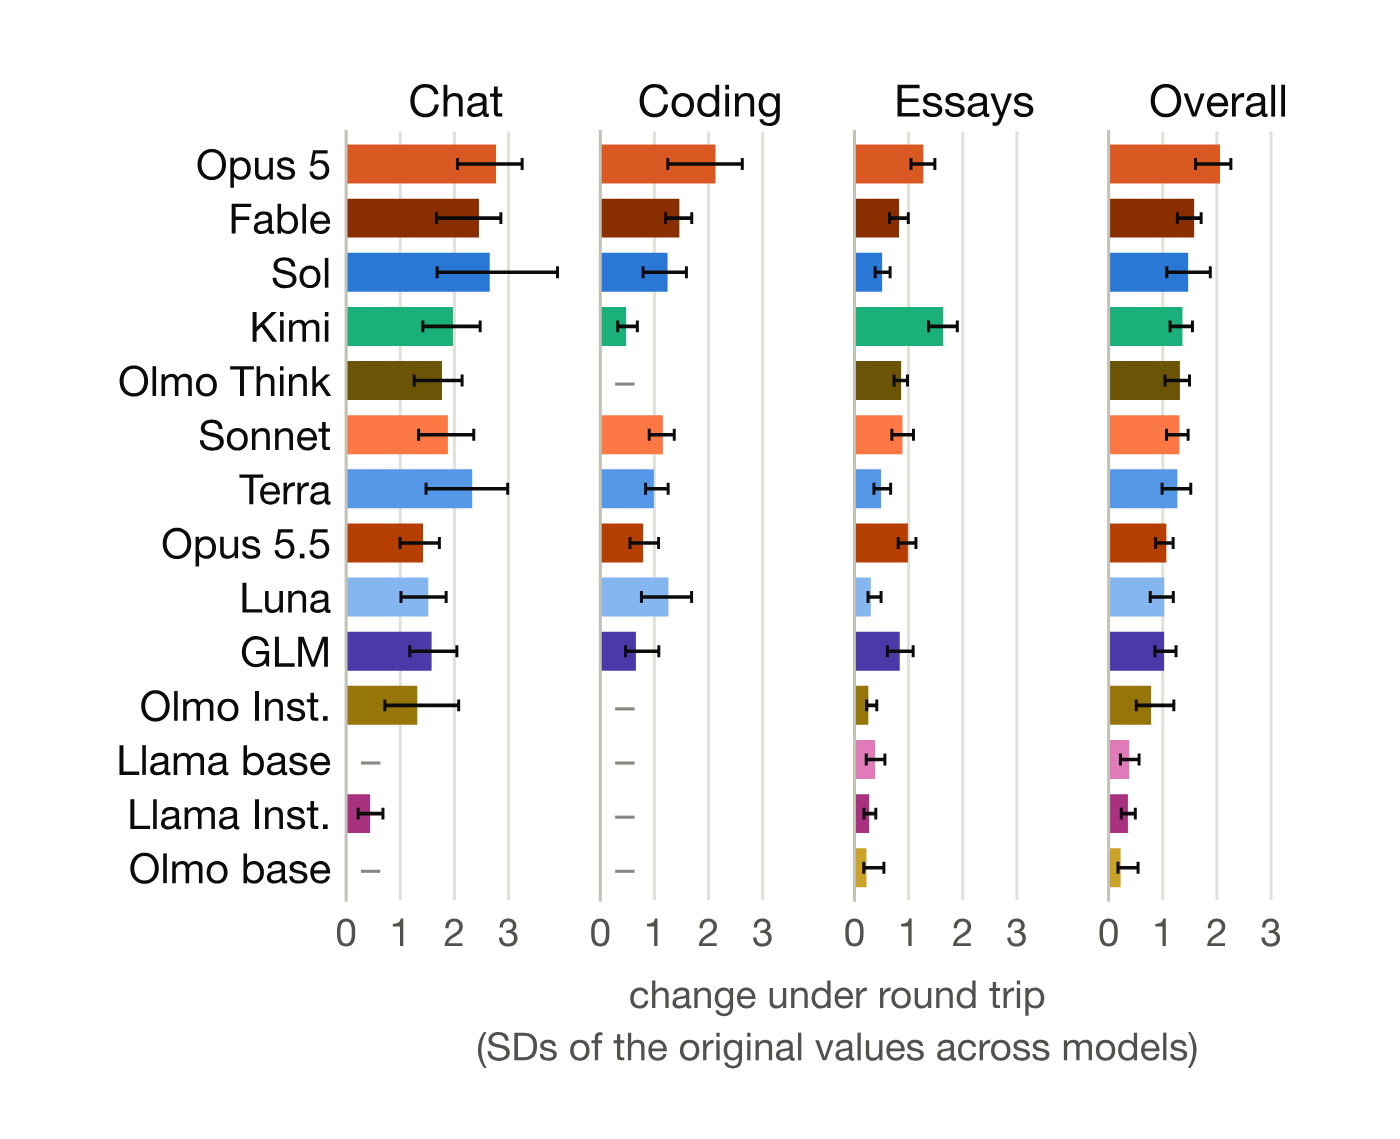
모델별로 보면 Claude Opus 5의 변화 폭이 가장 컸습니다. 흥미로운 건 후속작 Claude Opus 5.5예요. 읽기 어려움과 연결된 지표 21개 비교 중 19개에서 Opus 5보다 낮았고, 그중 8개는 신뢰구간이 겹치지 않을 만큼 차이가 뚜렷했습니다. 연구진은 이를 두고 소통을 잘하도록 보상하는 것도 충분히 가능하다는 근거로 들었습니다.
길이에 벌점을 주자 문법이 바뀌었습니다.
두 번째 실험은 원인을 직접 건드려 봤습니다. 작은 공개 모델 Qwen2.5-1.5B-Instruct에게 JSON으로 된 사건 정보를 영어 문장 하나로 바꾸는 일을 시키고, 강화 학습(GRPO)으로 훈련하면서 답이 길면 벌점을 줬습니다. 이 과제는 “He sent us a photo”와 “He sent a photo to us”처럼 뜻이 같고 길이만 한 토큰 다른 두 표현이 모두 정답입니다.
벌점을 조금만 줘도 모델은 짧은 쪽으로 쏠렸습니다. 원래 모델에서 멀어지지 못하게 묶는 장치(KL 규제)를 끄면, 훈련한 that 생략 구문 두 가지에서 짧은 표현을 고르는 비율이 벌점을 준 모든 경우에 98%를 넘었습니다. 사람은 문맥에 따라 that을 넣었다 뺐다 하는데, 모델은 무조건 빼게 된 거예요.
더 눈에 띄는 건 번진다는 점입니다. 훈련에 없던 “sure (that)”, “so (that)” 같은 구문에서도 that을 빼기 시작했습니다. 아예 다른 종류의 구문으로 번진 경우는 소유격(“X’s Y” 대 “Y of X”) 하나뿐이었고, 그것도 KL 규제를 껐을 때만 나타났습니다.
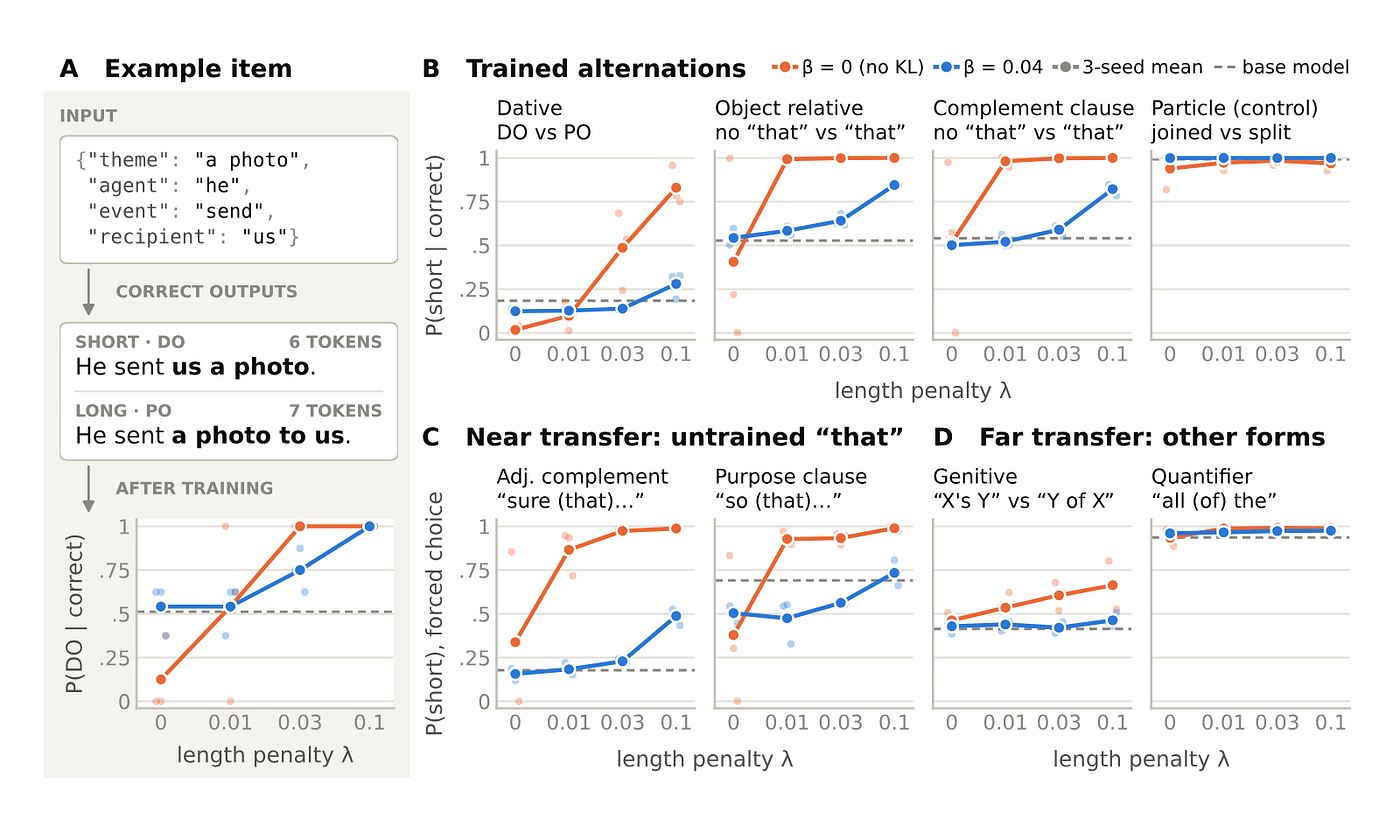
연구진은 사람의 피드백으로 훈련하던 시절(RLHF)에는 오히려 긴 답이 보상받았다는 기존 연구를 들어, 압축 압력은 정답을 자동으로 채점하는 훈련(RLVR)에서 왔을 가능성이 크다고 봤습니다. 채점에서 사람이 빠지면서 알아들을 수 있는 말을 쓰라는 압력도 함께 빠졌다는 거죠. 지난달 ‘왜 내가 만든 디자인은 AI스러울까?’에서 다뤘던, AI가 만든 결과물에서 AI 티가 나는 이유를 글에서 찾은 셈입니다.
읽는 사람은 결국 사람입니다.
이 결과가 가장 와닿는 곳은 에이전트를 실무에 붙이는 현장입니다. 차이가 가장 크게 나온 상황이 코딩이었는데, 코딩 에이전트가 쓰는 PR 설명, 커밋 메시지, 작업 요약은 개발자와 고객사 담당자가 매일 읽는 글입니다. 에이전트가 일을 맞게 해 놓고도 보고서가 읽히지 않으면, 사람이 검토하는 데 시간이 더 들고 놓치는 것도 생깁니다. 연구진도 결론에서 사용자 경험과 함께 모니터링 가능성, 곧 사람이 AI가 한 일을 읽고 확인할 수 있는지를 이유로 들었습니다.
해커뉴스 댓글에서도 비슷한 이야기가 나왔습니다. 한 사용자는 Opus 5.5가 자기만 아는 말로 설명할 때 “다섯 살에게 설명하듯 다시 써 달라”고 하면 대개 풀린다고 적었고, 다른 사용자는 모델이 읽을 사람을 떠올리지 않고 직전 대화와 지시만 보고 쓰는 게 문제라고 했어요. 반대로 AI 글이 오히려 더 잘 읽힌다는 댓글도 있었습니다.
그래서 보고서를 쓰는 에이전트에는 누가 읽는지를 지시문에 적어 주는 게 지금 할 수 있는 현실적인 방법입니다. 고객사 담당자가 읽는 요약과 다음 에이전트가 이어받을 작업 메모는 다르게 써야 하니까요. Opus 5.5가 Opus 5보다 나아진 걸 보면, 모델 회사들도 이 문제를 훈련으로 고칠 수 있다는 걸 알고 있는 듯합니다.
다만 영어로만, 적은 표본으로 본 연구입니다.
연구진이 직접 밝힌 한계도 있습니다. 분석은 영어로만 했고, 대화 주제 10개와 저장소 5개로 표본이 크지 않습니다. 모델 회사의 실제 사후 학습을 들여다볼 수는 없어서, 원인은 작은 모델 실험으로 간접 확인했을 뿐이에요. 데이터를 모으는 데 든 API 비용은 모두 251.19달러(약 33만 원)였습니다. 명사를 동사로 쓴 표현과 무생물 주어는 사람이 일일이 고르지 않고 Jev 1.13을 분류기로 써서 판정했습니다.
한국어로 쓴 AI 글에서도 같은 일이 일어나는지는 이 논문으로는 알 수 없습니다. 영어와 한국어는 문장 구조가 달라서, 압축 압력이 한국어에서는 다른 모습으로 나타날 수도 있습니다.
모델이 똑똑해질수록 사람에게 설명하는 능력이 저절로 따라오지는 않는다는 게 이 논문의 메시지입니다. 정답률 경쟁 다음에는 얼마나 잘 읽히는지도 모델을 고르는 기준이 될 것 같습니다.