Codex가 몇 달 작업을 한 번에 끝내면, FDE는 무엇을 할까?
송찬우 5분 분량

10월 22일(미국 시간) OpenAI가 ‘What FDE means at OpenAI’라는 글을 올렸습니다. 쓴 사람은 OpenAI의 FDE(Forward Deployed Engineer) 조직을 이끄는 Colin Jarvis예요. 글은 팀원 한 명이 그에게 던진 질문으로 시작합니다. “지난 몇 달 동안 우리가 만들어 온 활용 사례를 Codex가 단번에 구현할 수 있게 되면, 우리는 뭘 해야 하나요?”
FDE는 고객사에 들어가 AI를 실제 업무에 붙이는 개발자입니다. 지난 10월 14일 ‘AI가 개발자를 대체하기는커녕, 연봉 5억 주고 모셔갑니다’에서 소개했던, AI 회사들이 몇억씩 주고 모셔 가는 바로 그 직업입니다.
그런데 FDE가 하는 일의 상당 부분이 코드를 짜는 일이라면, 코딩 에이전트가 좋아질수록 FDE가 설 자리는 줄어들어야 맞습니다. OpenAI가 자기 FDE 팀의 실제 사례와 숫자를 공개하면서 이 질문에 직접 답했어요.
결론부터 말하면, 더 어려운 문제를 찾으러 갑니다.
답은 글의 마지막 문장에 있습니다. Codex가 몇 달 걸려 만든 기능을 처리하게 되면, 더 어려운 문제를 찾아 나서면 된다는 거예요. Jarvis는 두어 달마다 자기 팀의 개입이 더 이상 필요 없게 만들어야 FDE 팀이 제 역할을 하는 것이라고 썼습니다.
팀이 생긴 건 2025년 초입니다. Jarvis는 모델이 할 수 있어 보이는 것과 사람들이 실제 업무에서 안정적으로 쓸 수 있는 것 사이의 간극을 ‘도입 격차(deployment gap)’라고 부르고, 이걸 줄이려고 팀을 만들었다고 밝혔어요. 모델이 벤치마크에서는 잘해도 현실의 변수와 제약 속에서는 일을 못 하는 경우가 많다는 겁니다.
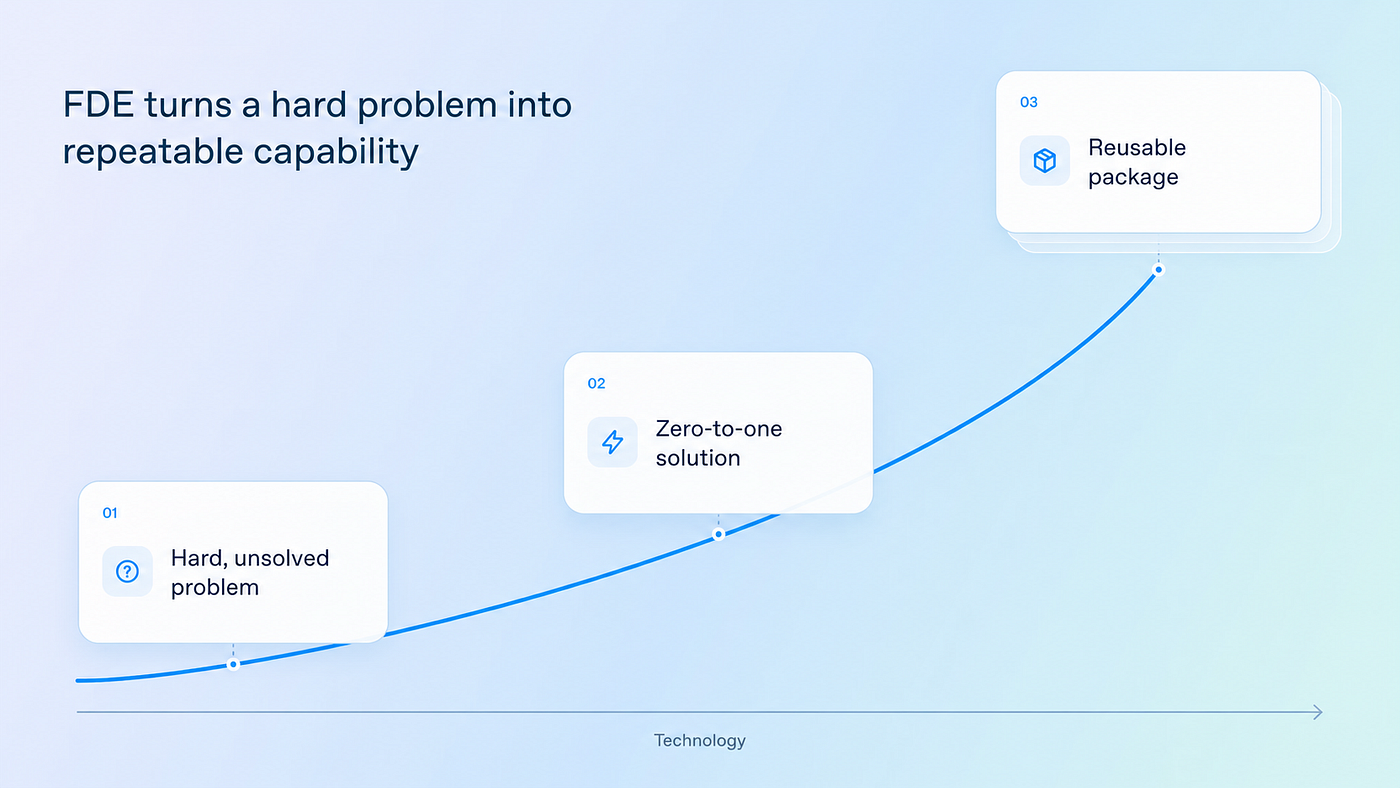
처음에는 고객마다 맞춤 코드를 짰습니다.
가장 자세히 소개한 건 대형 반도체 고객사 사례입니다. 2025년 중반, FDE 약 15명이 이 회사와 함께 활용 사례 10개 이상을 만들고 있었어요. 목표는 칩 검증 과정을 AI 중심으로 다시 짜는 것이었습니다. 반도체 업계에서는 검증에 프로젝트 전체 작업량의 약 70%가 들어가기도 한다고 해요.
투입된 FDE 중에는 OpenAI에 들어온 지 며칠 안 됐고 반도체 일을 해 본 적도 없는 사람도 있었습니다. 이들은 고객사 검증팀에 들어가 같이 일하면서 틈틈이 칩 설계를 공부했어요. 그리고 고객사 엔지니어들과 평가(eval)부터 설계해서, AI가 쓸 만한 테스트를 만들고 칩 결함을 제대로 짚는지 확인했습니다.
처음 3~6개월 사이에 모든 활용 사례가 실제 운영에 들어갔습니다. OpenAI가 밝힌 결과는 이렇습니다.
- AI로 지정 테스트(directed test)를 만드는 시간 약 48% 절감
- 커널 최적화 성능 개선율 중앙값 22%
- 몇 주 걸리던 디버깅을 몇 시간으로 단축
결과를 본 고객사의 최고 하드웨어 책임자는 “여기 오기 전에도 칩 설계자로 일하셨나요?”라고 물었다고 합니다. Jarvis는 FDE가 처음부터 그 업계를 알 필요는 없지만, 배우는 건 본인 책임이라고 적었어요. 코딩 어시스턴트 덕분에 소프트웨어는 더 빨리 만들 수 있게 됐으니, 그만큼 고객사의 사업을 이해하는 일이 더 중요해졌다는 겁니다.
맞춤 코드의 약 90%를 걷어 냈습니다.
문제는 그다음이었습니다. 효과는 증명했는데, 다른 팀으로 넓히려면 활용 사례마다 맞춤 통합 작업이 너무 많이 필요했어요. 사례마다 따로 만든 하네스(모델에 도구를 붙이고 실행을 관리하는 코드)와 터미널 UI, CLI가 있었으니까요.
그 사이 Codex가 좋아졌습니다. FDE 한 명이 Codex를 중심으로 애플리케이션을 다시 만들어 보는 실험을 했고, 팀은 활용 사례들을 Codex 기반 공통 하네스로 옮겼습니다. 맞춤 애플리케이션은 Codex 위에서 도는 플러그인과 스킬이 됐고, Codex가 인터페이스까지 맡으면서 따로 만든 터미널 UI와 CLI도 필요 없어졌어요.
그 결과 프로젝트마다 맞춤 코드의 약 90%를 없앴습니다. Codex가 좋아지면 모든 활용 사례가 같이 좋아지니, 사례마다 붙여야 하는 연결 코드도 줄었고요. 핵심 기능은 스킬과 플러그인으로 묶어 고객사의 AI CoE(사내 AI 전담 조직)가 한곳에서 관리하게 했습니다.
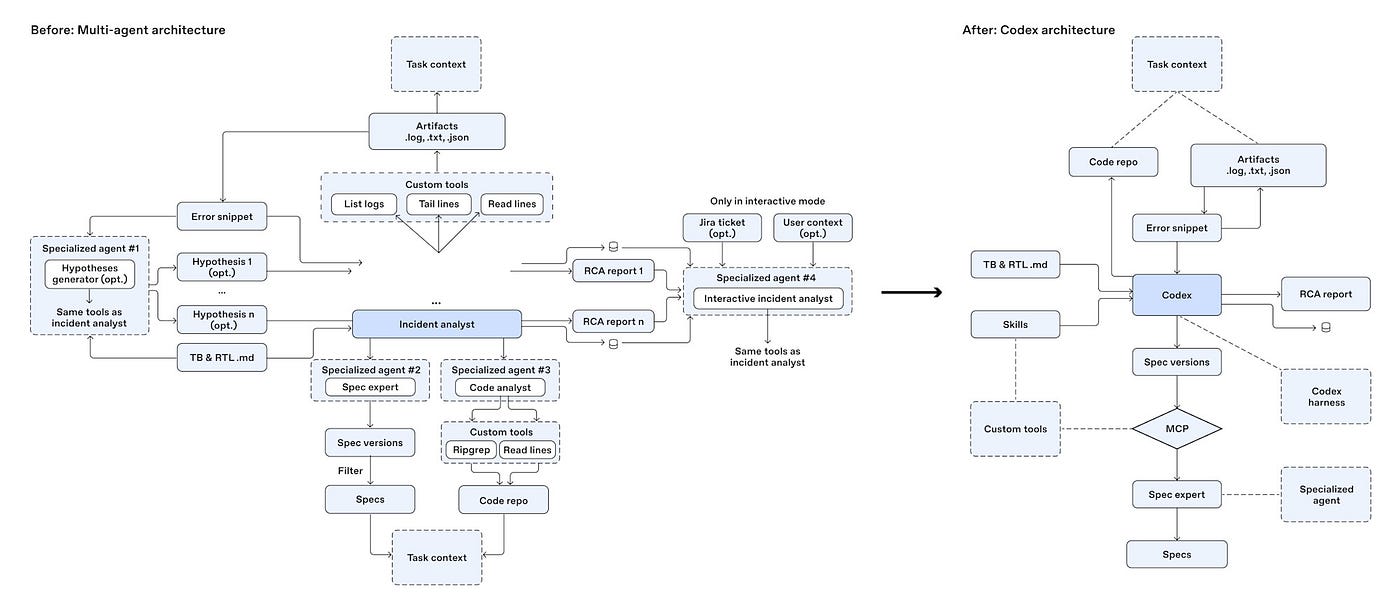
다른 팀으로 넓히는 일도 단순해졌습니다. 커넥터나 MCP 서버를 그 팀 것으로 바꾸고, 새 평가를 만든 뒤 바로 운영을 시작하면 됩니다. 평가를 만드는 스킬까지 따로 있었다고 해요. 2026년 8월의 한 사례에서는 첫 도입에 두 달이 걸렸는데, 두 번째 팀으로 넓히는 데는 하루가 걸렸습니다.
Jarvis가 강조한 건 순서입니다. LLM 덕분에 빨리 만들 수 있으니, 그 속도로 먼저 쓸모 있는 걸 내놓고, 실제로 뭐가 통하는지 배운 다음, 효과가 확인된 것만 넓혀야 한다는 거예요. 맞춤 코드를 직접 짜 보면서 무엇이 중요한지 알게 됐고, 그걸 알고 나니 기반 제품이 좋아졌을 때 맞춤 구현 대부분을 제품으로 바꿔도 가치가 그대로 남았다는 얘기입니다.
같은 방식으로 제품도 만들었습니다.
다른 사례도 흐름이 같습니다. 기업용 음성/채팅 에이전트 제품인 OpenAI Presence는 실제 고객 배포 현장에서 자랐습니다. Swarm으로 시작해 Agents API를 거쳤고, 지금 한 고객은 통화의 절반 이상을 AI로 처리하고 있어요. 여러 고객사에 배포하면서 다른 팀도 쓸 수 있는 부분을 Presence에 넣었습니다.
Thrive Holdings와는 회계 법인용 Tax AI를 만들었습니다. 파일럿 기간에 세금 신고서 7,000건을 처리했고 처리량이 약 50% 늘었어요. 가장 어려운 건 임대 부동산 신고서였는데, 정밀도와 재현율 90%에 이르기까지 엔지니어링과 실무자 검토에 6주가 걸렸습니다. 여기서 만든 패턴으로 다른 복잡한 세금 서류에도 넓히고 있다고 합니다.
모델이 못 하는 일은 리서치팀으로 넘깁니다.
FDE 팀이 하는 일이 하나 더 있습니다. 모델 자체가 아직 못 하는 일을 찾아내는 겁니다. Jarvis는 지금 모델로 되는 것만 만들면 리서치팀이 다음에 메워야 할 빈칸을 찾을 수 없다고 썼어요.
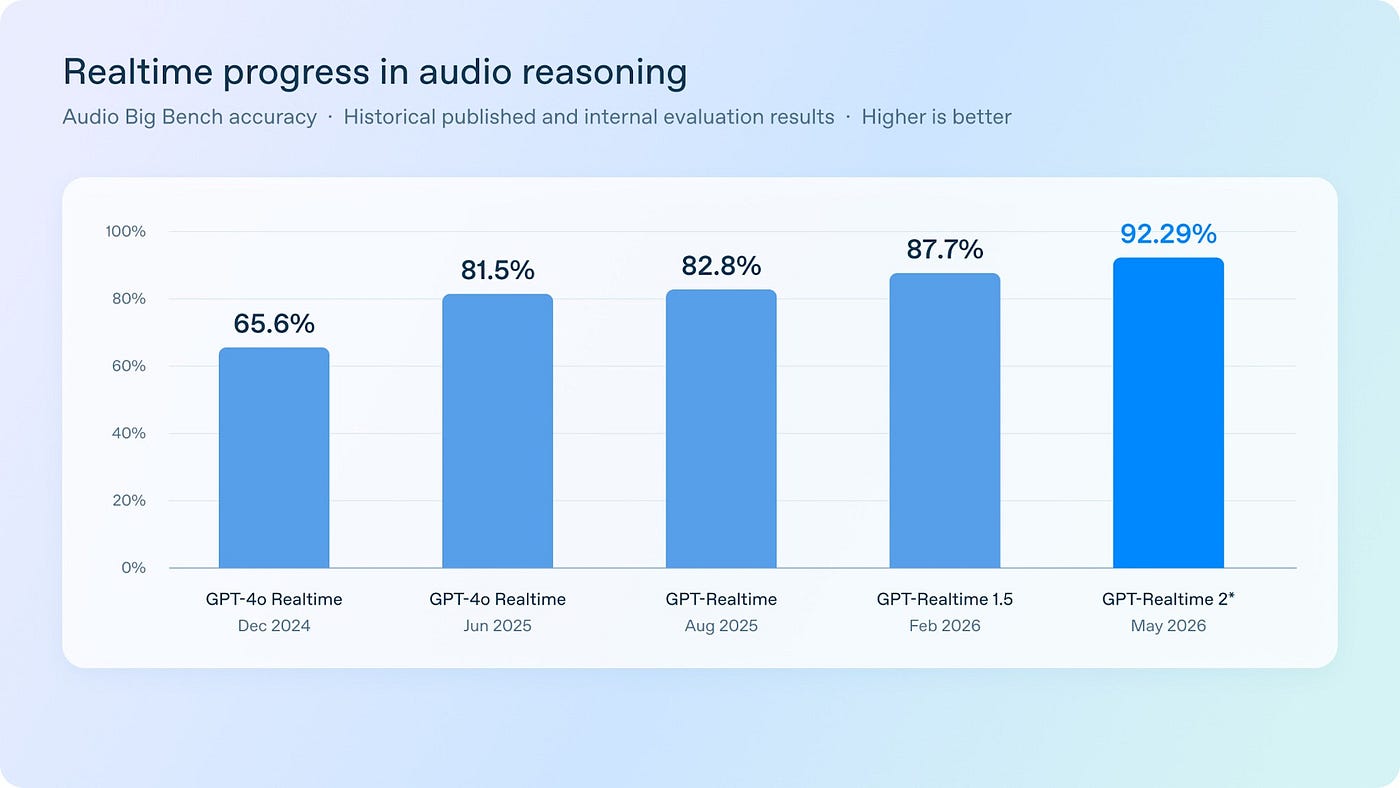
예로 든 건 대형 통신사입니다. OpenAI는 이 회사와 고객 상담 플랫폼을 이미 만들었고, 고객사는 이걸 음성으로 넓히고 싶어 했습니다. 음성 상담이 전체 고객 상담 업무의 약 90%였거든요. 그런데 실제 서비스에서 일을 해낼 수 있는지 보는 핵심 평가에서 모델 점수는 약 60%였습니다. 고객 상담 상황의 함수 호출과 지시 이행 능력이 모자랐어요.
FDE는 이 사실을 고객사에 그대로 설명하고 리서치팀을 프로젝트에 불렀습니다. FDE는 고객사와 플랫폼을 만들고 모델이 해야 할 일을 정의했고, 리서치팀은 부족한 능력을 채웠습니다. 새 모델 스냅샷이 나올 때마다 고객사의 기준으로 얼마나 나아졌는지 확인했고요. 6개월 동안 핵심 평가 점수는 약 60%에서 80%, 다시 90% 이상으로 올라 실제 서비스 수준에 이르렀습니다. 이렇게 나온 음성 모델은 지금 다른 고객사의 상담 서비스와 Presence에서도 쓰입니다.
결국 FDE가 남기는 건 평가와 판단입니다.
글 전체에서 반복되는 말이 평가입니다. 반도체 고객사에서는 고객사 엔지니어와 평가부터 설계했고, 다른 팀으로 넓힐 때도 새 평가를 만드는 게 핵심 단계였습니다. 통신사 사례에서는 평가 점수가 60%라는 걸 보고 리서치팀을 불렀고요. 코드는 Codex가 점점 더 많이 짜지만, 무엇이 성공인지 정하고 그걸 재는 기준은 고객사의 일을 아는 사람이 만들어야 합니다.
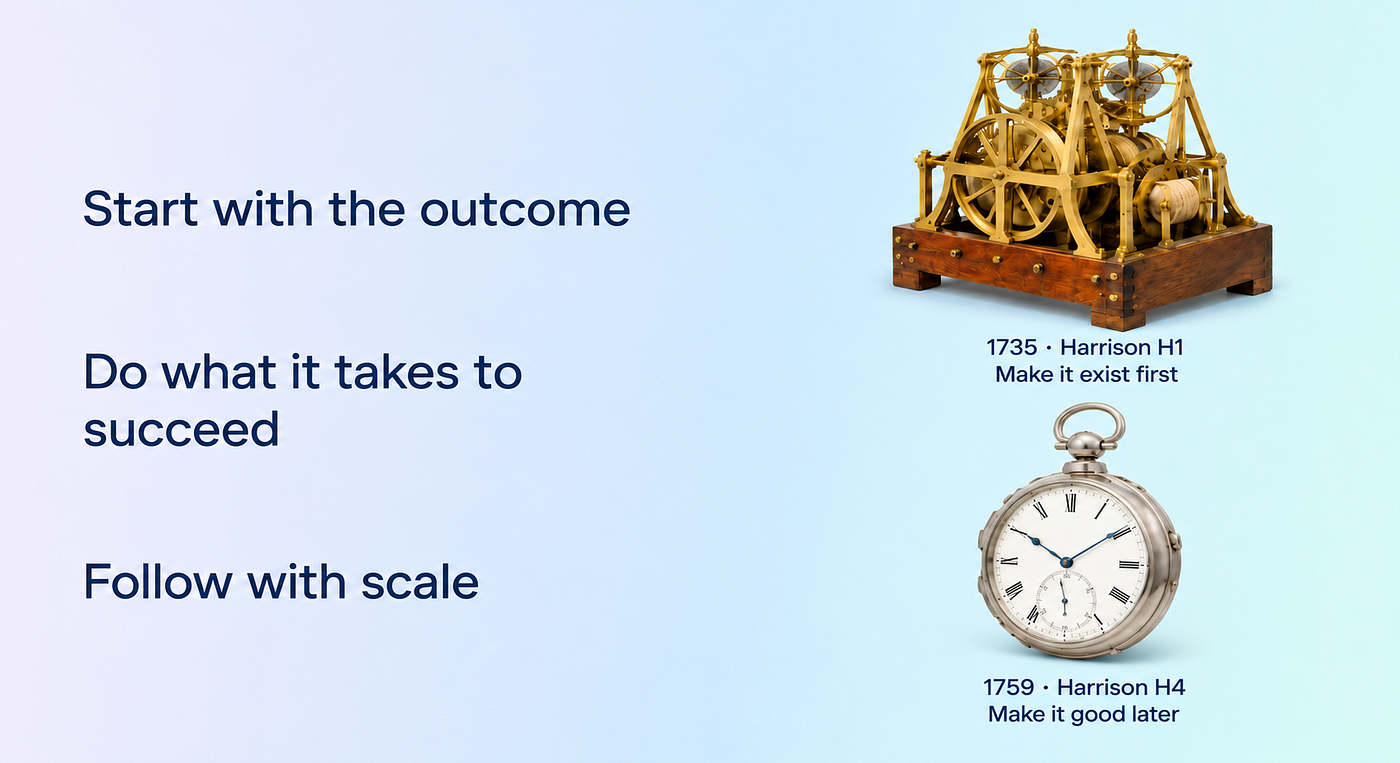
Jarvis가 FDE 팀 세션을 시작할 때마다 띄운다는 슬라이드 문구도 같은 얘기입니다. “원하는 성과에서 출발하고, 성공에 필요한 일을 한 뒤, 규모를 확장한다.” 인상적인 데모는 실제 환경에서도 되느냐는 질문을 받기 전까지만 호응을 얻는다는 말도 덧붙였어요.
한국 상황에 대입해 보면 더 선명합니다. 국내에서는 고객사마다 맞춤 개발을 해 주는 SI 방식이 익숙하고, FDE라는 이름도 그 위에 붙는 경우가 많습니다. OpenAI 사례는 반대 방향을 보여 줍니다. 맞춤 코드는 문제를 배우는 단계에서 쓰고, 배운 건 스킬과 플러그인으로 묶어 다음 팀이 하루 만에 가져다 쓰게 만드는 거예요. 맞춤 코드를 쌓아 두는 게 아니라 걷어 내는 게 목표인 셈입니다.
다만 OpenAI가 고른 사례입니다.
이 글은 OpenAI가 자기 팀을 소개하면서 사람을 뽑으려고 쓴 글이기도 합니다. 끝에 팀에 합류해 달라는 문장이 붙어 있어요. 반도체 고객사와 통신사 이름은 밝히지 않았고, 48%, 22%, 90% 같은 숫자를 어떻게 쟀는지도 나와 있지 않습니다. 첫 도입 두 달, 두 번째 팀 하루라는 숫자도 2026년 8월의 한 사례 이야기예요. 모든 고객사에서 이렇게 된다는 뜻으로 읽기는 어렵습니다.
그래도 방향은 분명합니다. Codex가 몇 달 작업을 한 번에 해내는 시대에 OpenAI가 내놓은 답은 FDE를 줄이는 게 아니라 FDE가 서는 자리를 계속 옮기는 것이었습니다. 한때 맞춤 코드로 풀던 문제는 제품의 기본 기능이 되고, FDE는 아직 모델이 못 하는 다음 문제로 갑니다. 코드를 짜는 속도보다 고객의 일을 이해하고 무엇이 성공인지 정하는 능력이 FDE의 몸값을 정하게 될 것 같습니다.