Qwen3.8-27B를 여러 번 부르면 정말 Claude Fable 5만큼 코딩할까?
송찬우 5분 분량

10월 25일(한국 시간) 해커뉴스 첫 화면에 “Qwen3.8-27B 다섯 개가 GVS5H 하네스로 Claude Fable 5만큼 코딩한다”는 글이 올라왔습니다. 158점에 댓글 55개가 달렸고, 같은 날 GeekNews에도 소개됐어요. X에서는 “Fable 5 값의 5분의 1”, “GPU 한 장이면 된다”는 요약이 중국어권을 중심으로 빠르게 퍼졌습니다.
캐나다 토론토의 Persis Capital 연구진을 중심으로 7명이 깃허브에 논문과 코드, 실행 기록까지 모두 공개한 프로젝트입니다. 오픈 웨이트 27B 모델이 정말 최상위 유료 모델만큼 코딩한다면 회사 안에서 모델을 직접 돌릴 이유가 하나 더 생기는 셈인데요. 논문의 표를 하나씩 따라가 보면 퍼진 요약과 다른 부분이 꽤 있습니다.
결론부터 말하면, 점수는 비슷하고 값은 모델마다 다릅니다.
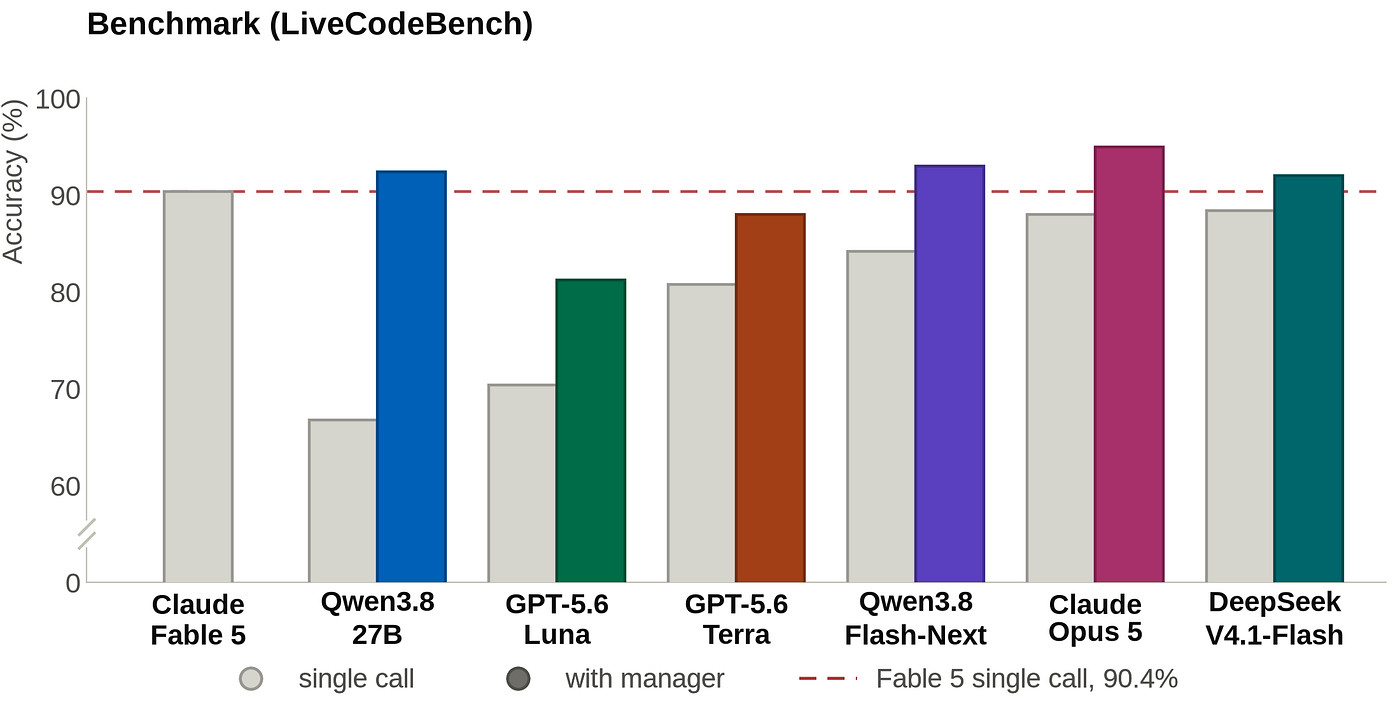
논문은 LiveCodeBench의 가장 최근 고난도 문제 100개를 다섯 번씩 풀게 했습니다. Claude Fable 5는 한 번에 답하는 방식으로 90.4%를 받았어요. Qwen3.8-27B는 혼자 풀면 66.8%였는데, GVS5H 방식을 씌우자 92.4%까지 올라갔습니다. 25.6점이 오른 겁니다.
다만 92.4 대 90.4는 이겼다고 말하기 어려운 차이입니다. 논문이 직접 계산한 통계 검정에서 Fable 5와의 차이는 p=0.88로 의미가 없었어요. 그래서 논문도 “넘었다”가 아니라 “비슷한 수준에 도달했다”고 씁니다.
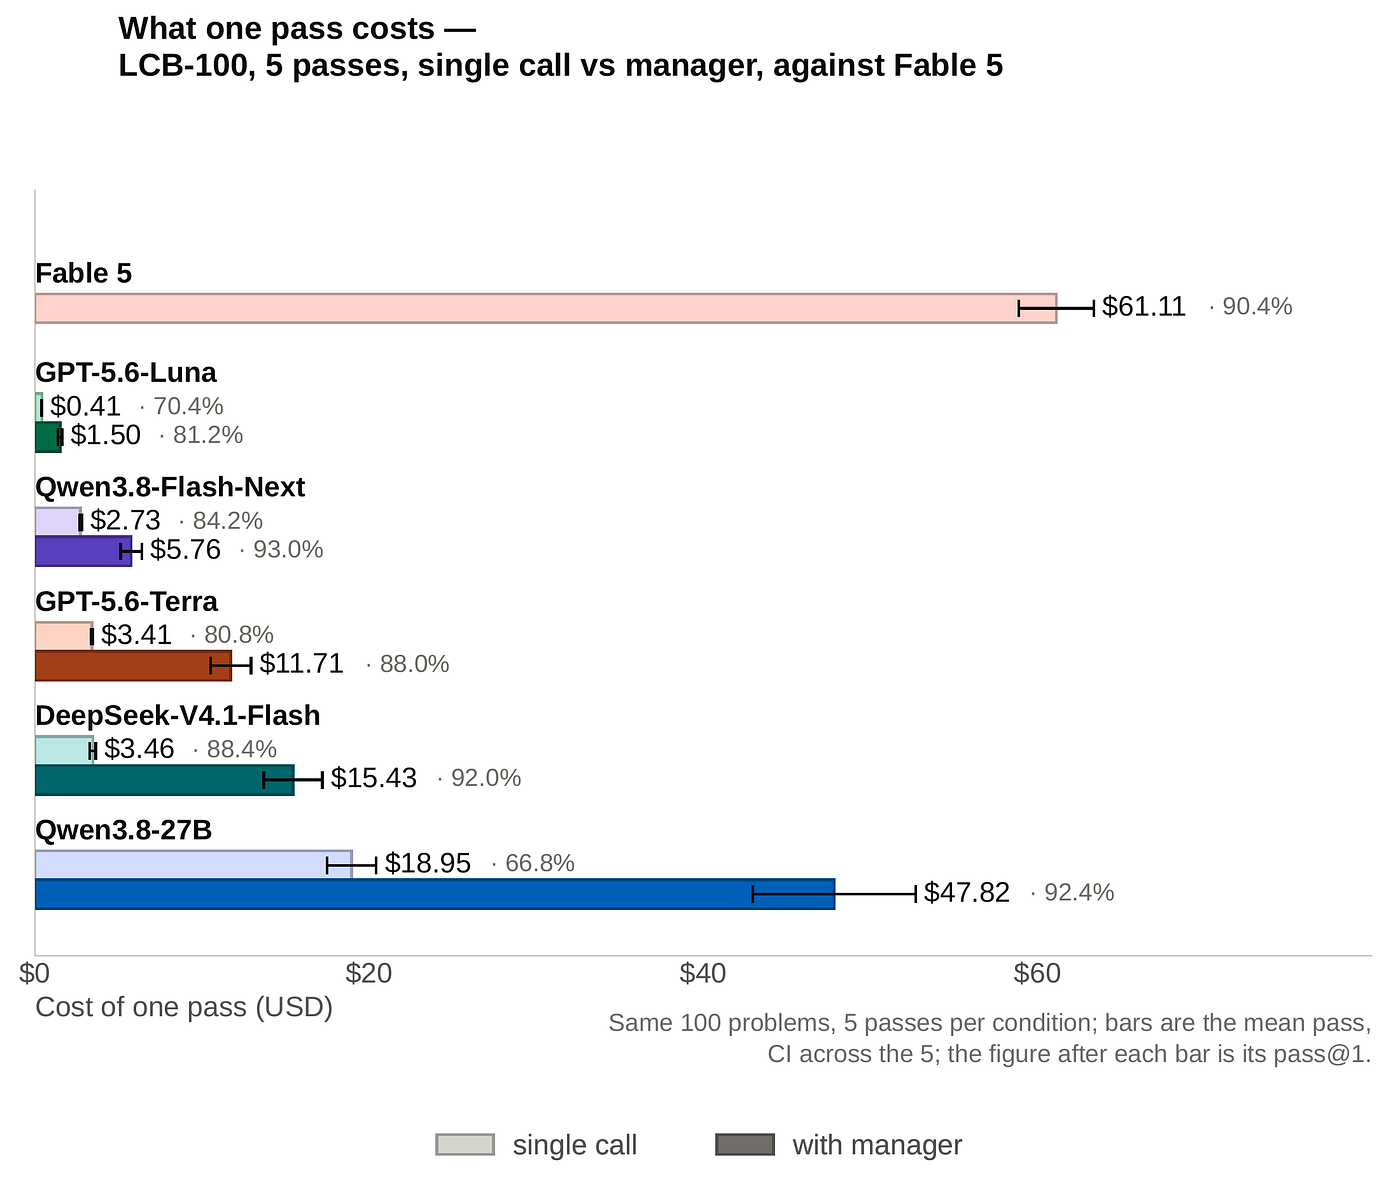
값도 따로 봐야 합니다. “5분의 1 값”은 27B가 아니라 함께 실험한 Qwen3.8-Flash-Next 이야기입니다. 문제 100개를 한 번 푸는 데 Fable 5는 61.11달러(약 8만 1천 원)가 들었고, GVS5H를 씌운 Flash-Next는 5.76달러(약 7,600원)로 93.0%를 받았어요. 9% 값으로 같은 수준에 온 겁니다.
반면 Qwen3.8-27B는 같은 100문제에 47.82달러(약 6만 3천 원)가 들었습니다. Fable 5의 약 78%입니다. 27B는 문제 하나에 생각을 아주 길게 하는 모델이라, 한 번 풀 때 내놓는 토큰이 OpenAI 모델보다 20배 넘게 많았기 때문이에요. 값이 싼 모델이라도 말이 길면 청구서는 커집니다.
모델 다섯 개를 동시에 띄운 게 아닙니다.
GVS5H는 Gorilla vs. 5 Humans의 줄임말입니다. 어깨를 밟고 선 아이 다섯이 고릴라 한 마리만큼 키가 크다는 그림에서 온 이름이에요. 그런데 실제 방식은 27B 모델 다섯 개를 나란히 띄우는 게 아닙니다. 같은 모델 하나를 여러 번, 매번 빈 대화로 새로 부릅니다.
한 번은 매니저 역할을 맡깁니다. 매니저는 문제를 읽고 3~6문장짜리 계획과 할 일 목록을 씁니다. 다음 호출에서는 워커가 그 목록에서 한 가지 일만 받아 처리해요. 이 과정이 최대 10번 반복됩니다. 호출끼리는 대화를 주고받지 않고, 디스크에 있는 파일 다섯 개로만 상태를 넘깁니다.
- task.md: 문제
- plan.md: 매니저의 계획
- tasks.json: 할 일 목록
- notes.md: 지금까지 알아낸 것과 실패한 시도
- solution.py: 현재 풀이
워커가 새 풀이를 내면 프로그램이 문제에 딸린 예제 입력으로 직접 돌려 보고, 결과를 매니저에게 돌려줍니다. 예제에서 틀리면 매니저가 “다 됐다”고 해도 다시 돌아가요. plan.md는 4,000자, notes.md는 8,000자를 넘지 못하게 잘라서 파일이 끝없이 길어지지 않게 했습니다. 따로 학습시킨 것도, 문제별 예시를 준 것도 없습니다.
점수를 올린 건 파일에 적어 두는 습관이었습니다.
연구진은 혼자 풀 때는 틀리고 GVS5H에서는 맞힌 기록을 모델마다 하나씩 뜯어봤습니다. 공통점은 세 가지였어요. 코드를 쓰기 전에 풀이의 핵심 아이디어를 먼저 파일에 적어 두니 다음 호출이 그걸 다시 생각하지 않고 이어받았습니다. 얽힌 목표를 나눠 따로 구현했고, 호출 하나하나가 짧으니 출력 한도에 걸려 잘리는 일이 줄었습니다.
마지막 이유가 생각보다 큽니다. Qwen3.8-27B에게 한 번에 25만 토큰까지 쓰게 했더니, 8번은 생각만 하다 한도를 다 쓰고 코드를 하나도 내놓지 못했어요. 한 문제에서는 같은 문장을 7,743번 되풀이했습니다. 잘린 답 대부분은 앞부분에 이미 완성된 풀이가 있었는데, 그걸 다시 검토하다가 한도를 넘긴 겁니다.
한 대화가 길어질수록 모델이 흔들리니, 중요한 건 파일에 남기고 새 대화로 다시 시작하는 방식입니다. 지난 9월 ‘AI는 왜 오래 일하면 바보가 될까?’에서 소개했던, 긴 작업을 짧게 끊고 기록으로 잇는 바로 그 방식입니다.
모든 모델이 좋아지지는 않았습니다.
효과는 모델이 작을수록, 스스로 생각을 정리하지 못할수록 컸습니다. 이미 잘하는 모델은 조금만 올랐어요. DeepSeek V4.1 Flash는 88.4%에서 92.0%로 3.6점, GPT-5.6 Terra는 80.8%에서 88.0%로 7.2점 올랐습니다.
오히려 떨어진 경우도 있습니다. 생각 기능을 끈 Qwen3.6-35B는 27%로 8점 내려갔어요. 한 문제에서는 처음 아이디어 단계에서 혼자 풀 때와 같은 최적화를 떠올렸다가 “실수하기 쉽다”며 스스로 버리고, 더 느린 방법을 골랐습니다. 짧고 맞는 코드를 나누어 풀다가 망친 겁니다. Kimi K3는 생각 기능을 켰을 때 86%에서 86%로 그대로였습니다.
Claude Opus 5는 88%에서 95%로 오르며 전체 실험에서 가장 높은 점수를 냈어요. 다만 이 결과는 초기 버전 방식으로 OpenRouter를 거쳐 한 번만 돌린 결과라, 다섯 번 돌린 본 실험과 나란히 놓고 비교할 수는 없습니다.
채점기 버그도 함께 찾아냈습니다.
논문에서 의외로 쓸모 있는 부분은 부록입니다. 연구진은 기록을 들여다보다 LiveCodeBench 채점기에서 버그 두 개를 찾았어요. 첫째, 파이썬에서 sys.stdin.buffer.readline()으로 입력을 읽으면 채점기가 매번 첫 줄만 돌려줬습니다. 풀이가 맞아도 틀린 것으로 채점된 겁니다. 둘째, 정답이 여러 개인 문제 4개를 정답 하나와 글자 그대로 맞는지만 비교했습니다.
첫 번째 버그는 모델의 코딩 습관에 따라 피해가 갈렸습니다. 이 방식으로 입력을 읽은 풀이 371개 중 86%가 틀린 것으로 채점됐는데, 나머지 풀이는 18%만 틀렸어요. Fable 5는 이 방식을 한 번도 쓰지 않아 점수가 그대로였고, GPT-5.6 Terra의 GVS5H 점수는 버그를 고치자 12.6점 올랐습니다. 공개 순위표의 차이 일부가 실력이 아니라 입력을 읽는 습관에서 나왔을 수 있다는 뜻입니다.
한계도 분명합니다.
해커뉴스 댓글에서 가장 많이 나온 지적은 비교 대상입니다. 기준이 된 Fable 5는 값이 비싸서 혼자 푸는 방식으로만 돌렸어요. Fable 5에 같은 방식을 씌우면 얼마나 오를지는 모릅니다. Fable 5.1, Opus 5.5, GPT-6 계열과의 비교도 없습니다.
벤치마크도 하나뿐입니다. LiveCodeBench는 정해진 입력에 정답을 출력하는 알고리즘 문제라, 큰 코드베이스를 고치는 실제 개발 작업과는 거리가 있어요. 수학과 지식 벤치마크는 점수가 이미 거의 만점이라 뺐다고 논문에 적혀 있습니다. 토큰을 평균 3배 쓰는 만큼 시간도 더 걸리는데, 걸린 시간은 따로 비교하지 않았습니다.
Qwen3.8-27B를 직접 돌리려면 이 정도가 필요합니다.
원본 가중치는 BF16으로 약 55.6GB입니다. 연구진은 공식 FP8 버전(약 30.9GB)을 직접 띄운 vLLM 서버로 돌렸어요. 이 정도면 48GB 메모리의 NVIDIA L40S 한 장에 들어갑니다. AWS에서 L40S 한 장짜리 g6e.xlarge는 미국 동부 기준 시간당 약 1.86달러(약 2,500원), 한 달 내내 켜 두면 약 1,340달러(약 177만 원)입니다.
더 줄이면 4비트 양자화 파일이 약 16~18GB라 24GB 그래픽카드 한 장에도 올라갑니다. 해커뉴스에는 4비트 파일을 llama.cpp로 13만 토큰 문맥에 띄워 쓰고 있다는 후기도 있었어요. 다만 논문의 92.4%는 FP8로 낸 점수라, 4비트에서도 같은 점수가 나올지는 확인되지 않았습니다.
시간은 따로 따져야 합니다. 27B가 GVS5H로 100문제를 한 번 푸는 동안 출력한 토큰은 약 1,863만 개였습니다. 초당 100토큰으로 계산해도 50시간이 넘어요. 집에 있는 GPU 한 장으로 같은 실험을 그대로 재현하기는 어렵고, 여러 요청을 한꺼번에 처리하는 서버가 있어야 현실적인 속도가 나옵니다.
모델을 바꾸기 전에 일하는 방식을 먼저 바꿀 수 있습니다.
GVS5H가 보여 준 건 27B가 Fable 5보다 똑똑하다는 게 아닙니다. 같은 모델이라도 계획을 파일에 적고, 일을 한 가지씩 맡기고, 결과를 실제로 돌려 확인하게 하면 점수가 크게 달라진다는 겁니다. 회사에서 에이전트를 만들 때도 더 비싼 모델로 바꾸기 전에, 작업을 나누고 기록을 남기는 구조부터 손보는 쪽이 값싸게 먹힐 것 같습니다.