피부암 진단, 왜 GPT-6 Astra보다 10년 된 CNN이 더 정확했을까?
송찬우 5분 분량

10월 25일(영국 시간) 영국 가이스 병원의 피부과 전문의 Magnus Lynch가 GPT-6 Astra와 Claude Fable 5.1에게 피부 병변 200개의 사진을 보여 주고 진단을 맡긴 결과를 공개했습니다. 비교 상대는 구글이 2015년에 발표한 이미지 인식 모델 Inception v3였어요. 200개 중 Inception v3는 62%를 맞혔고, 두 LLM은 나란히 42%였습니다. 해커뉴스에서는 387점에 댓글 184개가 달렸습니다.
GPT-6 Astra와 Claude Fable 5.1은 지금 쓸 수 있는 모델 중 가장 비싼 축에 듭니다. 그런데 사진을 보고 병을 고르는 일에서는 H100 한 장으로 20분쯤 다시 학습시킨 10년 전 모델에 졌습니다. 시험이 어떻게 진행됐고, 회사에서 AI를 붙일 때 이 결과를 어떻게 읽어야 하는지 정리해 봤습니다.
결론부터 말하면, 전용 모델이 20%포인트 더 맞혔습니다.
시험 데이터는 국제 피부 영상 협력체(ISIC)가 2025년에 공개한 MILK10k입니다. 병변 하나마다 일반 근접 사진과 더모스코피(피부과에서 쓰는 조명 달린 확대경) 사진이 한 장씩 있어요. Lynch는 여기서 조직검사로 확진된 병변 200개를 무작위로 뽑았습니다. 절반은 치료가 필요한 병변(흑색종 30, 기저세포암 25, 편평세포암 25, 광선각화증 20)이고, 나머지 절반은 그냥 둬도 되는 병변(점 50, 지루각화증 50)입니다.
모두 조직검사까지 한 병변이라 쉬운 문제는 아닙니다. 양성인 점이라도 의사가 한 번은 걱정해서 떼어 냈다는 뜻이니까요.
두 LLM에게는 사진 두 장만 주고, 여섯 가지 진단 중 가장 가능성 높은 것과 확신도, 두 번째 후보, 그리고 치료나 추적 없이 돌려보내도 되는지를 JSON으로 답하게 했습니다. 기본 설정으로 사례마다 한 번씩 물었고, 답을 거절한 경우는 없었어요.
Inception v3는 일상 사진으로 미리 학습된 모델을 ISIC 아카이브의 피부 사진 68,011장으로 다시 학습시킨 것입니다. 시험에 쓴 200개 병변과, 같은 병변이나 같은 환자의 다른 사진은 모두 학습 데이터에서 뺐습니다.
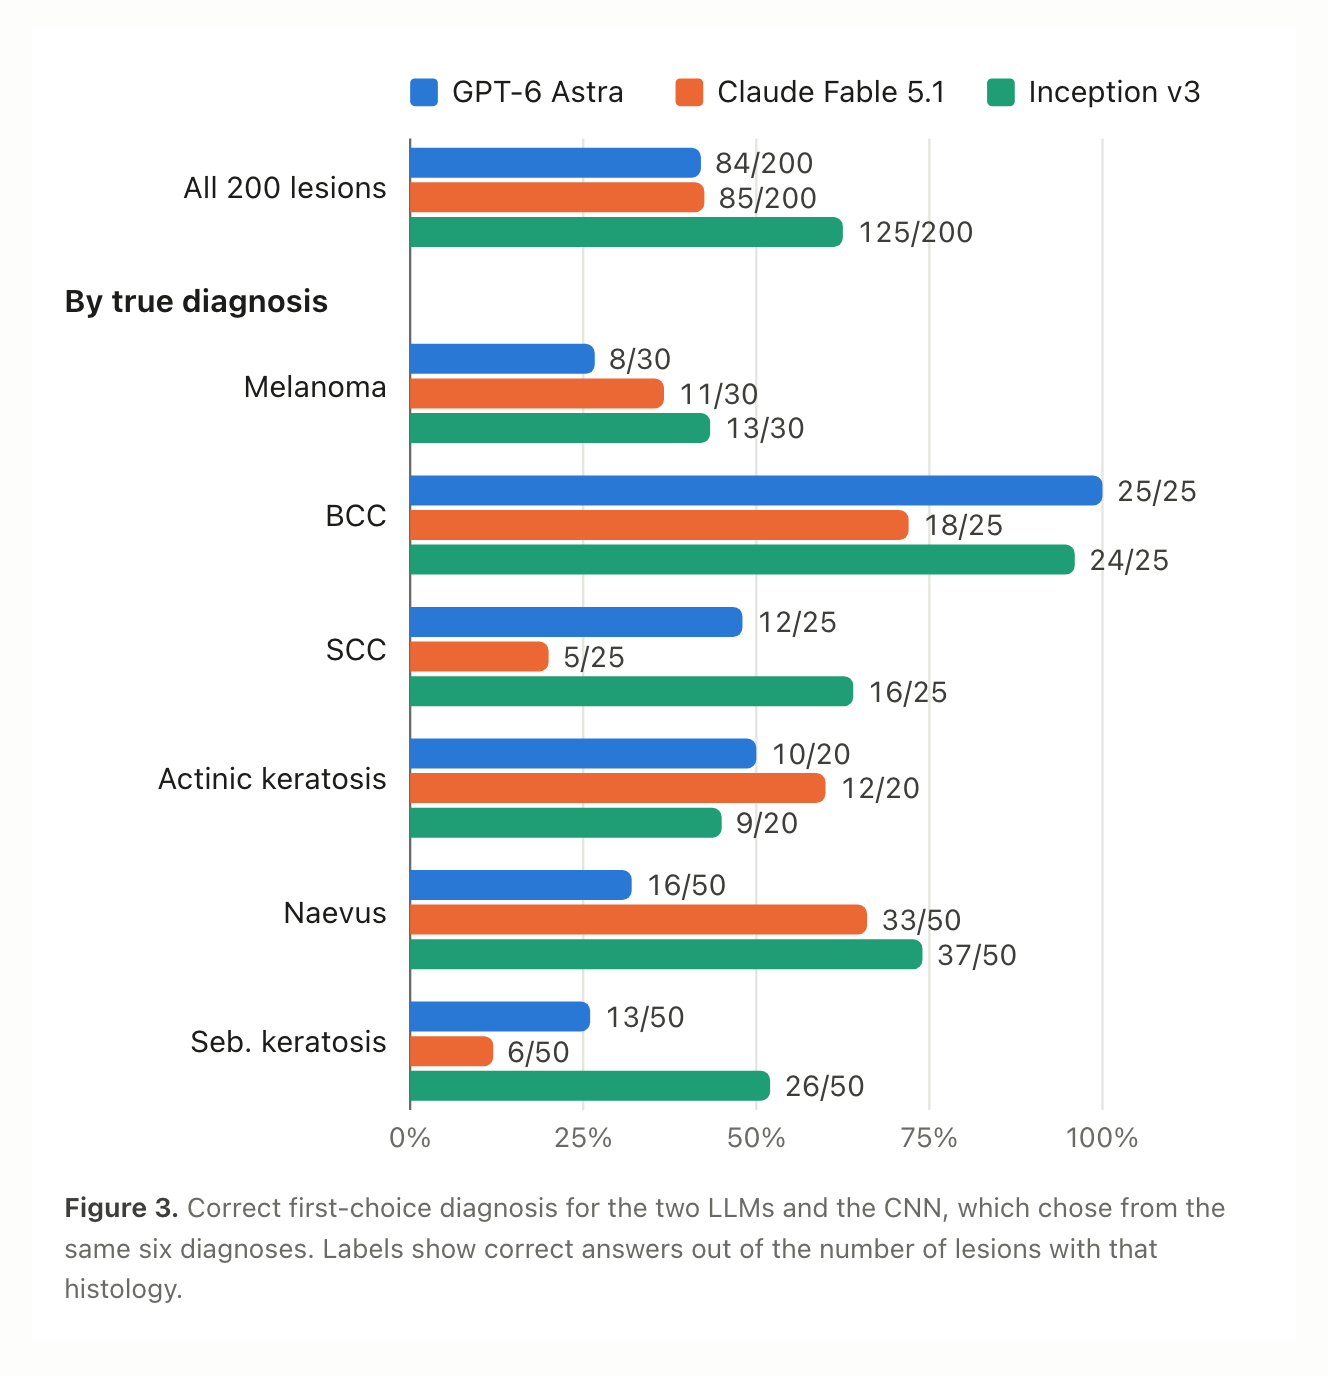
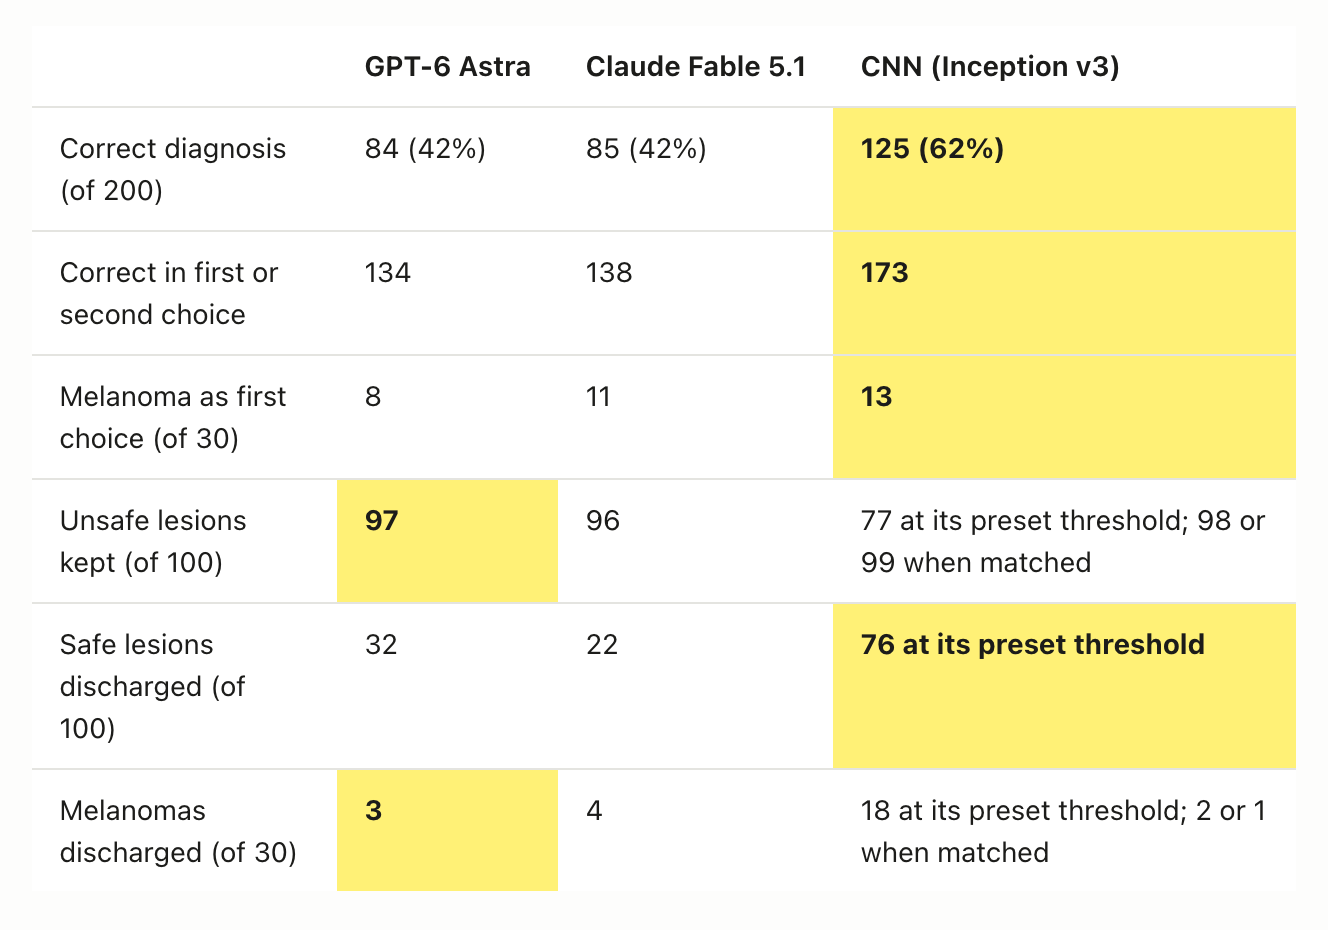
정답은 Inception v3가 200개 중 125개, GPT-6 Astra가 84개, Claude Fable 5.1이 85개였습니다. 두 번째 후보까지 치면 173개 대 134개, 138개로 차이가 더 벌어집니다. Lynch가 공개한 원본 응답 파일로 다시 세어 봐도 숫자는 같았어요.
차이는 양성 병변에서 가장 컸습니다.
흑색종 30개 중 정답은 Inception v3 13개, Claude Fable 5.1 11개, GPT-6 Astra 8개로 셋 다 절반을 넘기지 못했습니다. 가장 크게 벌어진 건 오히려 그냥 둬도 되는 병변입니다. 점 50개 중 Inception v3는 37개를 맞혔고 GPT-6 Astra는 16개였어요. 지루각화증 50개에서는 Inception v3 26개, GPT-6 Astra 13개, Claude Fable 5.1 6개였습니다.
LLM은 틀리는 방식에 버릇이 있었습니다. GPT-6 Astra는 200개 중 75개를 기저세포암이라고 답했는데, 실제 기저세포암은 25개였어요. 흑색종 30개 중 14개도 기저세포암이라고 했습니다. 기저세포암 25개를 모두 맞힌 것도 이 버릇 덕분입니다. Claude Fable 5.1은 53개를 광선각화증이라고 답했고, 실제로는 20개였습니다.
돌려보내도 되는지 물으면 LLM은 거의 다 붙잡았습니다.
치료가 필요한 병변 100개 중 돌려보내지 않은 수는 GPT-6 Astra 97개, Claude Fable 5.1 96개, Inception v3 77개였습니다. 여기까지는 LLM이 낫습니다. 그런데 안전한 병변 100개 중 돌려보낸 수는 32개, 22개, 76개였어요. LLM은 웬만하면 다시 보자고 답해서 위험한 병변을 덜 놓치지만, 그만큼 괜찮은 환자도 병원에 붙잡아 두는 셈입니다.
Inception v3는 기본 기준에서 흑색종 18개를 돌려보내도 된다고 판단했습니다. 다만 LLM만큼 붙잡도록 기준을 맞추면 1~2개로 줄었다고 Lynch는 적었어요. 전용 모델은 이 기준을 병원이 직접 정할 수 있습니다.
환자처럼 물었을 때도 마찬가지였습니다. 근접 사진 한 장만 주고 의사에게 가야 하느냐고 묻자, 두 LLM은 양성 병변까지 포함해 거의 모든 경우에 병원에 가라고 답했습니다. 따로 뽑은 흑색종 100개에서는 GPT-6 Astra가 99개, Claude Fable 5.1이 98개에 진료를 권했어요. 환자에게 위험한 답은 드물었지만, 진단 도구로 쓰기에는 변별력이 없는 답입니다.
범용 모델은 이 일을 따로 배운 적이 없습니다.
Inception v3는 피부 사진 6만 8천 장으로 여섯 가지를 가르는 일만 배웠습니다. 반면 GPT-6 Astra와 Claude Fable 5.1에게 피부 병변 사진은 학습 데이터의 아주 작은 조각이에요. 해커뉴스에는 매개변수 3천만 개짜리 바둑 AI KataGo가 사람을 이기는데, 그보다 1만 배 넘게 큰 LLM은 바둑을 잘 두지 못한다는 댓글이 있었습니다. LLM이 잘하는 일은 학습 데이터에 많이 나왔고 강화학습으로 따로 훈련받은 일, 예를 들어 코딩이라는 지적도 나왔어요.
가장 많은 답글(33개)이 달린 댓글은 방향을 바꿔 봤습니다. LLM 덕분에 전용 분류 모델을 만드는 비용이 거의 0이 됐으니, LLM으로 그 일에 맞는 모델을 만들면 된다는 겁니다. 실제로 Lynch도 분석과 첫 원고를 Claude Code로 만들었다고 밝혔어요. 지난번 ‘Cloudflare Clairic은 정말 LLM보다 영수증과 메일을 잘 읽을까?’에서 소개했던, 정해진 일은 작은 전용 모델이 더 정확하고 싸다는 이야기와 같은 흐름입니다.
값과 속도, 개인정보에서도 전용 모델이 유리합니다.
공개된 응답 기록을 보면 Claude Fable 5.1은 병변 하나에 약 0.018달러(약 24원), 평균 6.6초가 걸렸습니다. GPT-6 Astra는 평균 5.2초였어요. 200개를 다 돌려도 Claude Fable 5.1 기준 약 3.5달러(약 4,700원)라 값이 큰 문제는 아닙니다.
더 큰 차이는 사진이 어디로 가느냐입니다. Inception v3는 휴대폰 브라우저 안에서 WebGPU로 돌아가고, 사진을 서버로 보내지 않습니다. 병원 입장에서는 환자 사진이 밖으로 나가지 않는다는 점이 정확도만큼 중요할 수 있어요.
다만 시험은 작습니다.
Lynch도 한계를 분명히 적었습니다. 200개는 경향을 보기엔 충분하지만 비슷한 결과를 줄 세우기엔 작고, 흑색종 30개로는 오차가 큽니다. LLM에는 사례마다 한 번씩만 물었는데, 같은 질문도 돌릴 때마다 답이 달라질 수 있어요. MILK10k는 2025년부터 공개된 데이터라 LLM이 학습 중에 봤을 수도 있는데, 그랬다면 오히려 LLM에 유리했을 겁니다.
Inception v3도 최신 피부암 AI가 아닙니다. 의료기기로 허가받은 제품들은 더 많은 데이터로 학습한 트랜스포머 모델 여러 개를 묶어 쓰고, 성능도 이보다 훨씬 높습니다. 그리고 의사의 진단과 비교한 시험도 아니에요. X에서는 한 사용자가 같은 시험을 Gemini 4 Argon으로 돌려 54%가 나왔다고 올렸지만, 이 수치는 확인하지 못했습니다.
회사에 AI를 붙일 때도 같은 질문이 나옵니다.
AI를 도입할 때 흔히 나오는 질문이 가장 좋은 모델 하나를 쓰면 되지 않느냐는 것입니다. 이번 시험은 답이 일의 모양에 따라 다르다는 걸 보여 줍니다.
- 정답이 몇 가지로 정해져 있고, 정답을 단 사례가 쌓여 있는 일은 전용 모델이 낫습니다. 불량품 판별, 문서 분류, 영수증 항목 추출 같은 일입니다.
- 상황을 읽고 다음 할 일을 정하거나, 여러 도구를 오가며 처리하는 일은 LLM이 낫습니다.
- 틀렸을 때 비용이 큰 일은 기준을 사람이 정할 수 있어야 합니다. 전용 모델은 임계값을 조정할 수 있지만, LLM의 판단 기준은 프롬프트로만 간접적으로 바꿀 수 있습니다.
그리고 이제는 데이터 정리, 학습 코드, 평가 스크립트를 LLM이 대신 써 주니, 둘 중 하나를 고르기보다 LLM으로 전용 모델을 만드는 쪽이 현실적인 답일 듯싶습니다.
프런티어 모델이 모든 일을 가장 잘할 거라는 기대가 크지만, 사진 한 장에서 병을 고르는 일에서는 10년 된 모델이 아직 앞섰습니다. 의료처럼 틀리면 안 되는 분야에서는 범용 모델 하나에 맡기기보다, 전용 모델과 LLM을 나눠 쓰는 구성이 늘어날 것 같습니다.