GPT-6.1 Terra는 정말 Opus 5.5의 9분의 1 비용으로 컴퓨터를 쓸까?
송찬우 5분 분량
10월 26일(미국 시간) OpenAI가 GPT-6.1 Terra를 공개했습니다. 화면을 보고 앱을 직접 조작하는 컴퓨터 사용에 맞춘 중간급 모델이에요. API 값은 100만 토큰당 입력 1달러(약 1,300원), 출력 5달러(약 6,600원)로, 전작 GPT-5.6 Terra와 GPT-6.1 Sol보다 50% 싸다고 밝혔습니다. OpenAI의 X 발표 글은 좋아요 1만 9천 개에 조회수 229만을 넘겼고, 해커뉴스에서는 471점에 댓글 294개가 달렸어요.
OpenAI가 내세운 숫자는 하나입니다. 최고 추론 설정에서 Claude Opus 5.5보다 작업당 비용이 약 9분의 1이라는 겁니다. 반복되는 화면 업무를 에이전트에 맡기려는 회사라면 가장 궁금한 숫자이기도 합니다. 그럼 GPT-6.1 Terra는 정말 Opus 5.5의 9분의 1 비용으로 컴퓨터를 쓸까요?
결론부터 말하면, 값은 확실히 싸고 점수는 Opus 5.5 바로 아래입니다.
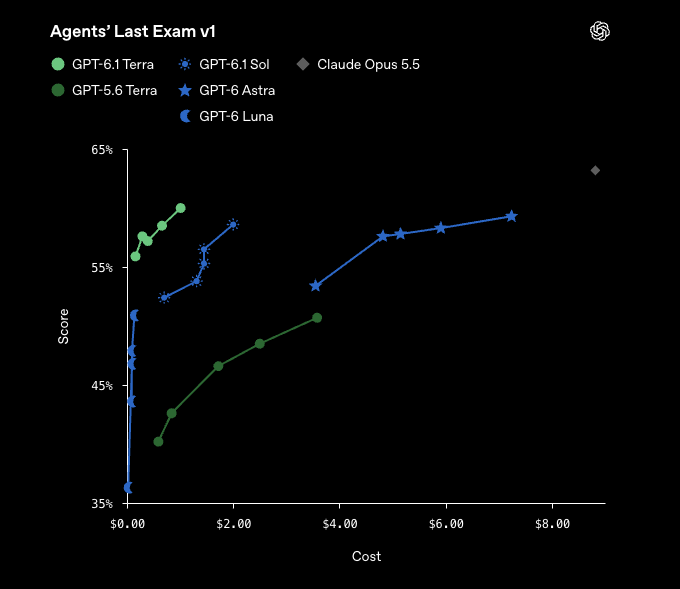
OpenAI는 컴퓨터 사용 능력을 Agents’ Last Exam이라는 벤치마크로 쟀습니다. 건축 도면을 3D 모델로 옮기거나, 애니메이션 영화를 장면마다 돌려 보며 복원 팀이 쓸 시간 기록을 만드는 식의 실무 과제를 모은 시험이에요. 중간 추론 설정에서 GPT-6.1 Terra는 GPT-5.6 Terra보다 15%포인트 높은 점수를 약 3분의 1 비용으로 냈고, GPT-6 Astra와는 토큰당 값 10분의 1로 비슷한 점수를 냈다고 합니다. 작업 속도도 GPT-6 Astra, GPT-6.1 Sol보다 3배 넘게 빨랐다고 밝혔어요.
9분의 1이라는 숫자는 이렇게 나왔습니다. 최고 설정에서 GPT-6.1 Terra는 같은 일을 하는 데 Opus 5.5보다 토큰을 3분의 1 이하로 쓰고, 토큰당 값은 4분의 1입니다. 둘을 곱하면 작업당 비용이 약 9분의 1이 돼요. 다만 OpenAI 그래프를 보면 점수 자체는 Opus 5.5가 약 63%로, GPT-6.1 Terra의 약 60%보다 조금 높습니다. 그래프에서 읽으면 작업 하나에 GPT-6.1 Terra는 약 1달러(약 1,300원), Opus 5.5는 약 8.8달러(약 1만 2천 원)가 들었어요.
값은 같은 급에서 가장 쌉니다.
OpenAI 가격표 기준으로 GPT-6.1 Terra는 입력 1달러, 캐시 입력 0.05달러, 출력 5달러입니다. Artificial Analysis에 따르면 GPT-5.6 Terra는 입력 2달러, 캐시 입력 0.20달러, 출력 12달러였어요. 같은 회사의 GPT-6.1 Sol은 2달러/0.10달러/10달러, GPT-6 Astra는 10달러/1달러/50달러이고, Anthropic의 Claude Opus 5.5는 4달러/0.20달러/20달러입니다. 더 작은 GPT-6 Luna는 0.10달러/0.01달러/0.50달러로 이보다 훨씬 싸지만, 성능 차이가 큽니다.
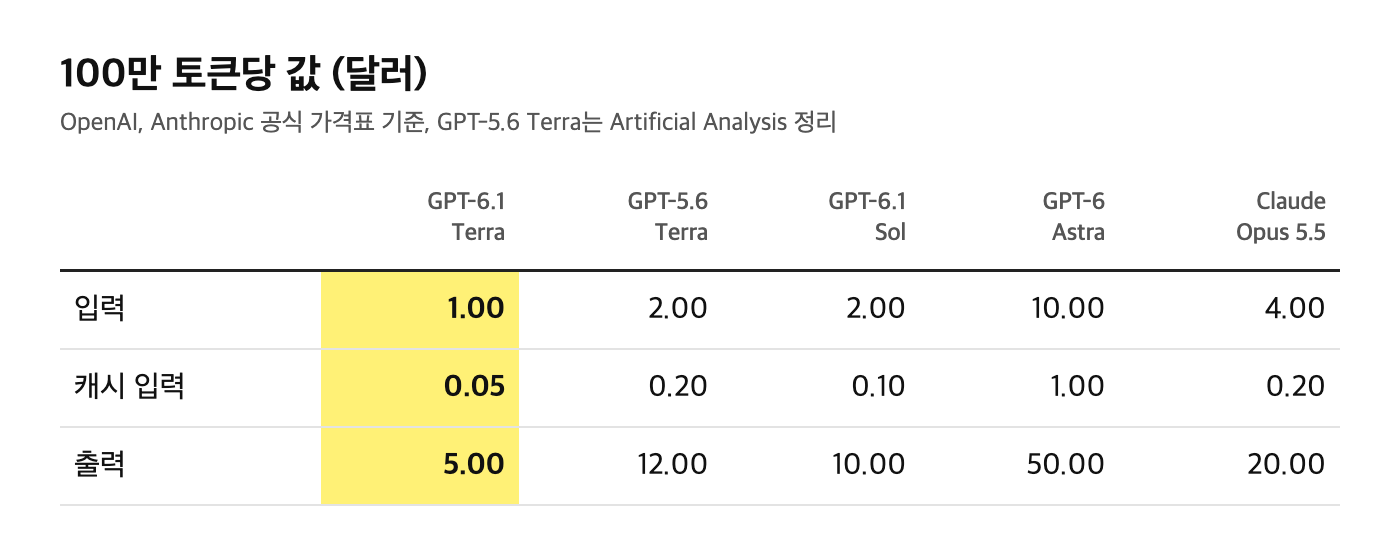
캐시 입력 값이 4분의 1로 내려간 게 특히 큽니다. 에이전트는 한 단계마다 지금까지의 화면과 대화를 다시 모델에 넣기 때문에, 오래 일할수록 캐시 입력이 비용의 대부분을 차지하거든요. ChatGPT Work와 Codex에서도 같은 사용 한도로 GPT-5.6 Terra보다 더 많은 일을 할 수 있고, GPT-6.1 Sol이나 GPT-6 Astra보다는 훨씬 많은 일을 할 수 있다고 밝혔습니다.
코딩과 사실 정확도도 크게 올랐습니다.
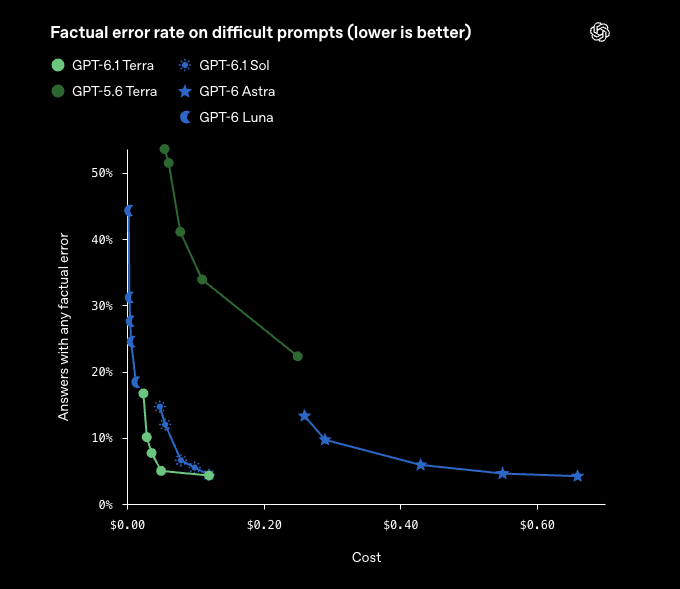
OpenAI는 올해 환각을 줄이는 데 공을 들였다고 밝혔습니다. 오류를 유도하는 질문을 모은 내부 시험에서 낮은 추론 설정의 오류율이 GPT-5.6 Terra의 53.6%에서 16.7%로 37%포인트 가까이 내려갔고, 최고 설정에서는 4.3%까지 내려가 GPT-6 Astra, GPT-6.1 Sol과 거의 같아졌습니다. Artificial Analysis의 자체 시험에서도 모르는 질문에 지어내서 답하는 비율이 88%에서 38%로 줄었어요.
터미널에서 코딩 문제를 푸는 Terminal-Bench 4.0에서는 최고 설정으로 50.3%를 풀어, GPT-5.6 Terra가 발표했던 21.5%의 두 배를 넘겼습니다. Artificial Analysis의 코딩 에이전트 지표에서는 48점으로 GPT-6.1 Sol의 54점보다 6점 낮고 GPT-6 Luna의 31점보다 17점 높았어요. OpenAI도 가장 복잡한 코딩은 여전히 GPT-6.1 Sol이나 GPT-6 Astra가 낫다고 적었습니다.
OpenAI가 든 예시는 송장 입력입니다.
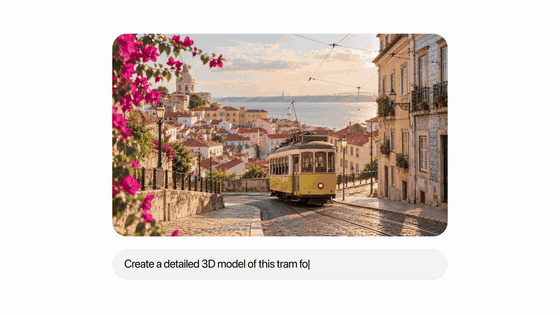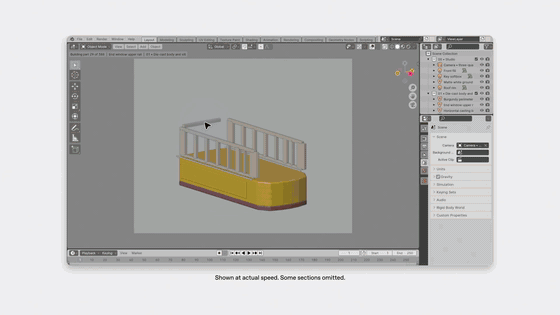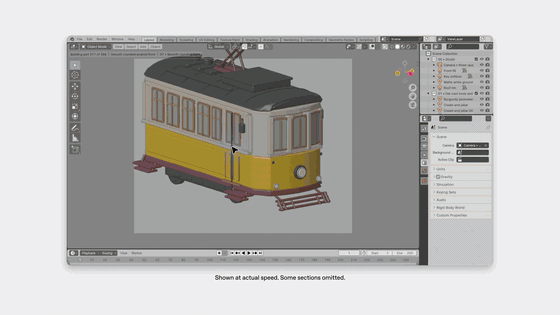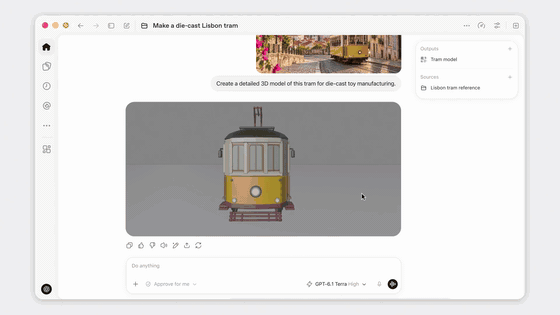
OpenAI는 GPT-6.1 Terra가 맞는 일로 제안서 쓰기, 기술 도면 읽기, 서류 양식 채우기, 영상 편집을 꼽았습니다. 그리고 들어오는 송장을 읽고 회계 프로그램에 내용을 입력하는 일처럼, 양이 많은 업무를 자동화하기에 값이 맞는다고 밝혔어요. 발표 영상에서는 리스본 트램 사진 한 장을 주고 다이캐스트 장난감 제작용 3D 모델을 만들어 달라고 하자, 3D 프로그램을 직접 조작해 트램을 만들어 냅니다. 영상은 실제 속도이고 일부 구간을 잘라 냈다고 적혀 있어요.
회사에서 에이전트를 만들다 보면 실제로 가장 많이 들어오는 요청이 이런 일입니다. 메일로 온 청구서를 사내 ERP에 옮기고, 그룹웨어에 결재를 올리고, 거래처 사이트에서 서류를 내려받는 일이요. API가 없는 오래된 사내 시스템이 많아서 화면을 직접 조작해야 하는 경우가 대부분이고, 하루 수백 건씩 반복됩니다. 작업당 비용이 9배 차이 나면, 하루 수백 건씩 돌리는 일에서는 모델 선택이 곧 예산이 됩니다. 지난번 ‘Cloudflare Clairic은 정말 LLM보다 영수증과 메일을 잘 읽을까?’에서 다뤘던, 영수증과 청구서에서 값을 뽑는 일의 바로 다음 단계입니다.
그래서 하나의 모델로 전부 처리하기보다 일에 따라 나눠 쓰는 구조가 맞아 보입니다.
- 값을 뽑는 일은 Clairic 같은 전용 모델이나 GPT-6 Luna처럼 작은 모델에 맡깁니다.
- 화면을 보고 여러 앱을 오가는 반복 업무는 GPT-6.1 Terra에 맡깁니다.
- 복잡한 코딩이나 판단이 필요한 일은 GPT-6.1 Sol, GPT-6 Astra, Claude Opus 5.5에 맡깁니다.
- 돈이 나가거나 외부로 보내는 단계는 사람이 승인하도록 남겨 둡니다.
다만 OpenAI가 고른 시험이라는 점은 봐야 합니다.
9분의 1이라는 숫자는 OpenAI가 고른 벤치마크와 OpenAI가 잰 비용에서 나왔습니다. Opus 5.5의 점수가 여전히 조금 높다는 것도 같은 그래프에 있어요. 실제 업무에서는 화면 구성, 로그인, 예외 상황에 따라 쓰는 토큰이 크게 달라지기 때문에, 사내 업무 몇 가지로 직접 비용을 재 보기 전에는 9분의 1을 그대로 믿기 어렵습니다.
보안 쪽도 챙겨야 합니다. OpenAI는 GPT-6.1 Terra가 자체 대비 체계에서 사이버 보안 위험이 가장 높은 단계인 Critical 기준에 해당한다고 밝혔고, GPT-6 Astra에 쓰던 보호 장치를 그대로 적용했다고 했습니다. 프롬프트 인젝션 시험에서도 강한 저항을 보였다고 했지만, 화면에 보이는 글을 읽고 움직이는 에이전트는 웹페이지나 메일에 숨긴 지시에 노출되기 쉬워요.
해커뉴스에서는 반응이 갈렸습니다. Luna, Terra, Sol, Astra로 이어지는 이름 체계가 헷갈린다는 댓글이 가장 많은 답글을 받았고, 한 단계 위 모델을 낮은 설정으로 쓰면 되는데 Terra 같은 중간급이 왜 필요하냐는 댓글도 있었습니다. 반대로 그래프가 맞다면 GPT-6 Astra를 훨씬 싼 값에 따라잡은 셈이라는 댓글도 올라왔어요.
그동안 컴퓨터 사용은 주로 가장 비싼 모델에 맡기는 일이었습니다. 이제는 중간급 모델이 비슷한 일을 몇 분의 1 값에 해내면서, 반복되는 화면 업무를 맡길지 말지가 성능보다 비용 계산의 문제가 돼 가는 것 같습니다. 다음 경쟁은 같은 일을 얼마나 적은 토큰으로 끝내느냐가 될 듯싶습니다.