OpenAI가 지수 시간 가설을 뒤집었다는데, 증명은 누가 확인할까?
송찬우 5분 분량
10월 26일(미국 시간) OpenAI가 내부 모델로 얻은 연구 결과 세 개를 한꺼번에 공개했습니다. 수학에서는 카케야 추측을 모든 차원에서 풀었고, 물리학에서는 양자색역학(QCD)이 수학적으로 존재한다는 증명을 내놨어요. 그리고 컴퓨터 과학에서는 25년 넘게 정설처럼 쓰이던 지수 시간 가설(ETH)이 틀렸다고 증명했습니다. 이 발표를 알린 Dan Roberts의 X 게시물은 좋아요 2,900개에 조회수 46만을 넘겼고, 해커뉴스에서는 발표 글이 약 240점, 논문 PDF가 141점을 받았습니다.
세 결과 모두 Lean이라는 증명 검사 언어로 형식화까지 마쳤다고 합니다. 그런데 OpenAI는 이번에 결과를 바로 논문으로 내지 않고, 분야 전문가들에게 검증을 맡기는 방식을 골랐어요. AI가 증명을 내놓는 속도를 사람이 확인하는 속도가 따라가지 못하는 상황이 된 겁니다. 이 중 개발자에게 가장 가까운 지수 시간 가설 이야기를 중심으로 정리해 봤습니다.
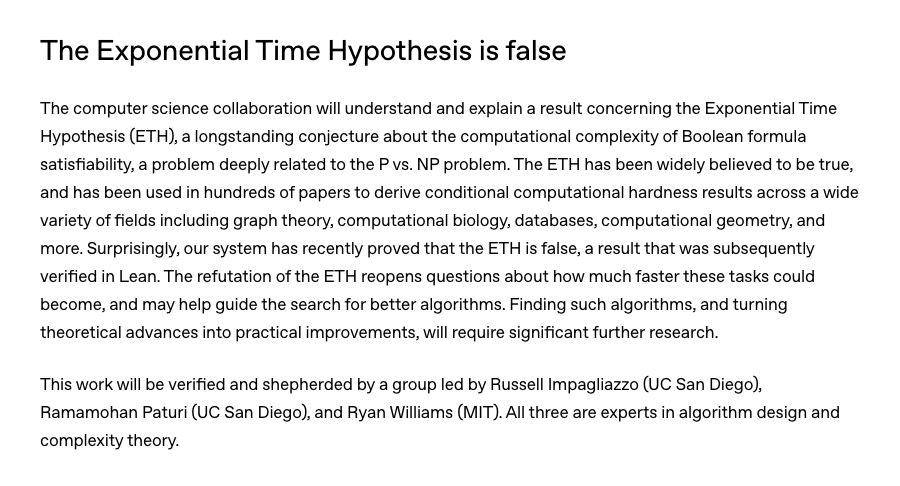
결론부터 말하면, 3-SAT을 지수 시간보다 빨리 푸는 알고리즘이 나왔습니다.
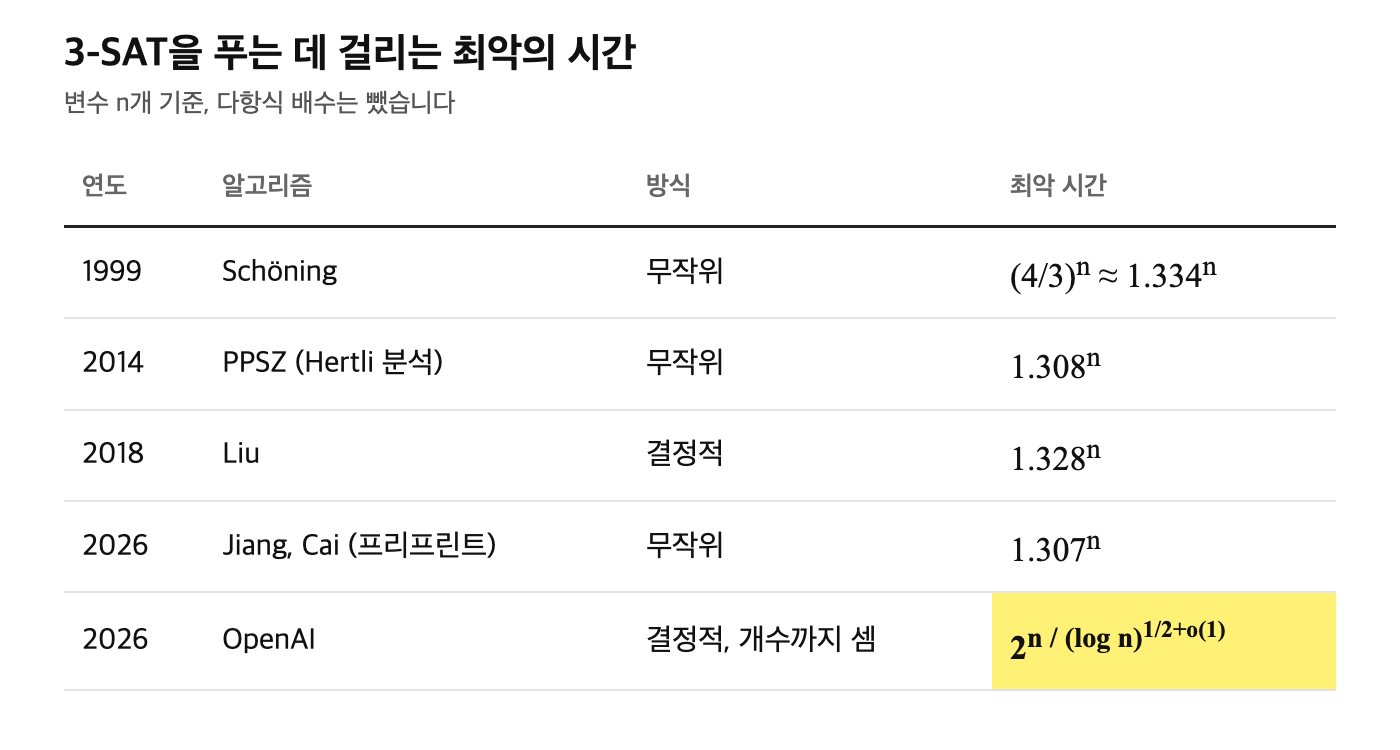
3-SAT은 참/거짓 변수 n개로 만든 논리식을 참으로 만드는 값이 있는지 묻는 문제입니다. 변수가 하나 늘 때마다 따져 볼 조합이 두 배가 되기 때문에, 그동안 나온 알고리즘은 모두 1.3의 n제곱 같은 지수 시간이 걸렸어요. 1999년 Schöning의 알고리즘이 (4/3)의 n제곱, 2014년 Hertli가 1.308의 n제곱, 2026년 Jiang과 Cai의 프리프린트가 1.307의 n제곱까지 줄였습니다. 지수의 밑을 소수점 셋째 자리에서 깎는 싸움이었던 셈입니다.
지수 시간 가설은 이 밑을 아무리 깎아도 1보다 큰 어떤 수의 n제곱 아래로는 내려갈 수 없다는 가설입니다. Russell Impagliazzo, Ramamohan Paturi가 2001년 논문으로 제안했고 Francis Zane과 함께 다듬었습니다. 증명된 적은 없지만 그래프 이론, 계산생물학, 데이터베이스까지 수백 편의 논문이 이 가설을 전제로 이 문제는 이보다 빨리 풀 수 없다고 주장해 왔습니다.
OpenAI 논문은 변수 n개, 절 m개짜리 k-CNF 식을 참으로 만드는 값의 개수를 정확히 세는 결정적 알고리즘을 내놨습니다. 걸리는 시간은 대략 2의 (n을 log n의 제곱근으로 나눈 값)제곱이고, 메모리는 다항식만큼만 씁니다. 지수에서 n이 log n의 제곱근만큼 줄어드니 지수 시간보다는 느리게 자라요. 답이 있는지만 묻는 게 아니라 몇 개인지까지 세기 때문에, 지수 시간 가설과 함께 더 강한 가설인 SETH, 개수를 세는 문제의 가설인 #ETH도 한꺼번에 틀린 게 됩니다.
P=NP라는 뜻은 아닙니다.
제목만 보면 P 대 NP 문제가 풀린 것처럼 보이지만, 논문은 그렇지 않다고 직접 적었습니다. 2의 o(n)제곱 같은 시간은 일반적인 다항 시간 변환을 거치면 유지되지 않아서, 이번 결과로 모든 NP 문제를 지수 시간보다 빨리 풀 수 있게 되지는 않는다고 밝혔어요. 여전히 다항 시간과는 거리가 멉니다.
당장 쓸 수 있는 알고리즘도 아닙니다. 숨은 상수를 모두 1로 놓고 어림하면, 변수 1,000개에서 새 알고리즘의 지수는 약 380이고 1.307의 n제곱은 약 386으로 거의 같습니다. 실제 상수는 이보다 클 가능성이 높아서, 현실적인 크기에서는 기존 알고리즘보다 빠르다고 보기 어려워요. 반도체 검증이나 일정 짜기에 쓰는 SAT 솔버는 최악의 경우가 아니라 실제 문제의 구조를 이용해 수백만 변수짜리 식을 풀기 때문에, 당장 바뀌는 것도 없습니다. OpenAI도 이론적 진전을 실제 개선으로 바꾸려면 상당한 연구가 더 필요하다고 적었습니다.
그래도 이론 쪽 파장은 큽니다. 편집 거리(두 문자열이 얼마나 다른지 재는 계산)를 n제곱보다 눈에 띄게 빨리 풀 수 없다는 결과처럼, SETH에 기대던 하한 증명들이 근거 하나를 잃었습니다. 논문에 따르면 이 중 일부는 직교 벡터 추측처럼 더 약한 가설로도 성립해서 살아남지만, 어떤 결과가 살아남는지는 하나씩 다시 따져 봐야 합니다.
검증은 가설을 만든 사람들이 맡았습니다.
OpenAI는 이 결과를 검증하고 설명할 외부 그룹을 꾸렸습니다. 이끄는 사람은 UC 샌디에이고의 Russell Impagliazzo와 Ramamohan Paturi, MIT의 Ryan Williams예요. 앞의 두 사람은 지수 시간 가설을 처음 제안한 당사자이고, Williams는 2016년 SETH의 한 변형을 반박한 적이 있는 연구자입니다. 자기가 만든 가설을 반박한 증명을 직접 검증하게 된 셈입니다.
그룹은 원자료를 전부 공개해 누구나 확인할 수 있게 해 달라고 요청했고, OpenAI가 이 결과의 의미를 따져 볼 학술대회를 지원하라고도 요구했습니다. OpenAI는 둘 다 받아들였어요. 자연어 증명과 Lean 증명은 이미 깃허브에 올라와 있습니다. 모델이 자연어 증명을 찾은 건 10월 16일, Lean 형식화를 마친 건 바로 다음 날인 10월 17일이었다고 합니다.
세 결과는 공개 방식도 모두 다릅니다. 카케야 추측 쪽은 결과물을 그대로 공개하고 연구자들이 알아서 모이게 했고, 양자색역학 쪽은 2004년 노벨 물리학상 수상자 David Gross가 이끄는 그룹이 자료 공개를 미루고 직접 논문을 쓰기로 했습니다. 이 증명에는 클레이 수학연구소의 밀레니엄 문제 중 하나인 양-밀스 이론의 존재 증명이 포함돼 있어요. OpenAI는 세 방식 중 무엇이 나을지 아직 모른다고 밝혔습니다.
협업에는 원칙 네 가지가 붙었습니다. 참여자에게 비밀 유지 계약을 요구하지 않고, OpenAI는 학문적 공로를 주장하지 않으며, 설명과 논문을 쓴 그룹이 그 공로를 인정받고, 참여는 자발적이고 무보수라는 겁니다.
Lean으로 검사해도 사람이 볼 곳은 남습니다.
Lean 형식화는 증명의 각 단계를 컴퓨터가 기계적으로 검사한다는 뜻이라, 사람이 수백 쪽을 읽는 것보다 훨씬 믿을 만합니다. 다만 Lean이 확인해 주는 건 Lean으로 적은 명제가 참이라는 것까지입니다. 그 명제가 논문이 주장하는 내용과 정확히 같은지는 사람이 봐야 해요. 실제로 OpenAI 저장소의 설명을 보면, Lean으로 증명한 건 논문의 시간 한계보다 조금 느슨한 버전이고 더 빠른 한계는 아직 논문 원고에만 있습니다.
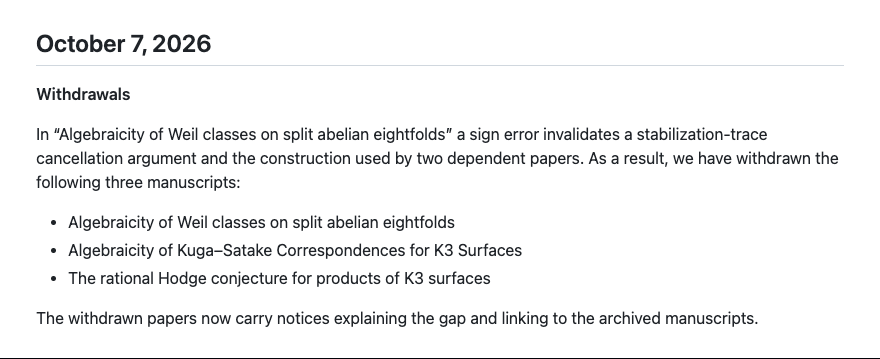
OpenAI 수학 저장소에는 지금 원고 721편이 373개 묶음으로 올라와 있습니다. 모델에게 약 4,000개 문제를 던져 얻은 결과이고, 결과 하나에 평균 ChatGPT Pro로 약 3시간 추론하는 만큼의 계산을 썼다고 해요. 이 중 핵심 결과가 Lean으로 형식화된 비율은 약 42%입니다. 형식화되지 않은 원고에서는 이미 문제가 나왔습니다. 10월 7일 OpenAI는 원고 한 편의 부호 오류 때문에 그 원고와 이를 바탕으로 한 원고 두 편까지 세 편을 철회했고, 다른 원고 14편도 고쳤습니다.
AI가 만든 코드를 리뷰할 때와 같은 구조입니다. 테스트를 통과해도 그 테스트가 원래 요구 사항을 제대로 담았는지는 사람이 봐야 하고, 만드는 속도가 빨라질수록 확인하는 쪽이 병목이 됩니다. 지난 9월 ‘AI 시대, 코드 리뷰는 어떻게 해야 할까’에서 다뤘던, 테스트를 통과해도 미묘하게 틀릴 수 있어 기계 검사와 사람의 확인을 같이 둬야 한다는 바로 그 이야기입니다.
반응은 기대와 불편함으로 갈렸습니다.
해커뉴스에서는 이 결과가 P=NP 쪽으로 무게를 옮기는지 묻는 댓글과, 무섭기도 하고 설렌다는 댓글이 올라왔습니다. 반대로 OpenAI가 내놓은 지원금 500만 달러(약 66억 원)로는 박사과정생 몇 명을 지원하는 정도라며, AI가 쏟아내는 결과를 검증하는 일을 학계에 떠넘긴다는 비판도 있었어요. 동료 평가를 건너뛰고 소수의 전문가에게만 먼저 보여 준다는 지적도 나왔습니다.
이런 비판에도 일리가 있습니다. 검증 그룹을 누가 맡느냐에 따라 누가 먼저 결과를 이해하고 누가 뒤처지는지가 갈리기 때문입니다. OpenAI도 첫 관리자를 고르는 순간 정보의 비대칭이 생긴다고 직접 인정했어요.
다만 아직 검증이 끝난 결과는 아닙니다.
지금 확인된 건 OpenAI가 공개한 논문과 Lean 증명, 그리고 검증 그룹이 꾸려졌다는 사실까지입니다. 외부 전문가가 증명이 맞다고 공식적으로 밝힌 단계는 아니고, 그룹의 검토 결과는 앞으로 나옵니다. 이 결과를 낸 내부 모델의 이름과 공개 일정도 밝히지 않았습니다.
몇 년 전만 해도 AI가 수학 문제를 푼다는 건 올림피아드 문제를 맞힌다는 뜻이었습니다. 이제는 수백 편의 논문이 기대던 가설이 AI의 증명 하나로 흔들리고, 그 증명을 사람이 어떻게 확인할지가 더 큰 문제가 됐어요. 앞으로 연구자의 일은 문제를 푸는 쪽보다 무엇이 맞는지 확인하고 의미를 설명하는 쪽으로 옮겨 갈 것 같습니다.
https://openai.com/index/building-scientific-understanding-with-academic-communities/