
Anthropic, Fable 5.2 출시
송찬우 8분 분량
이 글은 한국어로만 제공돼요. English articles →
Anthropic이 11월 9일(미국 시간) Claude Fable 5.2를 출시했습니다. Fable 5.1이 나온 지 약 두 달 만이에요. Anthropic은 Fable을 어려운 추론과 오래 걸리는 에이전트 작업에 쓰는 모델로 소개합니다. 몇 시간씩 이어지는 에이전트 작업, 여러 단계를 거치는 리서치, 문서나 스프레드시트, 발표 자료까지 완성하는 분석을 대표적인 쓰임새로 꼽았어요.
Fable 5.2는 Mythos 5.2와 같은 바탕 모델입니다. Fable에는 사이버 보안과 생물학 쪽 오용을 막는 보호 장치를 강하게 걸어 모든 사용자에게 열었고, Mythos는 보안이나 의생명 연구를 하는 기관이 신청해서 쓰는 모델이에요. Fable 5.2는 출시일부터 Claude 앱과 Claude Code, Claude API, 그리고 AWS, 구글 클라우드, Microsoft Azure에서 쓸 수 있습니다.
독립 평가의 종합 점수는 가장 높습니다.
모델 성능을 따로 재는 Artificial Analysis의 종합 지수 Intelligence Index v5.0.1에서 Fable 5.2는 65점으로 1위입니다. 코딩, 과학, 지식 업무, 일반 지식을 보는 평가 아홉 개를 Artificial Analysis가 직접 돌려 하나로 묶은 점수예요. 다른 회사의 대표 모델과 나란히 놓으면 Gemini 4 Carbon은 60점, Claude Opus 5.5는 59점, GPT-6 Astra는 57점입니다.
점수는 모델을 얼마나 오래 생각하게 하느냐에 따라 달라집니다. 위 숫자는 Fable 5.2와 Opus 5.5를 가장 높은 Max 설정으로, Carbon은 High, Astra는 Max로 잰 값이에요. Fable 5.2는 두 단계 낮춘 High 설정에서도 62점으로 Carbon보다 높았습니다. Carbon과 Opus 5.5가 1점 안팎으로 붙어 있는 데 비해, Fable 5.2는 Carbon보다 5점 가까이 위에 있습니다.
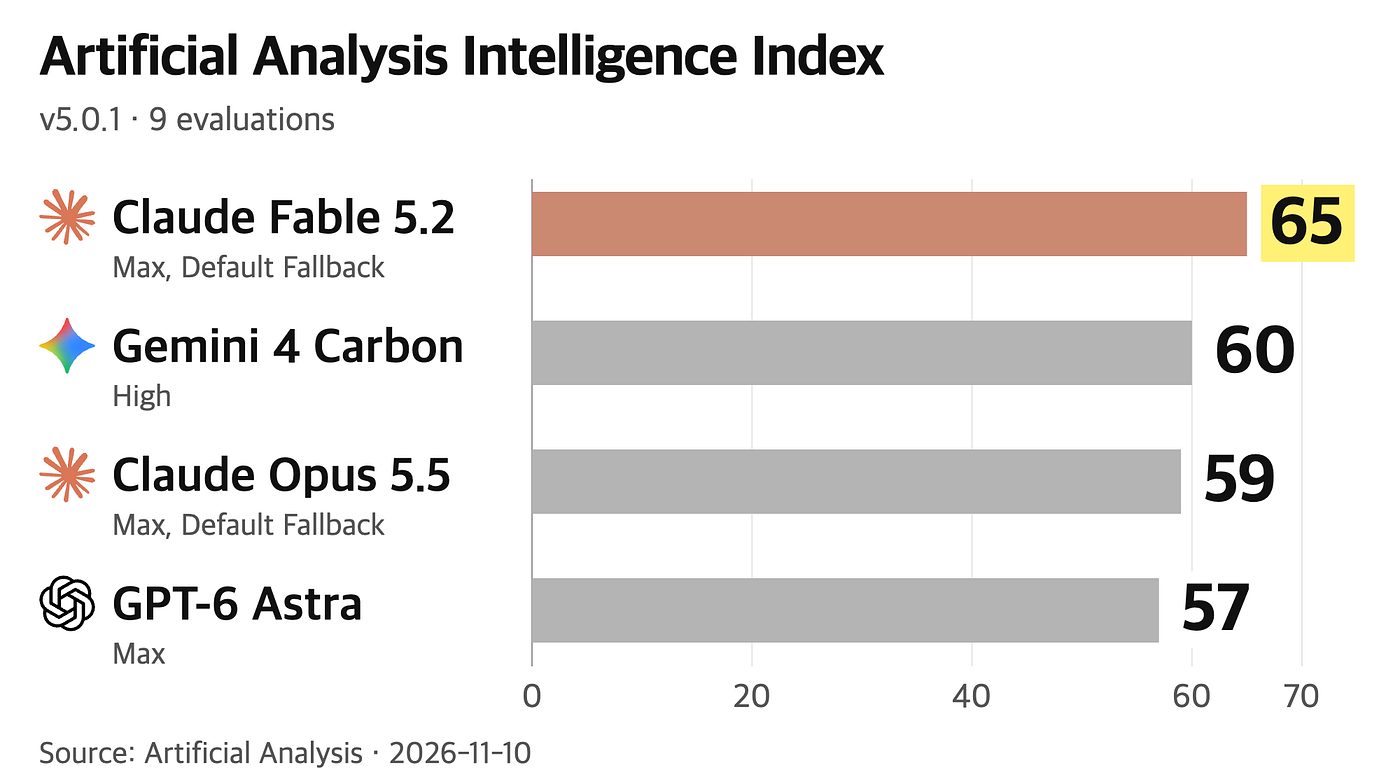
Fable 5.2는 네 모델 가운데 코드와 과학 시험에서 1위, 긴 PDF 시험에서 4위입니다.
종합 지수를 이루는 평가 아홉 개 가운데 성격이 다른 세 개를 따로 봤어요. 실제 저장소의 코드 고치기, 터미널에서 끝까지 하는 과학 연구, 긴 PDF 업무입니다.
FrontierCode 2.0은 실제 오픈소스 저장소에서 뽑은 과제 132개를 에이전트에게 맡기고, 메인테이너가 그 변경을 받아 줄 만한지를 기준으로 채점합니다. Fable 5.2는 48.8%로 Opus 5.5(46.4%)보다 2.4포인트, GPT-6 Astra(42.4%)보다 6.4포인트, Carbon(40.6%)보다 8.2포인트 높았습니다. 같은 Anthropic의 Opus 5.5와는 차이가 작고, 다른 회사 모델과는 더 벌어집니다.
차이가 가장 큰 건 Terminal-Bench-Science 0.1입니다. 생명과학, 물리, 지구과학, 수학, 공학 분야 전문가들이 실제 연구 과정에서 가져온 과제 70개를 터미널에서 끝까지 해내야 하고, 과제마다 붙은 테스트를 모두 통과해야 성공으로 칩니다. Fable 5.2는 73.3%로 Carbon(64.8%)보다 8.5포인트, Opus 5.5(59.0%)보다 14.3포인트 높았어요. Opus 5.5와 비교하면 통과한 과제가 약 24% 더 많은 셈입니다.
반대로 GDP.pdf에서는 네 모델 중 가장 낮았습니다. 열 개 분야의 긴 업무용 PDF를 읽고 전문가가 할 법한 일을 해내는 과제 100개인데, 채점 기준을 하나라도 놓치면 실패로 칩니다. Fable 5.2는 24.2%로 GPT-6 Astra(31.0%), Carbon(28.4%), Opus 5.5(26.2%)에 모두 뒤졌어요. Anthropic이 문서까지 완성하는 분석을 대표 쓰임새로 꼽은 걸 생각하면 눈여겨볼 대목입니다. 문서 작업 전반이 약하다고 볼 근거는 아니지만, 긴 문서에서 요구 조건을 빠짐없이 챙기는 일은 적어도 이 시험에서는 GPT-6 Astra가 나았습니다.
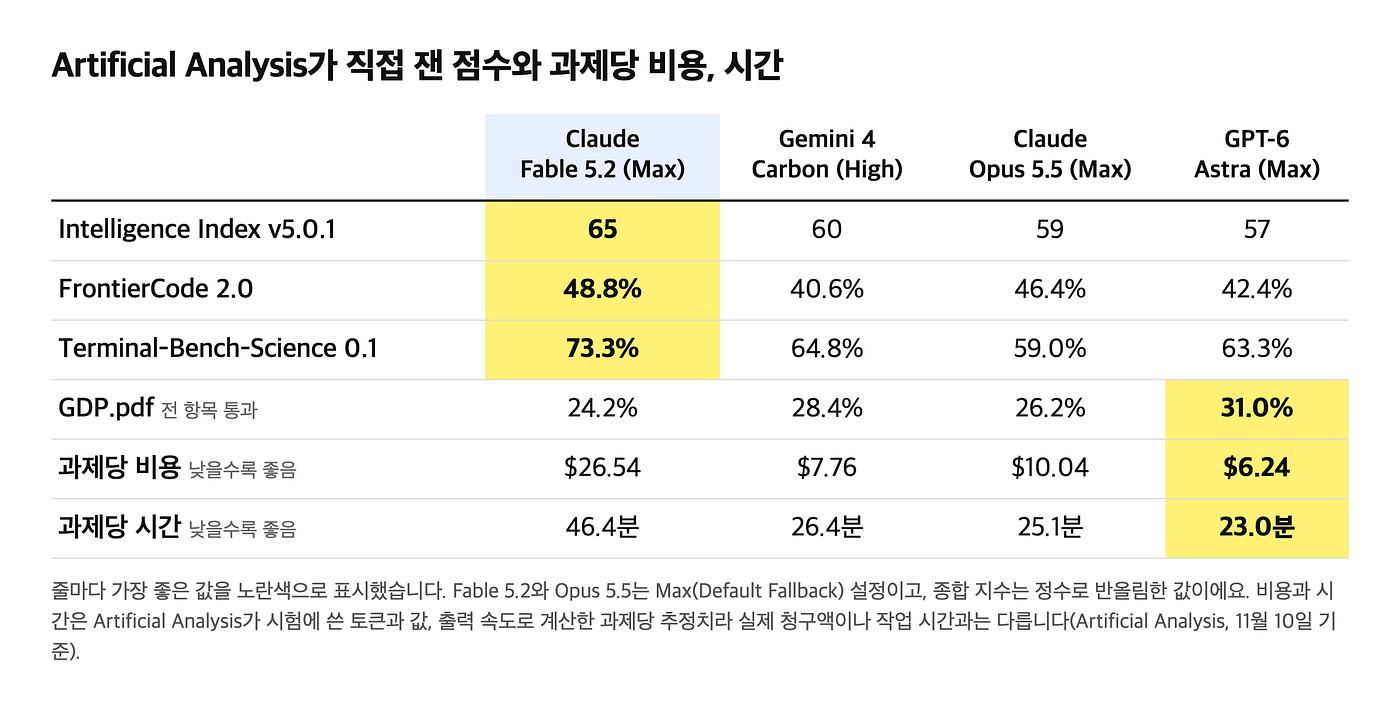
토큰 값은 내렸지만, 과제 하나에 드는 비용과 시간은 네 모델 중 가장 큽니다.
토큰 값은 내렸습니다. 100만 토큰당 입력 8달러(약 1만 1천 원), 출력 40달러(약 5만 4천 원)로 Fable 5.1보다 20% 쌉니다. 한 번에 넣을 수 있는 문맥은 100만 토큰, 내보낼 수 있는 출력은 12만 8천 토큰이에요. Anthropic은 출력 생성 속도도 Fable 5.1보다 최대 30% 빨라졌다고 밝혔습니다.
그런데 Artificial Analysis가 계산한 과제 하나당 비용은 Fable 5.2가 26.54달러(약 3만 6천 원)로 네 모델 중 가장 많습니다. Opus 5.5는 10.04달러(약 1만 3천 원), Carbon은 7.76달러(약 1만 원), GPT-6 Astra는 6.24달러(약 8,400원)예요. Opus 5.5의 약 2.6배, Astra의 4배가 넘습니다. Artificial Analysis가 종합 지수 전체를 돌리며 쓴 출력 토큰도 Fable 5.2가 2억 7,500만 개로 Opus 5.5의 2억 1,800만 개보다 많았어요.
시간도 그렇습니다. 과제 하나에 걸리는 시간 추정치는 Fable 5.2가 46.4분으로, Opus 5.5(25.1분), Carbon(26.4분), Astra(23.0분)의 두 배 안팎입니다. 두 숫자 모두 Artificial Analysis가 시험에서 쓴 토큰 수와 토큰 값, 출력 속도로 계산한 추정치라 실제 청구액이나 도구를 기다리는 시간까지 넣은 작업 시간은 아니에요. 앞의 최대 30%도 토큰을 만들어 내는 속도라 이 시간과는 다른 측정입니다.
Fable 5.2는 어렵고 오래 걸리는 일을 맡길 때 맞는 모델입니다.
정리하면 Fable 5.2는 지금 독립 평가에서 종합 점수가 가장 높은 모델이지만, 모든 일에 가장 좋은 선택은 아닙니다. 저장소의 코드를 고치거나 연구 과정을 터미널에서 끝까지 돌리는 일처럼 어렵고 긴 작업에서는 앞서고, 긴 PDF에서 요구 조건을 빠짐없이 챙기는 일은 이번 시험에서 GPT-6 Astra가 나았습니다. 과제 하나에 Opus 5.5보다 비용은 2.6배 넘게, 시간은 두 배 안팎이 드니 자주 반복하는 일은 코딩 점수 차이가 2.4포인트인 Opus 5.5나 더 싼 모델에 맡기고, Fable 5.2는 그 비용을 들일 만큼 어렵고 긴 일에 쓰는 편이 맞아 보입니다.
다만 벤치마크는 정해진 과제의 점수입니다. 몇 시간에서 며칠씩 맡긴 실제 작업에서는 어떤 결과가 나왔는지, 출시 뒤 공개된 사례 가운데 결과물과 함께 작업 방식까지 밝힌 세 가지를 골라 봤습니다. Blender 영상 제작, 이야기 1,186편 분석, 끝없이 이어지는 3D 세계 Portals입니다.
Fable 5.2가 Blender로 59초짜리 영상을 만들었습니다.
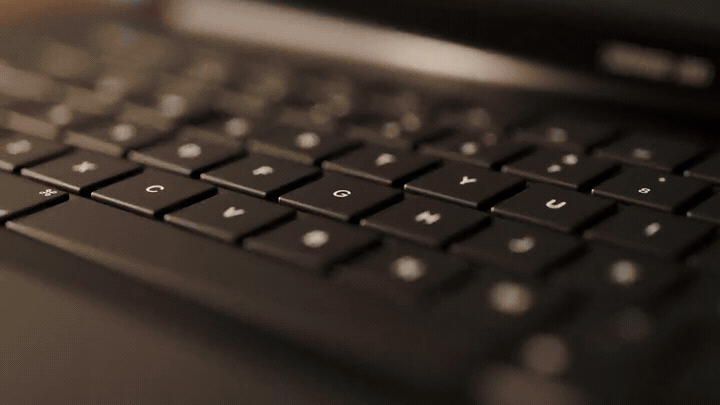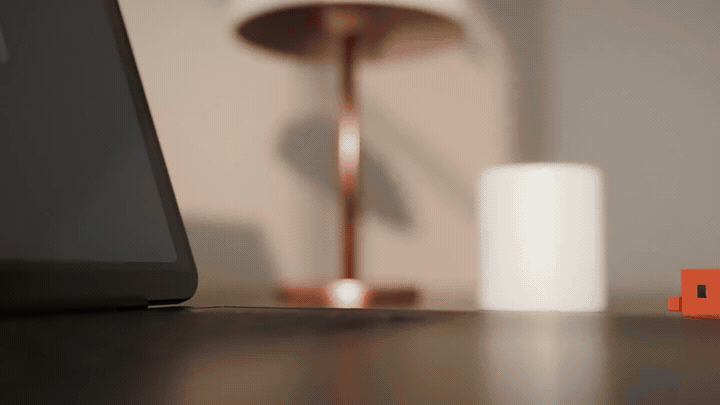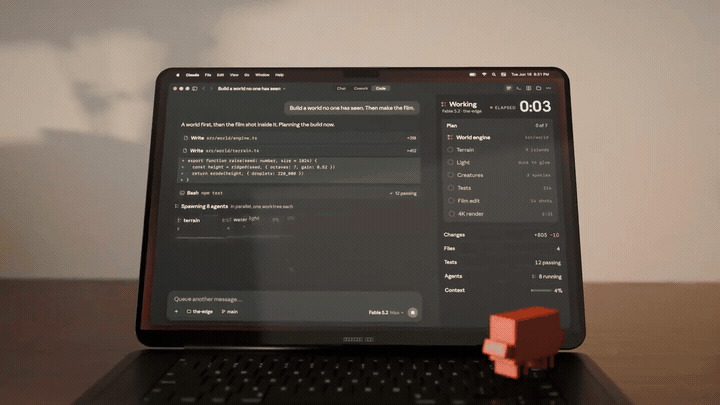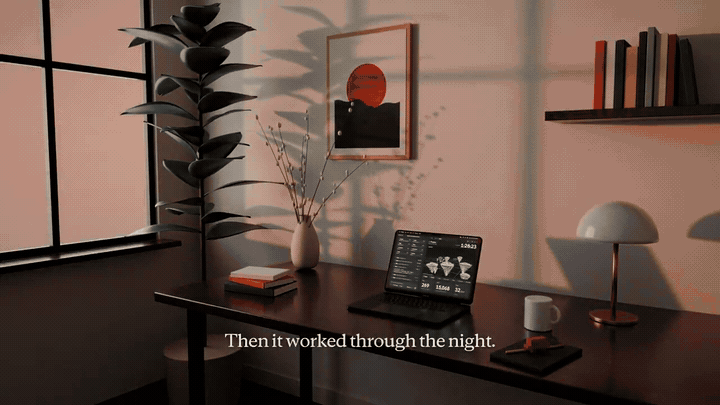
제작을 맡긴 Riley Brown은 11월 9일(미국 시간) ‘The Edge’라고 하는 영상을 X에 올렸습니다. 책상과 맥북, 조명, Clawd 캐릭터가 있는 방을 Blender로 만들고, 노트북 화면 속에서 Claude가 무언가를 만들어 가는 모습을 담은 광고풍 영상이에요.
Riley Brown이 공개한 제작 과정 문서를 보면, Fable 5.2는 노트북 화면에 띄울 웹앱을 먼저 렌더했습니다. 그 웹페이지에서 입력창, 모니터, 타임라인의 픽셀 위치를 읽어 노트북 화면 위의 3D 위치로 바꾸고, Blender 카메라가 그 위치를 겨누는 방식이에요. 방과 애니메이션은 Python 코드로 만들었고, 렌더는 RunPod에서 GPU 10장(RTX 5090 2장, RTX 4090 8장)을 빌려 프레임을 나눠 맡겼습니다. 문서에 적힌 결과물은 3840×2160, 24fps, 13개 샷, 경로 추적 렌더 1,329프레임입니다. 음악과 효과음은 ElevenLabs로 만들었어요.
Riley Brown은 비용을 5.75달러(11월 9일 환율로 약 7,700원)라고 적었는데, 같은 문서를 보면 렌더에 든 비용입니다. 51분 43초도 렌더에 걸린 시간이에요. 모델 사용료와 음향 비용, 전체 작업 시간은 살펴본 게시물과 문서에 나오지 않습니다. 그는 한 번에(one shot) 만들었다고 했지만, 요청문은 “전에 했던 것처럼 Blender로 영상을 만들어 달라”로 시작합니다. 이전 작업의 맥락 위에서 나온 결과로 봐야 합니다. 제작 과정 문서는 Riley Brown이 공유한 자료로, 작성한 쪽이 설명한 내용이지 따로 검증된 기록은 아니에요. 전체 코드와 청구서도 살펴본 자료에서는 찾지 못했습니다.
Ethan Mollick은 Fable 5.2로 이야기 1,186편을 분석했지만, 판독은 사람이 확인하지 않았습니다.
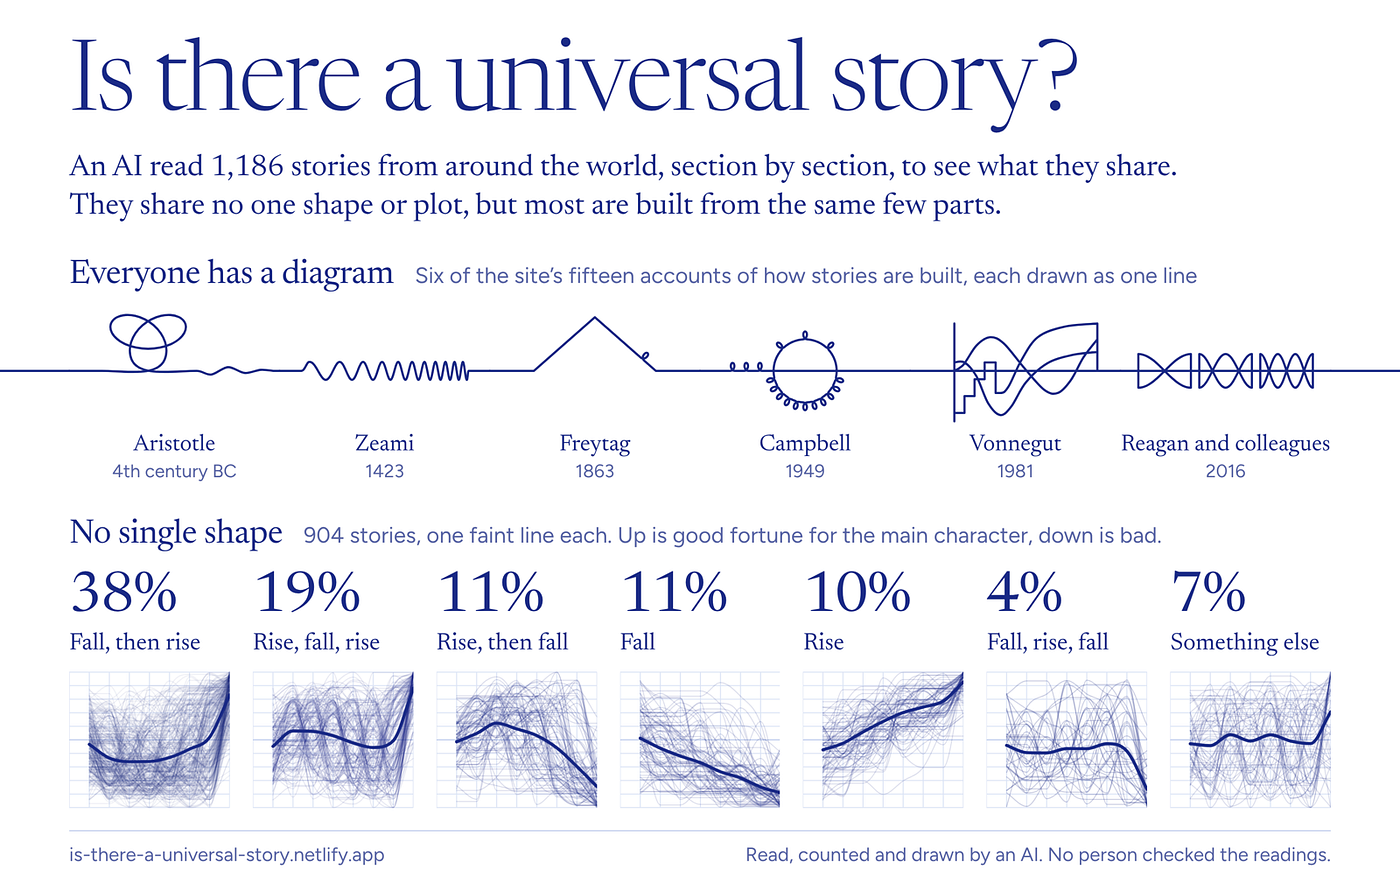
Ethan Mollick은 블로그 One Useful Thing에 Fable 5.2로 한 작업 몇 가지를 공개했습니다. 그중 하나는 이야기가 몇 가지 감정 곡선을 따른다는 기존 연구를 재현하고, 플롯에 보편적인 것이 있는지 찾아 달라고 맡긴 작업이에요. Mollick에 따르면 Fable 5.2는 세계 각지의 이야기 1,186편을 읽고 분석 사이트를 만들었습니다. 사이트의 결론은 이야기에 하나의 공통된 모양이나 플롯은 없지만 대부분 같은 몇 가지 부품으로 만들어지고, 가장 전형적인 이야기는 마법 바나나를 가진 마법사가 나오는 하와이 민담이라는 것입니다. Mollick이 겪은 주된 문제는 Claude 특유의 문체였고, 몇 번 알려 주자 고쳐졌다고 해요.
이 사례는 데이터가 공개돼 있습니다. 사이트의 texts.json에는 고유 ID 1,306개가 있고, 꿈, 일기, 전기 각 40개를 빼면 이야기 항목이 정확히 1,186개입니다. 방법과 참고문헌, 원문을 어디까지 읽었는지도 사이트에 적혀 있어요.
다만 사이트는 사람이 판독 결과를 확인하지 않았다고 밝힙니다. 교차 확인은 다른 AI 모델이 글 96편(이야기 60편, 이야기가 아닌 글 36편)을 다시 읽은 것뿐인데, 구간별 점수는 첫 판독과 가깝게 움직였지만 이야기 전체에 대한 판단은 덜 일치해 같은 모양을 고른 비율이 70%였어요. 첫 판독자는 Claude 모델이라고만 적혀 있고, 두 모델 모두 어떤 버전을 썼는지 기록되지 않아 같은 모델로 다시 판독할 수 없다고 합니다. 참고문헌 일부는 검색 스니펫으로만 읽었다고 스스로 밝혔고요. 곡선 비율도 1,186편 전체가 아니라 따로 추적한 904편 기준입니다. 결론은 아직 AI가 만든 연구의 주장으로 읽어야 합니다.
Portals의 에이전트들은 아무도 요청하지 않은 규칙집을 만들었습니다.
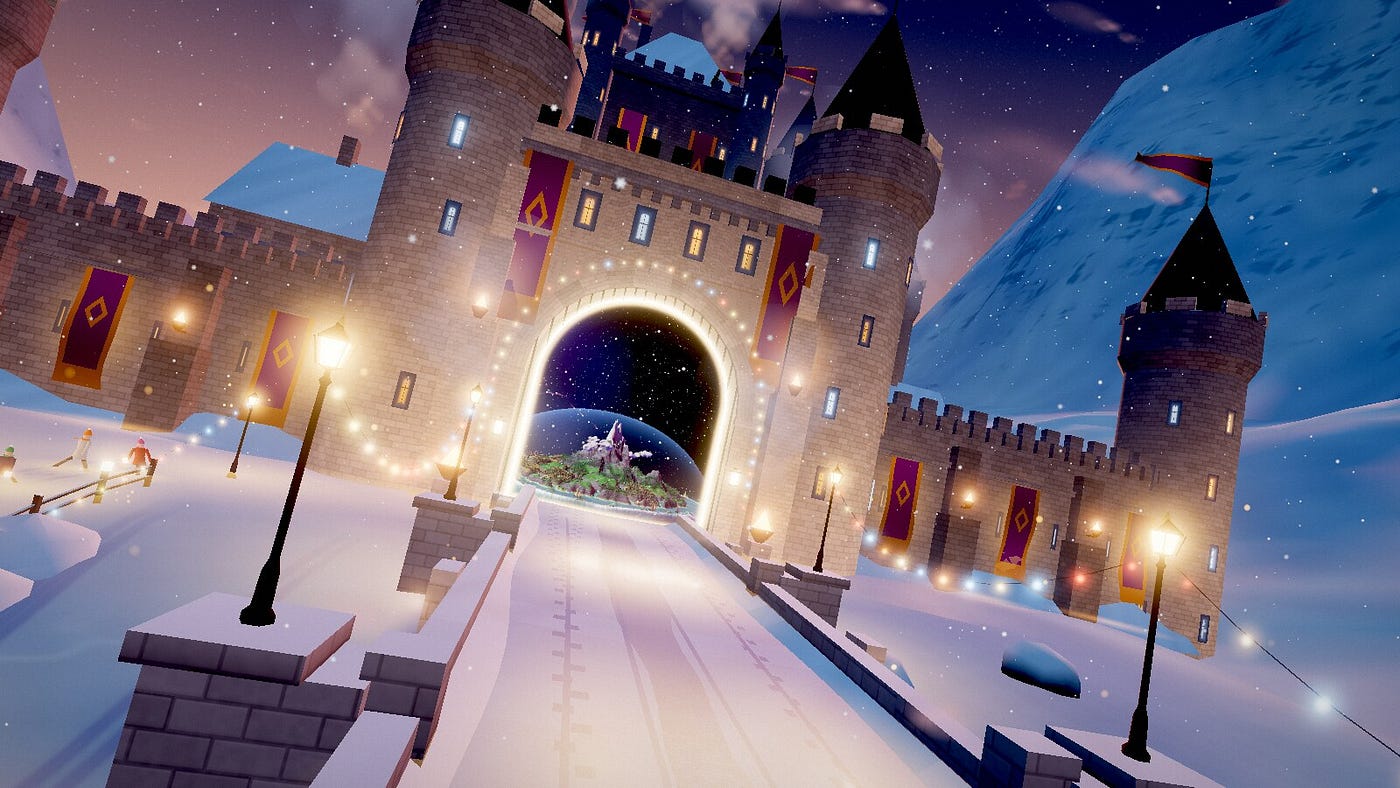
Mollick의 다른 실험 Portals는 규모가 훨씬 큽니다. 포털로 이어진 3D 세계를 손대지 않고 끝없이 날아가는 웹사이트를 한 문단으로 설명하고 “do this and make it awe inspiring”이라고만 요청했어요. 20시간 뒤 사이트에는 세계 204개가 있었습니다. 11월 9일 시점 공개 저장소는 세계 471개, 자바스크립트 약 140만 줄이라고 적고 있습니다. 화면에 보이는 세계와 포털 너머의 다음 세계 두 개를 동시에 띄우고, 다음 세계는 프레임 사이사이에 조금씩 만들어 미리 준비해 두는 구조예요.
모델 하나가 한 번에 만든 결과는 아닙니다. Mollick은 요청에서 아티스트, 코딩, 평가 에이전트 팀을 두라고 했고, 열흘째에는 리드 에이전트 하나와 에이전트 팀 28개가 동시에 작업했습니다. Claude는 에이전트 실행이 약 2만 5,000번이었다고 추정했는데, 대부분은 이미지 하나를 심사하는 식의 작은 일이었다고 해요.
처음 이틀 동안 세계 328개가 나왔지만 품질이 고르지 않았고, 세 팀이 각자 동물이 소용돌이처럼 도는 세계를 만들 만큼 겹치는 것도 많았습니다. Mollick이 새 세계를 그만 만들고 기존 세계를 다듬으라고 하자, 며칠 뒤 하루 수백 개이던 제작이 열두 개쯤으로 줄었어요.
에이전트들은 다듬기를 새 버전이 테스트 스크린샷 12장에서 심사 에이전트들의 블라인드 투표를 이겨야 한다는 뜻으로 해석했습니다. 그러자 팀들이 그 스크린샷에만 맞게 세계를 고치기 시작했고, 리드 에이전트는 이를 막으려고 규칙을 촘촘하게 만들었습니다. 다음 날 아침에는 Mollick이 요청한 적 없는 규칙집이 84개 절로 생겼고, 12일 뒤에는 204개 절, 8만 7,500단어가 됐어요. 규칙은 늘기만 하고 지워지지 않았습니다. 새 세계 하나를 내려면 승인된 아이디어, AI 심사 셋, 규칙집 기준 코드 리뷰를 거쳐야 했고, 여기에 하루쯤 걸렸습니다. 규칙집을 읽는 것만으로 에이전트의 작업 문맥 상당 부분이 찼다고 해요.
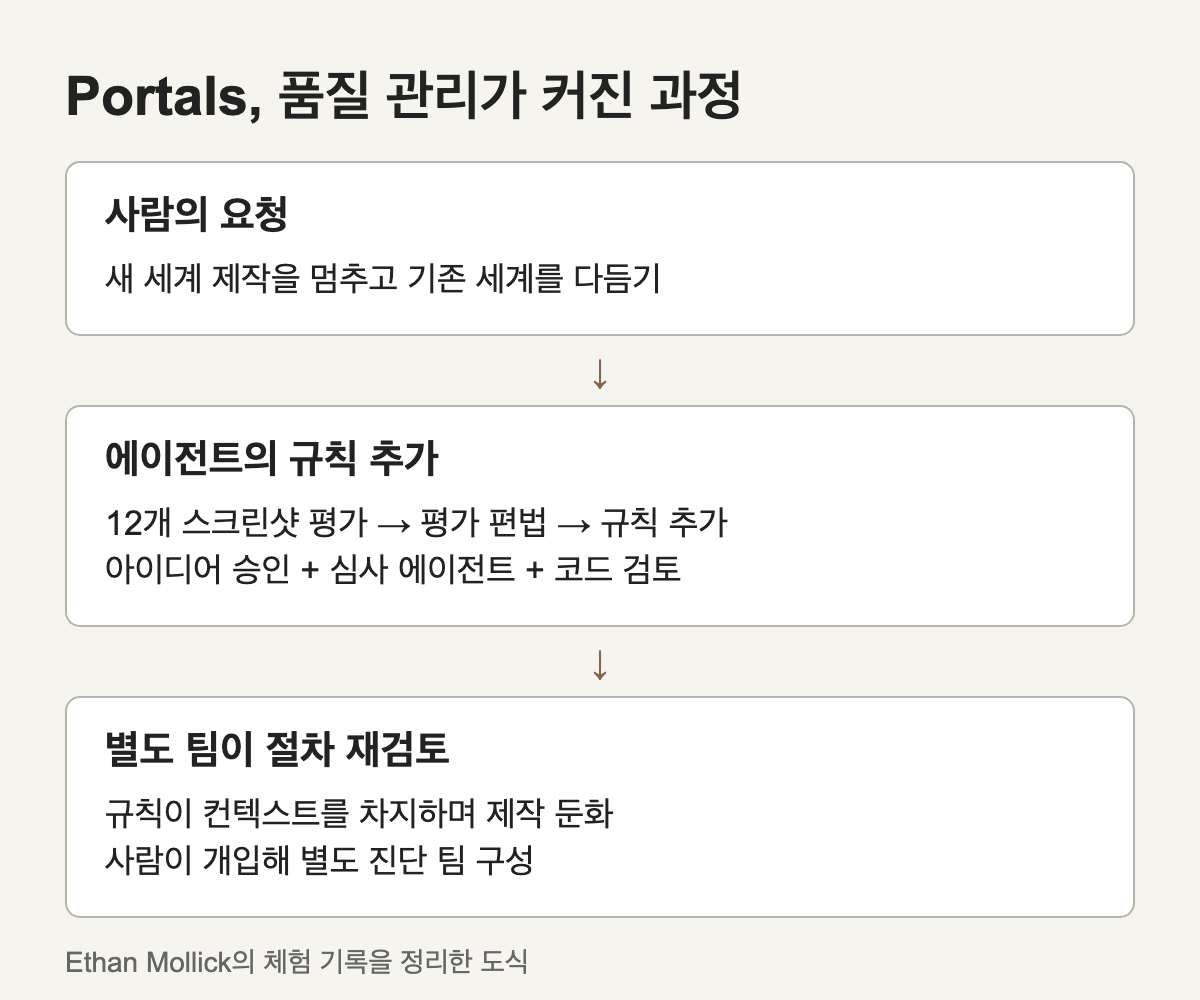
Mollick은 Fable 5.2에 바깥에서 전체 절차를 살펴볼 별도 에이전트 팀을 만들게 했습니다. 그 팀의 결론은 너무 길고 빽빽해서 읽지 않았다고 했지만, 제작은 하루 30개 이상으로 돌아왔고 품질 관리도 상당 부분 유지됐다고 합니다. 속도가 떨어진 걸 알아챈 것도, 바깥에서 절차를 보게 하자고 정한 것도 사람이었습니다.
Fable 5.2는 모든 시험에서 앞서지는 않았지만, 세 사례에서는 Blender 영상과 이야기 분석 사이트, 끝없이 이어지는 3D 세계를 만들어 냈습니다. 더 많은 사람이 써 본 결과가 쌓이면 이 모델이 잘하는 일과 그렇지 않은 일이 더 분명해질 것 같습니다.