
Alibaba Qwen4-Max는 전작보다 비용을 3분의 1로 줄였지만, Opus 5.5에는 아직 못 미칩니다
송찬우 5분 분량
이 글은 한국어로만 제공돼요. English articles →
11월 16일 Alibaba의 Qwen 팀이 새 대표 모델 Qwen4-Max를 공개했습니다. 새 Qwen4 아키텍처로 만든 첫 모델이고, 전체 매개변수 2.4조 개 가운데 토큰 하나를 처리할 때 710억 개만 쓰는 MoE 모델이에요. 문맥은 100만 토큰이고 이미지와 영상도 입력으로 받습니다. API는 QwenCloud에서 바로 열렸고, Qwen Studio, QwenWork, Qoder에서도 쓸 수 있습니다.
Qwen 공식 X 계정의 발표 글은 11월 16일 오후 기준 조회수 35만, 좋아요 5,300개를 넘겼고, 해커뉴스에서는 168점에 댓글 42개를 받았어요. Techmeme이 정리한 Bloomberg 보도에는 Alibaba가 코딩 벤치마크에서 Claude Fable 5.1과 Kimi K3.1 Pro를 앞섰다고 밝혔다는 내용이 있습니다. 그런데 Qwen 팀이 블로그에 올린 벤치마크에는 Fable 5.1이 없고, 비교 대상 가운데 가장 높은 모델은 Claude Opus 5.5였습니다.
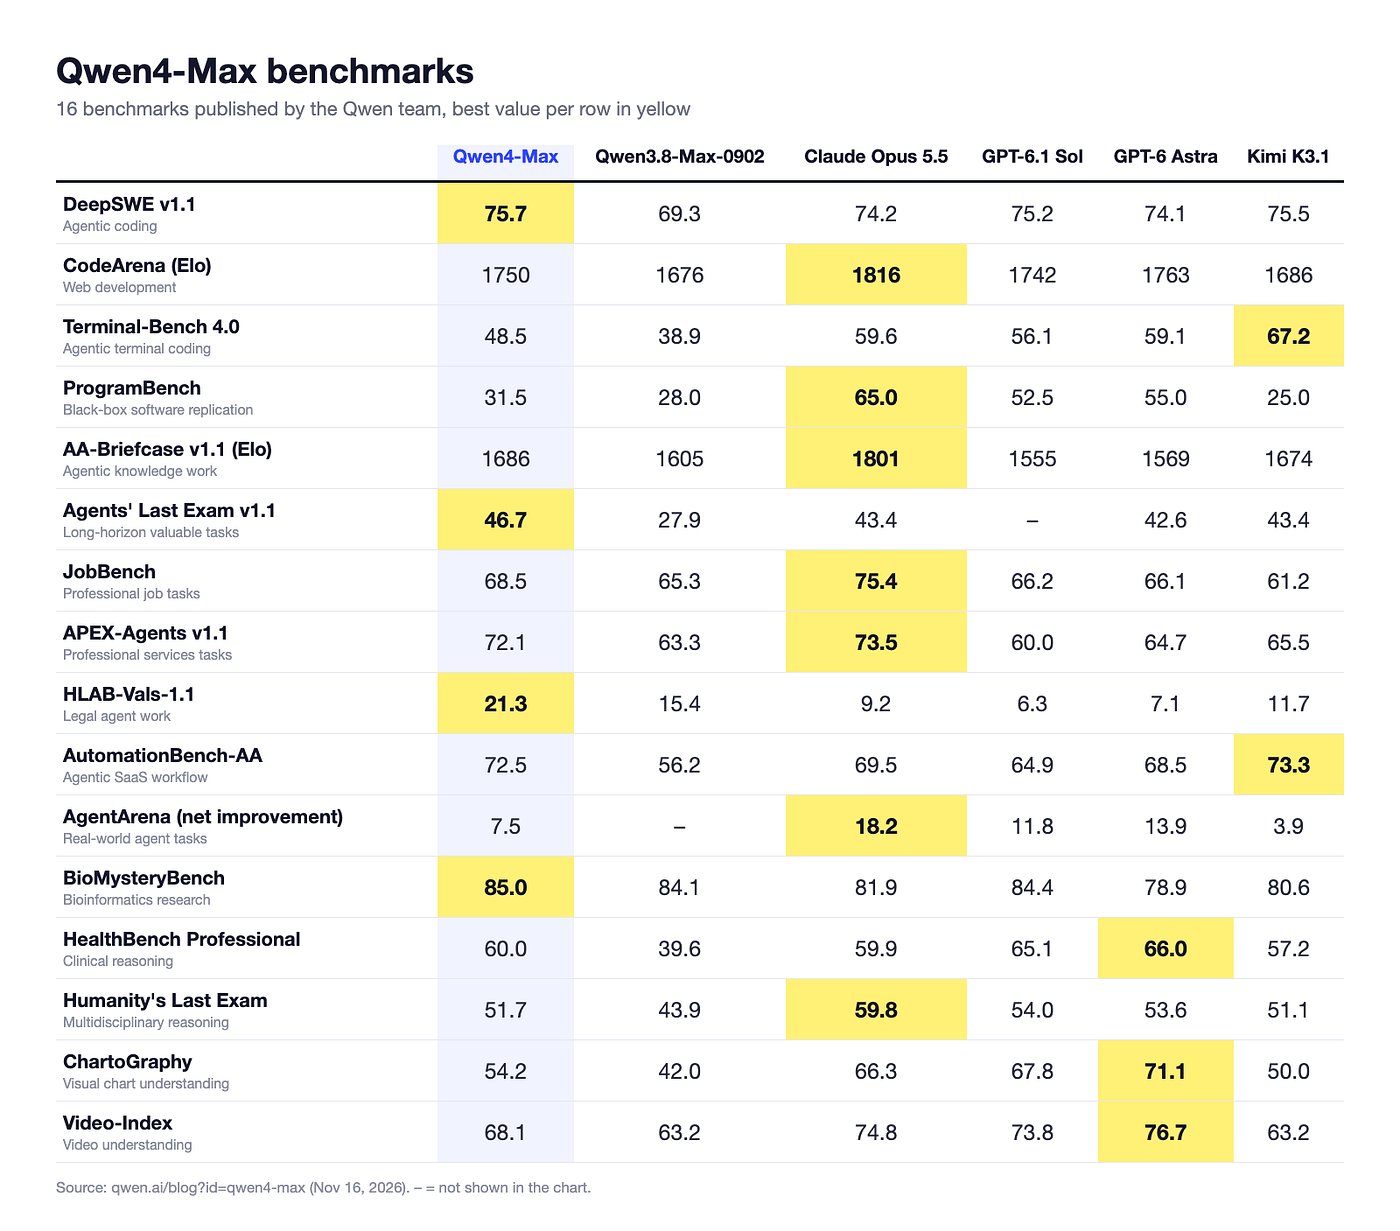
벤치마크 16개 가운데 Qwen4-Max가 1등인 것은 4개입니다.
Qwen 팀은 Qwen4-Max를 이전 모델 Qwen3.8-Max-0902, Claude Opus 5.5, GPT-6.1 Sol, GPT-6 Astra, Kimi K3.1과 벤치마크 16개에서 비교했습니다. Qwen4-Max가 가장 높은 점수를 받은 건 4개예요. 에이전트 코딩 벤치마크 DeepSWE v1.1에서 75.7로 Kimi K3.1(75.5), GPT-6.1 Sol(75.2)을 근소하게 앞섰고, 긴 작업을 끝까지 해내는지 보는 Agents’ Last Exam v1.1에서는 46.7로 Opus 5.5와 Kimi K3.1(각 43.4)보다 높았습니다. 법률 에이전트 업무를 보는 HLAB-Vals-1.1(21.3 대 Kimi K3.1 11.7)과 생명정보학 연구를 보는 BioMysteryBench(85.0 대 GPT-6.1 Sol 84.4)도 1등이에요.
1등이 가장 많은 모델은 7개를 가져간 Opus 5.5입니다. 차이가 큰 곳은 코딩이에요. 동작만 보고 소프트웨어를 다시 만드는 ProgramBench에서 Qwen4-Max는 31.5로 Opus 5.5(65.0)의 절반에 못 미쳤고, 터미널에서 일을 처리하는 Terminal-Bench 4.0에서는 48.5로 Kimi K3.1(67.2)보다 18.7점 낮았습니다. 웹 개발 CodeArena도 1,750점으로 Opus 5.5(1,816점)보다 낮아요. 코딩 벤치마크 4개 가운데 앞선 건 DeepSWE 하나입니다.
Artificial Analysis 지수에서는 Kimi K3.1 Pro보다 3점 낮습니다.
독립 평가 기관 Artificial Analysis는 발표 당일 직접 잰 결과를 공개했습니다. Qwen4-Max(xhigh)는 Intelligence Index 43점으로 Qwen3.8 Max(34점)보다 9점 올랐지만, Kimi K3.1 Pro(46점)보다는 3점 낮았어요. 평가한 81개 모델 가운데 38위입니다. Terminal-Bench 4.0은 Artificial Analysis가 잰 값도 48%로, Kimi K3.1 Pro(67%)와 차이가 컸습니다.
해커뉴스 반응도 비슷했습니다. 2.4조 매개변수 모델이 2026년 말에 낸 성적으로는 실망스럽다는 댓글이 있었고, Qwen3.8은 좋은 모델이지만 초당 30토큰 정도로 느렸다며 이번에는 더 빠르게 서비스되기를 바란다는 댓글도 달렸어요.
과제당 비용은 Qwen3.8 Max의 3분의 1입니다.
점수보다 크게 바뀐 건 비용입니다. QwenCloud 가격은 입력 100만 토큰당 1.5달러(약 2,000원), 출력 4.5달러(약 6,000원)이고, 캐시에서 다시 읽는 입력은 0.075달러(약 100원)예요. Artificial Analysis가 정리한 Qwen3.8 Max 가격(입력 2달러, 약 2,700원/출력 6달러, 약 8,000원)보다 25% 낮고, 캐시 가격(0.25달러, 약 330원)은 70% 낮습니다.
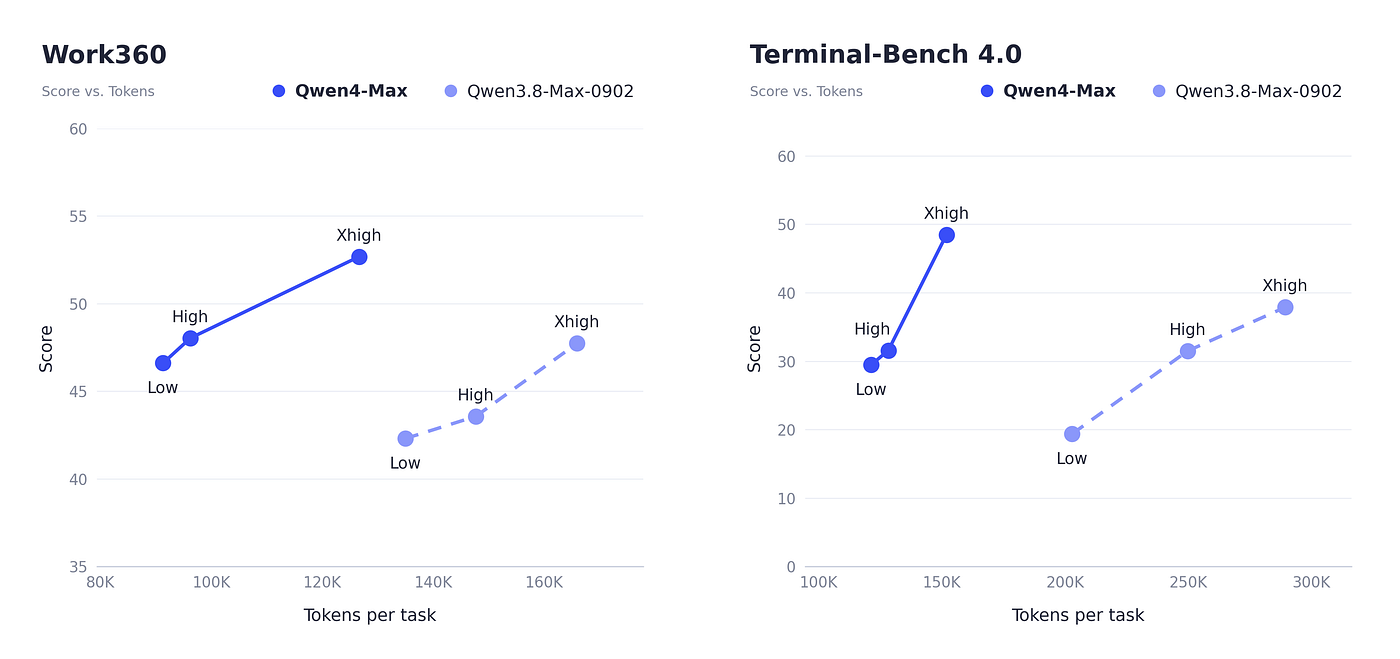
토큰도 덜 씁니다. Qwen 팀은 Terminal-Bench 4.0에서 같은 추론 강도끼리 비교했을 때 토큰을 약 48~49% 덜 썼다고 밝혔고, Artificial Analysis 측정에서도 지수 과제 하나당 출력 토큰이 약 17만 1천 개에서 약 10만 5천 개로 39% 줄었어요. 그래서 지수 과제 하나를 푸는 비용은 3.27달러(약 4,400원)로, Qwen3.8 Max(10.02달러, 약 1만 3천 원)의 약 3분의 1이고 Kimi K3.1 Pro(3.68달러, 약 4,900원)보다 약 11% 적습니다. Qwen 팀이 만든 업무 벤치마크 Work360에서도 과제당 평균 비용이 4.43달러(약 5,900원)에서 1.67달러(약 2,200원)로 62% 줄었다고 했어요.
다만 미국 모델과 비교하면 싸다고 하기는 어렵습니다. 지난 ‘Gemini 4 Hydrogen이 Gemini 4 Argon보다 높은 점수를 절반도 안 되는 비용에 냈습니다’에서 소개했던 11월 12일 기준 Artificial Analysis 결과에서는 GPT-6.1 Sol(max)이 55점을 과제당 1.27달러(약 1,700원)에 냈습니다. Qwen4-Max보다 점수는 12점 높고 비용은 절반이 안 됩니다.
금융, 법률, 의료 사례는 FDE in Action이라는 이름으로 묶었습니다.
발표 글의 상당 부분은 벤치마크가 아니라 업무 사례입니다. 그중 금융, 법률, 의료 사례를 FDE in Action이라는 섹션으로 따로 묶었어요. FDE(Forward Deployed Engineer)는 고객 현장에 들어가 AI를 실제 업무에 붙이는 엔지니어를 부르는 말입니다.
- 금융: MCP 도구 90개로 중국 A주, 홍콩과 미국 주식, 채권, 펀드, 파생상품 데이터를 모으고, CSI 300 지수 선물 사례에서 이론 베이시스를 계산해 엑셀과 편집 가능한 파워포인트로 넘겼다고 합니다. 엑셀 셀의 링크를 누르면 원자료로 가고, 파워포인트 차트는 엑셀 숫자와 하나씩 맞물리게 했어요.
- 법률: 고객이 여러 번에 나눠 보낸, 이름과 형식이 제각각인 상장 전 실사 서류 198개를 14개 폴더로 나누고 색인을 만든 뒤 공개 기록과 대조해, 86쪽에 중국어 6만 자가 넘는 보고서를 썼다고 합니다. 결론마다 근거 서류를 인용으로 달았다고 해요.
- 의료: 경동맥 스텐트 시술 뒤 심실세동이 온 중환자의 검사 결과 수십 건, 1만 자가 넘는 경과 기록, 원본 영상 1,433장을 한 대화 안에서 정리했습니다. 하위 에이전트 여러 개가 흉부 CT 단면 수백 장을 나눠 읽었고, 담당 의사의 진단과 같은 소견을 냈다고 밝혔습니다.
세 사례 모두 사람이 결과를 다시 확인할 수 있게 출처를 붙인 점이 같습니다. 다만 모두 Qwen 팀이 고른 시연이고, 실제 현장에서 얼마나 자주 이렇게 되는지는 발표 글에서 찾지 못했습니다.
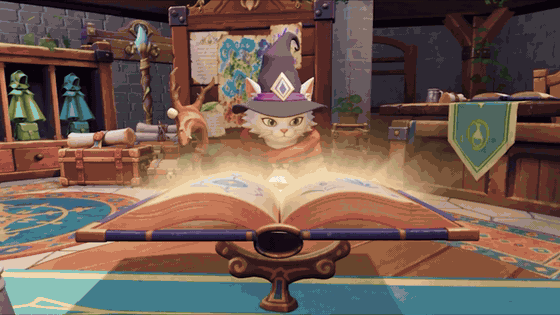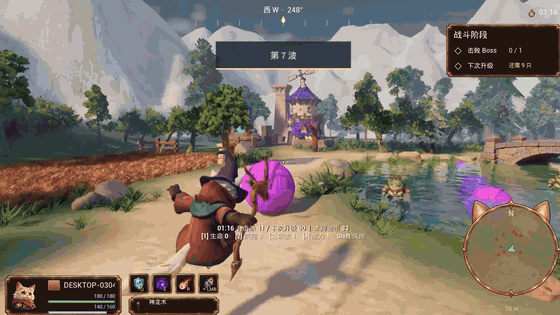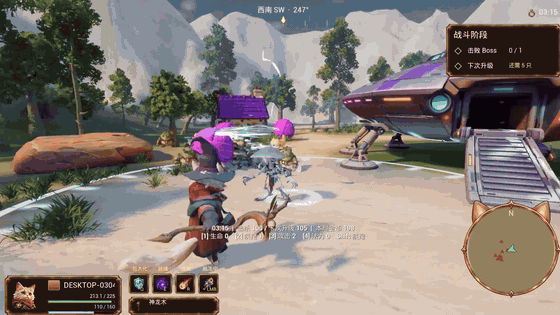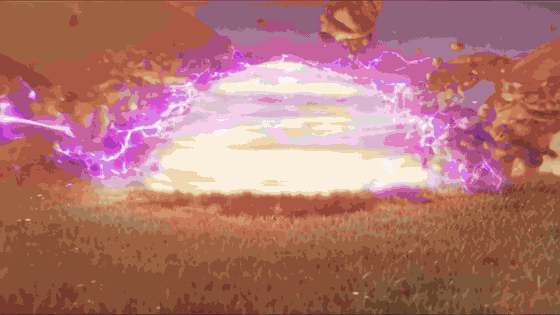
Qwen4-Max가 Unreal Engine으로 고양이 마법사 게임을 만들었습니다.
Qwen 팀은 Qwen4-Max가 Unity, Unreal Engine, Godot을 다룬다고 밝혔습니다. 자연어 요청 하나를 받아 장면, 게임 규칙, 외부 에셋, HUD, 효과를 넣고, 직접 게임을 돌려 보면서 카메라와 캐릭터 애니메이션, 타격감을 고쳤다고 해요. 고양이 마법사가 주문을 고르며 적과 보스를 상대하는 Meow of Magic이 그 결과물입니다.
제조 현장 사례도 있습니다. 자동차 부품 회사 SANF와 Pacific Union의 실제 생산 환경에서 생산 라인 3D 모델링부터 부품 설계, 가공 경로 검증까지 맡겼고, 부품 하나를 가공하기 위한 프로그래밍 작업이 약 475분에서 24분으로 줄었다고 합니다.
긴 작업에는 Live Delivery라는 방식을 씁니다. 일을 다 끝낸 뒤 한꺼번에 보여 주지 않고, 쓸 만한 첫 버전을 일찍 내놓은 다음 고친 버전을 계속 내놓는 방식이에요. 사람은 중간 버전을 보고 언제든 실수를 바로잡거나 방향을 바꿀 수 있습니다. 이 방식을 쓰는 Qwen-Live-Delivery-Plugin은 오픈소스로 공개했어요.
Qwen4-Max의 가중치는 공개하지 않았습니다.
Qwen4-Max는 QwenCloud API로만 쓸 수 있는 모델입니다. 해커뉴스에서도 바로 내려받아 쓸 수 있는 줄 알았다가 가중치가 없다는 걸 알고 아쉬워하는 댓글이 있었어요. 대신 Qwen 팀은 같은 세대의 기법으로 학습한 더 작은 Qwen4 모델들을 오픈소스로 내겠다고 밝혔습니다. 날짜는 나오지 않았고, 해커뉴스에서는 27B 크기 모델을 기다린다는 댓글이 이어졌습니다.
Qwen4-Max는 전작보다 Artificial Analysis 지수가 9점 오르고 과제당 비용은 3분의 1로 줄었습니다. 그래도 코딩에서는 Opus 5.5, Kimi K3.1과 차이가 남아 있어서, 지금은 Qwen 팀이 강조한 법률이나 긴 업무 쪽에서 먼저 쓰임새를 확인하게 될 것 같습니다. 오히려 더 큰 관심은 같은 기법으로 만든 작은 Qwen4 모델이 언제, 얼마나 잘 나올지에 모일 듯싶습니다.