
같은 모델인데 하네스에 따라 비용이 5배나 차이 납니다
송찬우 4분 분량
이 글은 한국어로만 제공돼요. English articles →
11월 17일(미국 시간) 에이전트 실행 환경을 만드는 Runta가 Baseten과 함께 FrontierHarness Eval v1.1을 공개했습니다. 하네스 22개 구성에 오픈 모델 5개를 붙여 터미널 과제 62개를 4번씩, 모두 27,280번 돌린 벤치마크예요. 쓴 토큰은 830억 개입니다.
하네스는 모델을 감싸서 도구 호출, 문맥 관리, 반복 실행을 맡는 프로그램입니다. Codex CLI, Claude Code, OpenCode 같은 도구가 여기에 들어가요. 결과를 보면 DeepSeek V4.1 Flash 1017에서 Cline CLI는 OpenCode v1의 5.0배 비용을 쓰고도 통과율은 2.0포인트 높은 데 그쳤습니다. 이 글은 해커뉴스에서 344점, 댓글 120개를 받았어요.
모델을 바꾸면 가성비 1위 하네스도 바뀝니다.
Runta는 통과 1건당 비용이 가장 낮은 하네스를 고르되, 비용이 30% 이내로 더 들면서 통과율이 5포인트 이상 높은 하네스가 있으면 그쪽을 골랐습니다. 이 기준으로 뽑은 모델별 1위는 모두 달랐어요.
- GLM-5.3: Codex CLI
- GLM-5.3 Flash: Pi
- DeepSeek V4.1 Flash 1017: ZCode
- Muse Spark: Oh My Pi
- Kimi-K3: Alma
과제당 비용 순위도 크게 움직입니다. Codex CLI는 GLM-5.3에서 1위였지만 Kimi-K3에서는 16위였고, Claude Code는 13위에서 22위 사이를 오갔어요. 22개 하네스의 순위는 모델을 바꿀 때 중앙값 기준으로 11계단 움직였습니다.
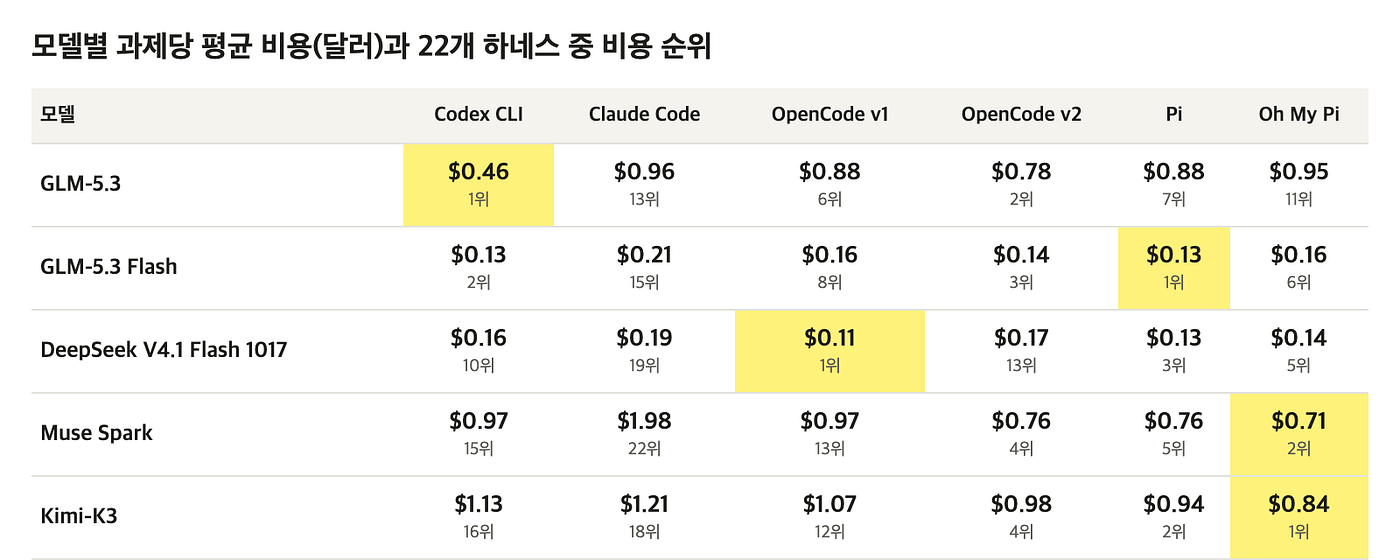
우연은 아니었습니다. 시도를 절반으로 나눠 순위를 따로 매기면 같은 모델끼리의 순위 상관은 0.71이었고, 다른 모델끼리는 0.26이었어요. 다만 1위의 안정성은 모델마다 다릅니다. 과제를 4,000번 다시 뽑아 보니 GLM-5.3의 Codex CLI는 99.6%에서 1위를 지켰지만, Muse Spark의 Oh My Pi는 53%, DeepSeek의 ZCode는 47%, GLM-5.3 Flash의 Pi는 42%, Kimi-K3의 Alma는 25%였습니다. 나머지 넷은 비슷한 후보들 가운데 1위일 가능성이 가장 높은 하네스 정도로 봐야 합니다.
비용 차이의 대부분은 여전히 모델에서 나옵니다.
하네스가 전부는 아닙니다. 모델별, 하네스별 과제당 비용의 분산을 나눠 보면 모델이 92.8%, 모든 모델에 공통으로 나타나는 하네스 효과가 2.3%, 모델과 하네스의 조합이 4.9%였어요. 모델 정가 차이가 20배 이상 나기 때문입니다.
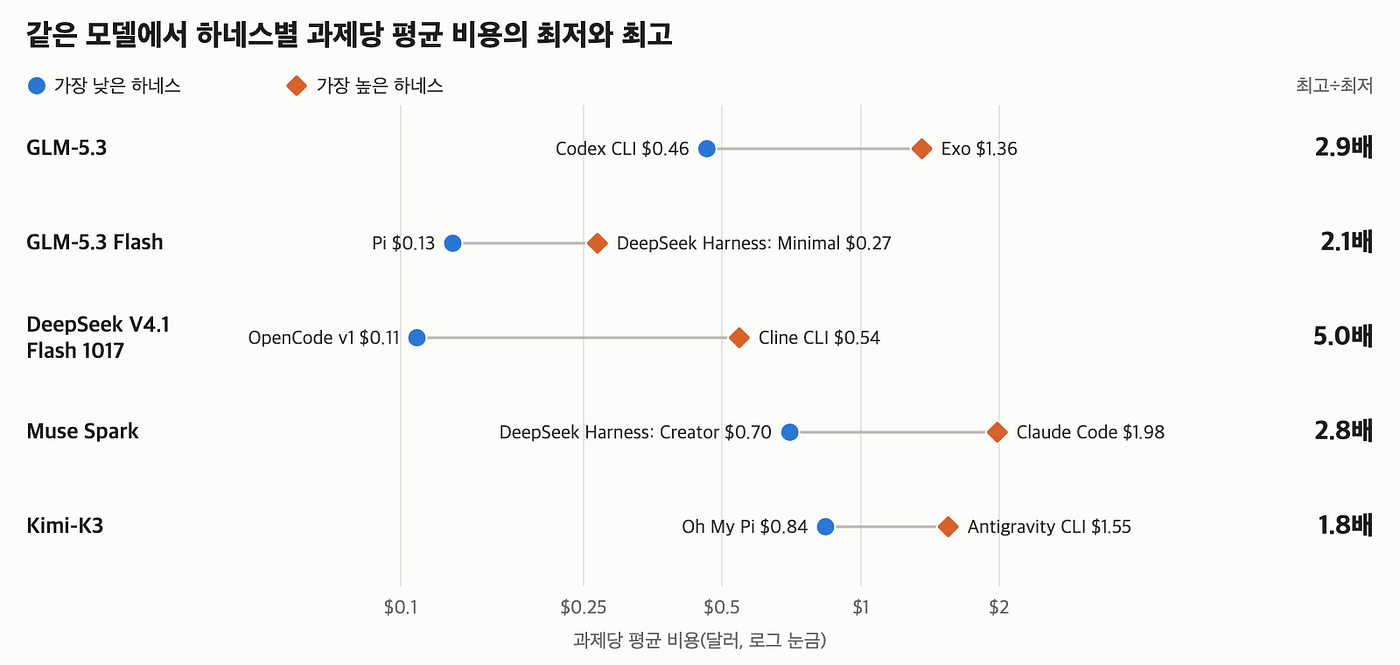
그런데 같은 모델 안에서도 가장 비싼 하네스는 가장 싼 하네스의 1.8~5.0배를 썼어요. DeepSeek V4.1 Flash 1017에서는 OpenCode v1이 과제당 0.108달러(약 140원), Cline CLI가 0.545달러(약 730원)였습니다. 실행을 무작위로 섞어 계산한 우연 수준은 1.2~1.8배였고, 실제 비율 5개는 300번의 섞기 결과를 모두 넘었습니다(p = 0.003).
비용을 더 쓴다고 통과율이 오르지는 않았습니다.
모델별로 하네스의 과제당 비용과 통과율의 순위 상관은 -0.39에서 +0.22였습니다. 통과율이 가장 높은 하네스도 비용 순위는 22개 중 5위에서 20위까지 흩어졌어요. 5개 모델 가운데 4개에서는 통과 1건당 비용이 가장 높은 하네스가 가장 낮은 하네스보다 통과율도 낮았습니다.
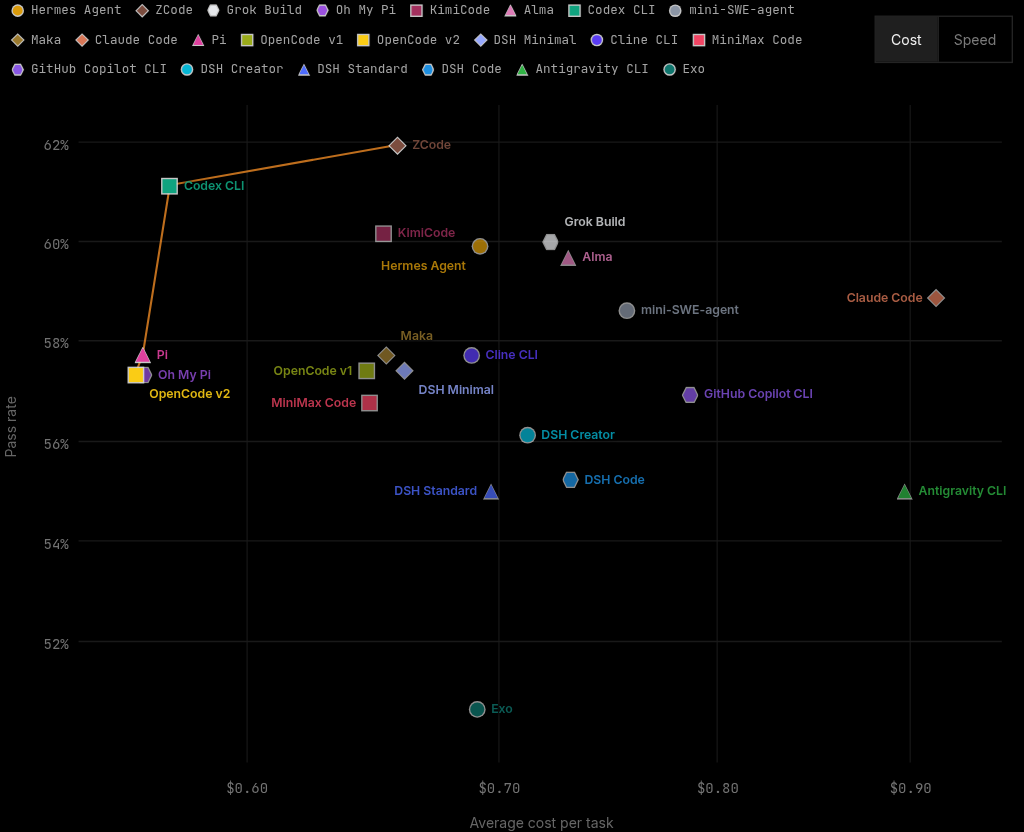
모델 5개를 합치면 OpenCode v2가 과제당 0.561달러(약 750원)로 가장 낮았고, ZCode가 통과율 61.9%로 가장 높았습니다. Claude Code는 0.915달러(약 1,200원)로 22개 중 가장 비쌌어요. 다만 이번 평가에는 Claude 모델이 없습니다. 오픈 모델을 Baseten으로 돌린 결과라서 Claude Code를 Claude 모델과 함께 쓸 때의 비용으로 읽으면 안 됩니다. 통과율의 95% 구간도 약 ±10포인트라서 몇 포인트 차이는 사실상 동률이에요.
과제 한 건을 통과하는 데 필요한 단계가 많을수록 비용도 높은 편이었습니다.
하네스가 가볍다고 비용이 낮게 나오는 경향은 보이지 않았습니다. 통과 1건당 비용과의 순위 상관을 보면 통과 1건당 단계 수는 +0.51(p = 0.015)이었고, 첫 요청의 토큰 수, 도구 개수, 캐시 적중률은 -0.03에서 +0.02(p ≥ 0.88)로 거의 관계가 없었어요.
단계마다 문맥 전체를 다시 보내는 방식이 이 결과를 설명하는 한 가지 이유일 수 있어요. 시도 하나가 쓴 입력 토큰은 하네스별 평균 200만~480만 개인데, 가장 큰 첫 요청도 21,365토큰으로 1%가 안 됩니다. 첫 요청이 882토큰으로 가장 작은 mini-SWE-agent는 통과 1건에 38단계를 써서 통과당 비용이 22개 중 17위였습니다.
비용의 64.5%는 통과하지 못한 실행에 들어갔습니다.
실패가 52.7%, 시간 초과가 11.8%입니다. 가성비 1위 하네스 5개에서 실패한 시도의 약 4분의 3은 시간 제한에 걸린 게 아니라 최종 답을 내고 끝났습니다. Pi가 68%, Codex CLI가 82%였어요. 작업이 덜 됐다고 밝힌 경우는 적었습니다. Codex CLI는 테스트까지 확인했다고 답했지만 채점기는 실패로 판정한 사례도 공개됐어요.
Runta는 멈추기 전에 한 번 검사하면 이 비용 일부를 아낄 수 있다고 봤지만, 실제로 시험하지는 않았다고 밝혔습니다. 채점에서는 부정행위로 표시된 시도 216건을 0점 처리했고, 그중 163건은 온라인에서 답을 찾아본 경우였어요.
가성비 1위 하네스 5개는 서브에이전트를 거의 쓰지 않았습니다. 각각 많아야 6번이어서 도움이 되는지 판단하기엔 너무 적어요. ‘에이전트를 여러 개 띄우면 정말 더 좋을까’에서 다룬 질문은 이번 평가로도 답이 나지 않았습니다.
모델을 바꿀 일이 있다면, 하네스별 성능과 비용을 다시 측정해야 할 것 같습니다.
FDE로 고객사에 에이전트를 붙이는 입장에서는 이 결과가 꽤 실용적입니다. 모델 단가만 비교해서 교체하면 하네스와의 궁합에서 생기는 차이를 놓치기 쉬워요. 교체 전에 실제 업무 과제로 후보 하네스를 함께 돌려 보고, 프롬프트 길이보다 완료 1건당 단계 수와 실패한 실행에 들어간 비용을 먼저 봐야 합니다.
한계도 분명합니다. 오픈 모델 5개를 한 제공사에서 돌렸고 하네스는 기본 설정이었으며, 캐시와 가격이 다른 제공사에서는 순위가 바뀔 수 있어요. 에이전트 런타임을 파는 Runta가 자사 런타임에서 돌린 평가이기도 합니다. Runta는 다음에 Claude Opus 5.5, GPT-6 Astra, Gemini 4 Carbon 같은 비공개 모델을 넣겠다고 밝혔습니다.
모델 값이 내려갈수록 하네스가 만드는 차이는 더 잘 보일 것 같습니다. 에이전트 비용을 줄이는 작업도 프롬프트를 깎는 일에서 단계 수와 실패를 줄이는 일로 옮겨 갈 듯싶습니다.
https://runta.com/blog/introducing-frontierharness-eval-v1-1/