
ChatGPT가 자율주행차에 들어간다면
송찬우 6분 분량
요즘 중국에서 나오는 오픈소스 AI 모델들이 굉장히 화두인데요. 뉴스에도 나왔던 유명한 Deepseek 모델부터, Qwen, Kimi, GLM, 그리고 요즘 경쟁자가 없을 정도의 Seedance (오픈소스는 아닙니다)까지. 전부 중국에서 나온 AI 모델입니다. 이외에도 저희가 다 외우지 못할 정도로 굉장히 많은 모델들이 중국에서 나오고 있는데요.
어제 (9/3), Qwen 팀에서 발표한 논문이 꽤 재밌어 공유해봅니다.
모델의 이름은 Qwen-Drive-1.0인데요. 이러한 연구들을 VLA (Vision + LLM + Action) 이라고 부릅니다.
기존의 VLA 연구들은 한계점이 명확했습니다.
첫째, LLM의 멀티모달(이미지 읽는 능력)로만 판단해 “앞에 차가 있으니 제동해야 합니다”, “우회전 해야합니다” 와 같이, 텍스트로만 지시를 내릴 수밖에 없었습니다.
둘째, LLM이기 때문에 운전과 같은 특정 상황들에 대해서 학습을 과도하게 (Fine-tuning) 시킬 경우, 일반 상식을 잘 잊어버리는 ‘재앙적 망각(Catastrophic Forgetting)’이라는 현상을 겪게 된다고 합니다. 이런 문제가 심각해지면 표지판, 야생동물 출몰 등 돌발 상황에 대해서 판단하기에 약점이라고 합니다.
셋째, 실제 차량에 적용할 때, 차량의 GPU를 운전만 할 줄 아는 용도로 써야합니다. 요즘 차량 같은 경우엔 발화만으로 목적지를 설정해주고, 서로 대화를 할 수 있는 인포테인먼트 AI가 점점 더 도입되고 있는데요. 기존 연구들은 운전에 초점을 맞췄었다고 합니다.
Qwen 팀은 이러한 문제를 해결하기 위해서 기존의 Qwen 3.5 모델 (4B, 준경량화)에 3D 정보를 담아 같이 추론하는 아키텍처를 설계했다고 합니다.
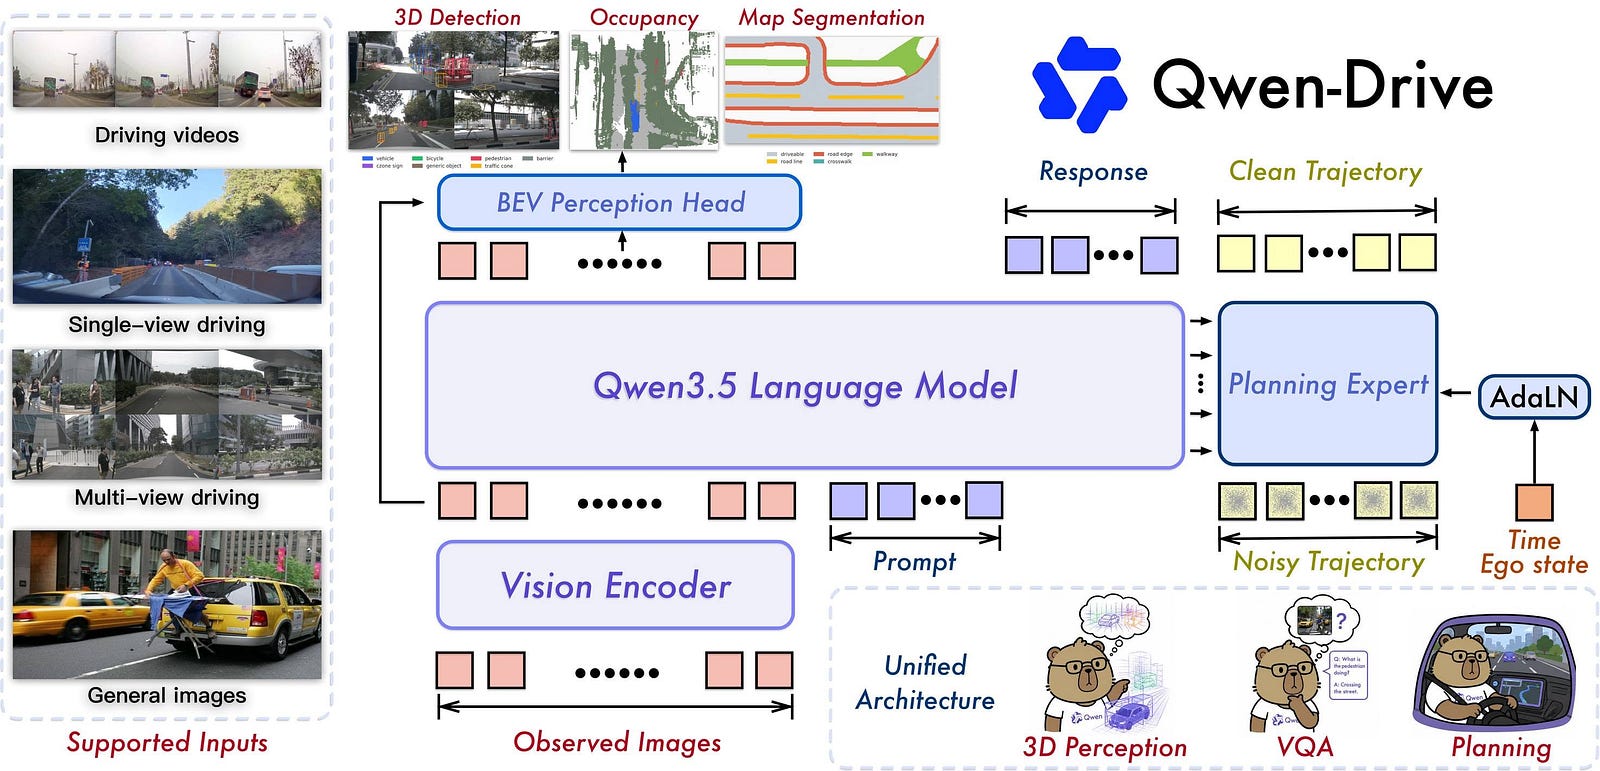
동시에, 추론 후 정확히 어떻게 움직여야 할지 구체적인 Waypoint 50개를 생성하도록 설계했다고 말합니다.
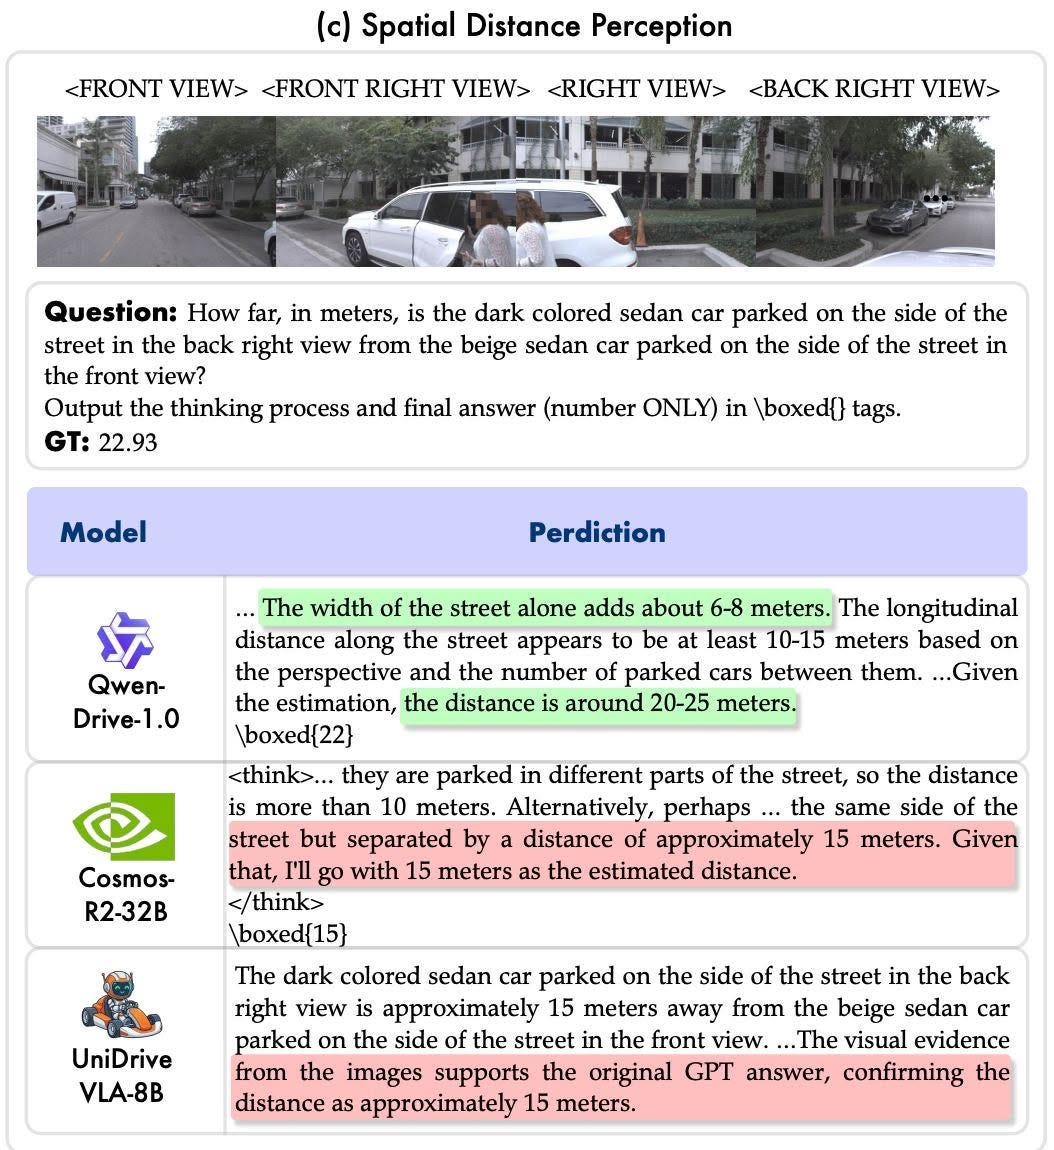
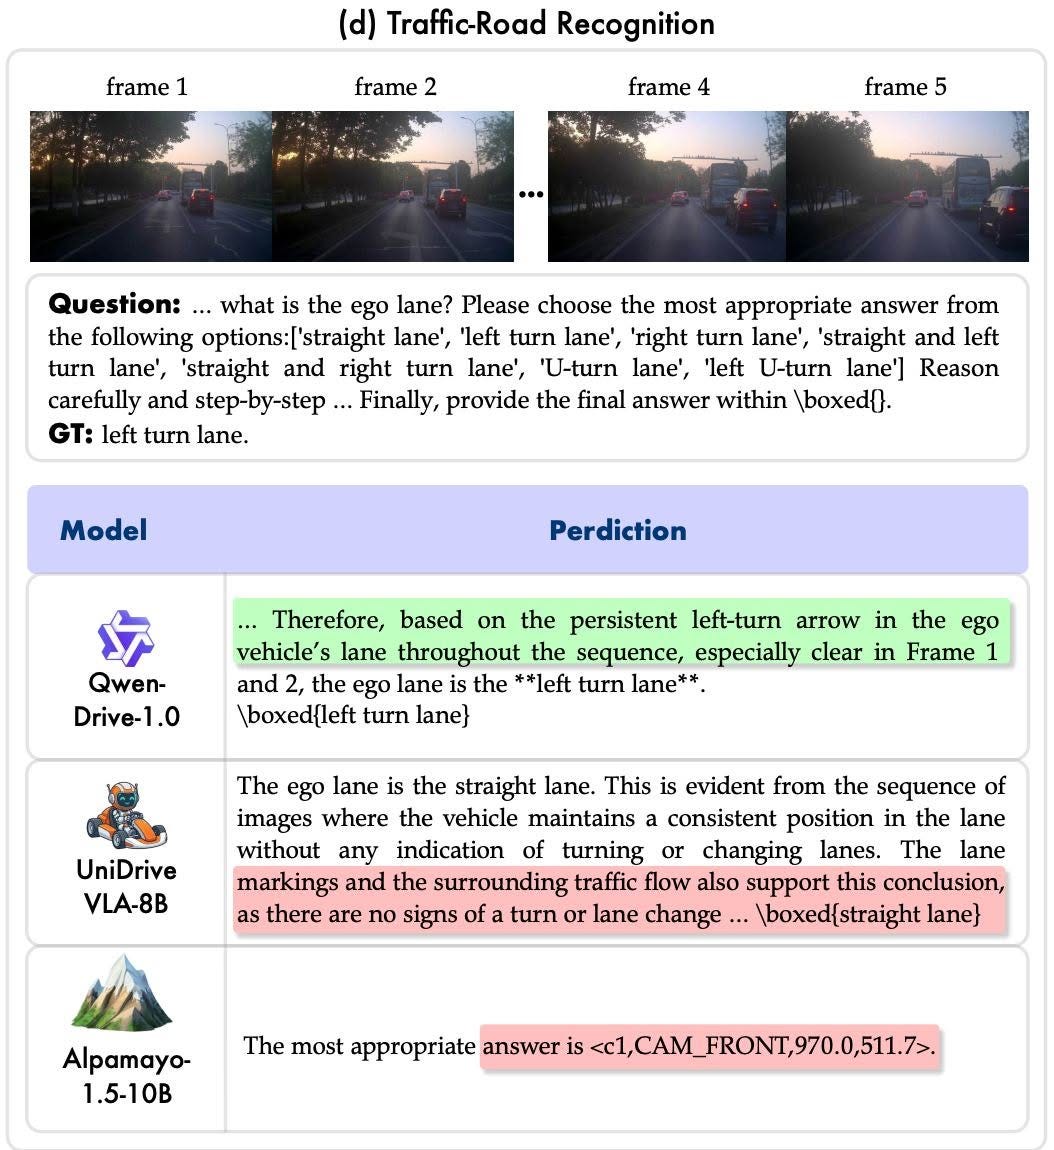
아래 사진을 보면, Qwen을 포함한 AI 모델들에게 “(여러 장의 사진을 주며) 이 사진들은 차례대로 방금 5초동안의 주변 사진들이야. 단일 사진만으로 판단하지 말고, 사진들의 시퀀스와 역동성을 고려해 주차된 차량이 몇 개인지 알려줘.”라고 질의합니다. (GT = Ground Truth, 정답에 해당하는 값. Zero/None이라고 해야 답이라고 설명하고 있음.)
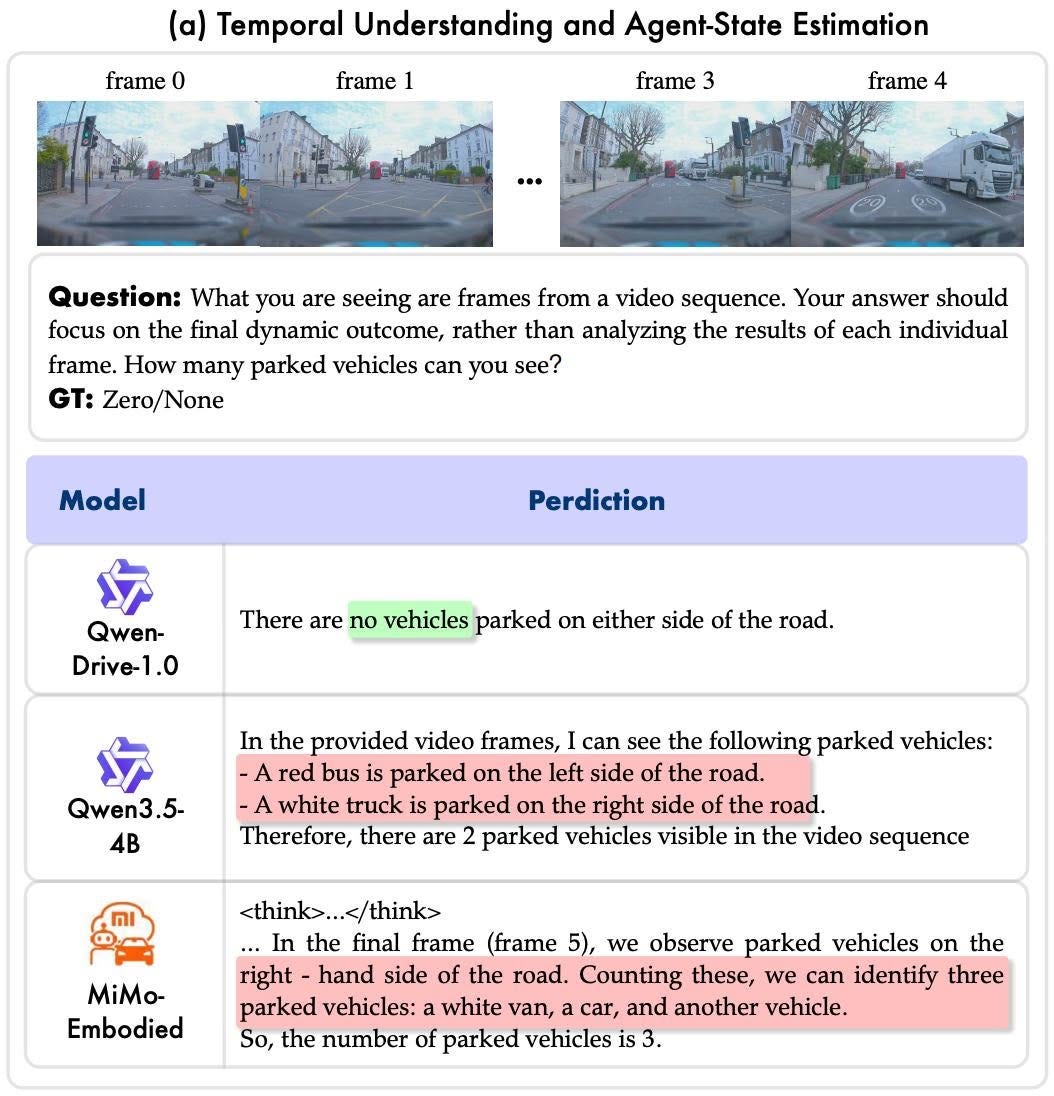
Qwen 모델의 경우, 주차된 차량이 없다고 말합니다. 자세히 보시면, 차량들이 전진하고 있는 상황인 사진인데요. 특히 옆에 하얀 트럭이 주차된 게 아니라 시간에 따라서 점점 가까워지는 것을 보니, 차량을 추월(이동)하고 있는 모습을 보실 수 있습니다.
다만 다른 모델들은 “빨간 버스가 정차해있습니다”, “하얀 트럭이 오른쪽 길에 정차해있습니다”라고 대답하는 모습을 볼 수 있습니다.
다른 비교 사진들도 한번 구경해보세요^^ 사진들을 보고 각각의 모델들이 어떻게 대답하는지를 나타낸 게 재밌네요.
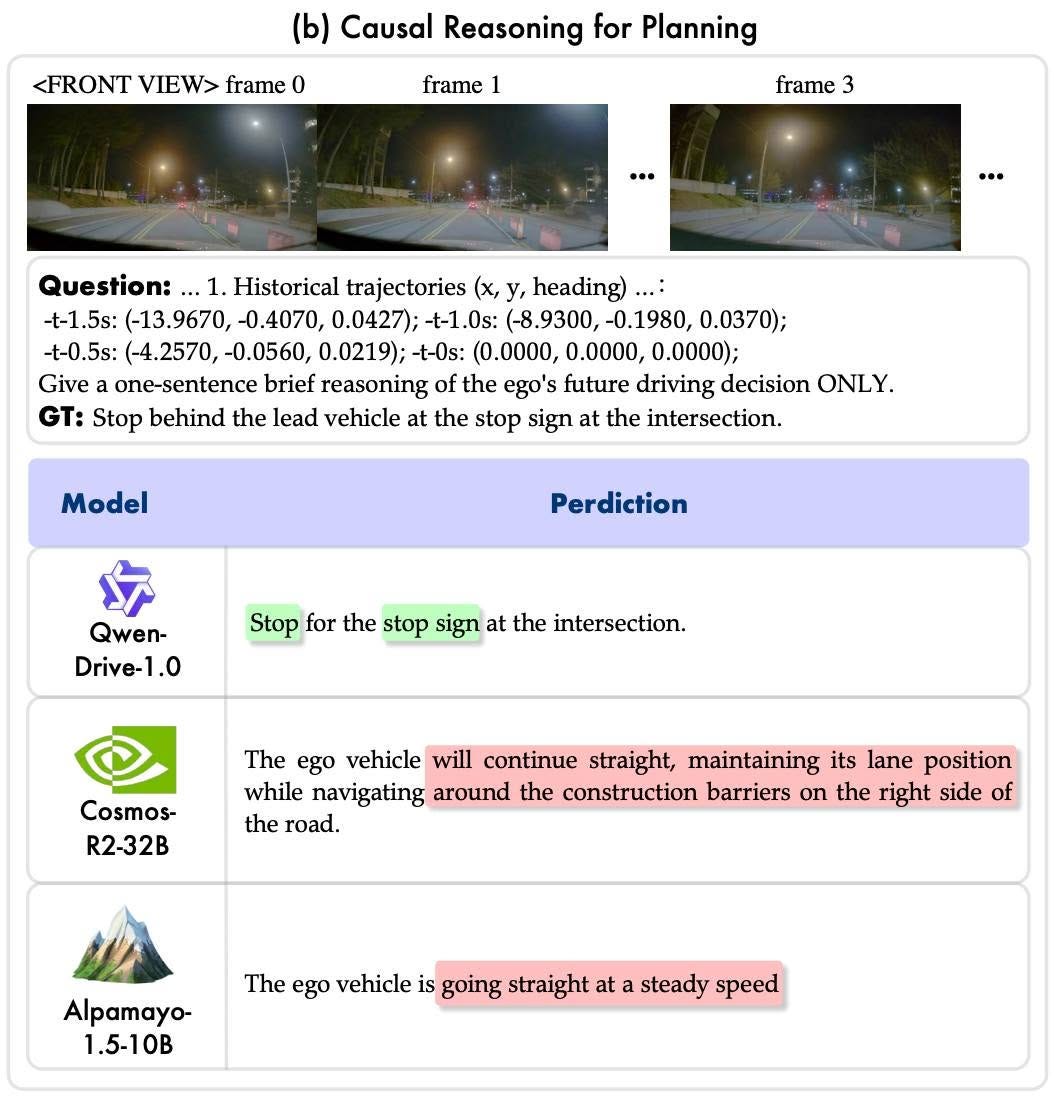
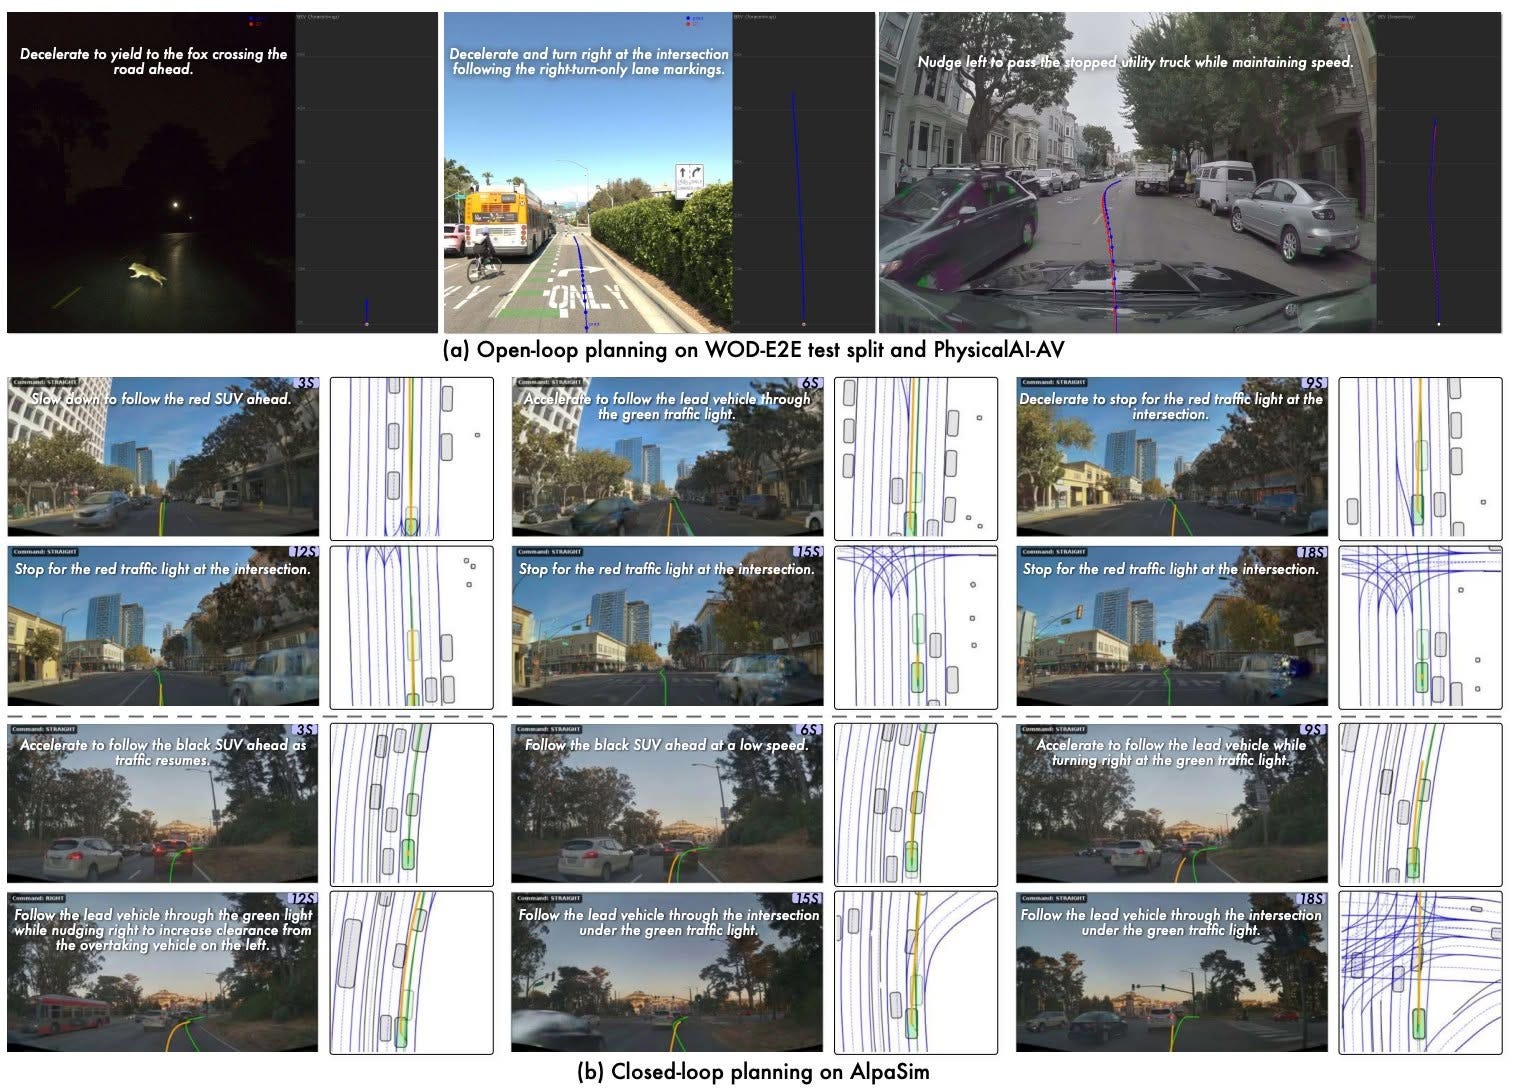
아래 사진은 돌발상황, 평소 운전하는 상황에서 AI가 어떻게 지시하는지 (“여우가 나타나 감속하세요”, “감속하고 우회전하세요” 등), 실시간으로 어떤 방향으로 차량이 이동해야 하는지 이동 포인트들을 시각화한 사진입니다. 수치들보다, 이런 Figure에 시각화된 걸 보는 게 더 재밌네요 ㅎㅎ
단순히 중국 회사들이 LLM 모델들을 모두 오픈소스로 공개해 점점 더 발전 속도가 가속화되고, 프론티어 모델에 근접하는 모델들이 나오는 것이 정말 놀라운데요. Qwen 팀은 본인들의 모델을 홍보하는 차원에서라도, “우리 모델을 자율 주행 기술에 적용하니 이런 좋은 성능이 나왔다”라고 말함과 동시에, 자율 주행 기술 분야에 LLM을 도입하는 재밌는 시도들이 흥미롭네요!
#Qwen #QwenDrive #LLM #VLA #AutoDriving
블로그: https://qwen.ai/blog?id=qwen-drive-1.0
논문: https://arxiv.org/abs/2609.00111
논문에서 말한 한계점 같은 경우엔, 아래 세 가지로 설명하고 있습니다!
첫째, 즉각성에 대한 판단 부족.
갑자기 돌발적으로 나타난 상황에서는 급제동을 해야하고, 멀리서 신호가 빨간불이 돼 천천히 감속해야 하는 상황처럼, 어떤 시간적 범위(Temporal scope)로 행동을 취해야 하는지에 대한 불안정하다고 합니다.
둘째, 추론하는 텍스트와 생성하는 실시간 궤적 간의 불일치 문제.
말로 설명하는 주행 근거(“앞차를 따라 감속합니다”)와 실제로 차가 그리며 나아가는 물리적 궤적(선)이 항상 100% 완벽하게 일치하지는 않는다고 합니다. 생각한 이유와 손발(핸들 조작)이 따로 놀 때가 있어, ‘말한 이유대로 실제로 운전했는가’에 대한 인과적 일관성을 강제하는 장치가 더 필요하다는 지적입니다.
셋째, 작업(Task)별 입력 방식의 차이로 인한 상호 시너지 한계.
현재 모델은 3D 인지, 대화(VQA), 운전 계획(Planning)을 한 몸에서 처리하지만, 각 작업을 수행할 때 들어가는 카메라 해상도나 참조하는 영상 프레임 수 같은 입력 조건들이 제각각 나뉘어 있습니다. 이 설정들이 완전히 하나로 통일되지 않다 보니, 눈으로 보고(인지) 말로 생각하고(추론) 직접 운전하는(계획) 각 기능들이 서로를 더 완벽하게 밀어주고 끌어주는 데는 아직 한계가 있다고 합니다.