
학습할 데이터는 다 떨어졌을 텐데, AI는 왜 더 좋아질까
송찬우 5분 분량
요즘 Claude Code나 Codex 같은 AI 코딩 도구 쓰시는 분들 많으시죠. 그런데 이게 몇 주 간격으로 계속 뒤집힙니다. Fable 5.1이 출시된지 얼마나 됐다고, 모두가 Fable 5.1이 정말 좋다고 말하다가도, Astra 출시가 또 분위기를 바꿔냈습니다.
여기서 궁금한 점이 하나 생깁니다. 인터넷에서 계속 데이터를 가져오는 것도 한계가 있고, 사람이 쓴 코드들을 이미 다 학습해버린 것도 옛날 일일 텐데, 어떻게 AI들은 계속 성능이 좋아지는 걸까요?
실제로 업계에서는 2026년 기준 고품질 인간 텍스트가 사실상 고갈됐다는 표현을 씁니다. 소위 ‘데이터 월(Data Wall)’인데요. 인터넷은 유한하니까요. 그런데 성능은 계속 오릅니다. 궁금해서 최근 중국 오픈소스 모델들을 만드는 기업의 기술 논문, 블로그(보고서)를 찾아보니 힌트를 찾을 수 있었습니다.
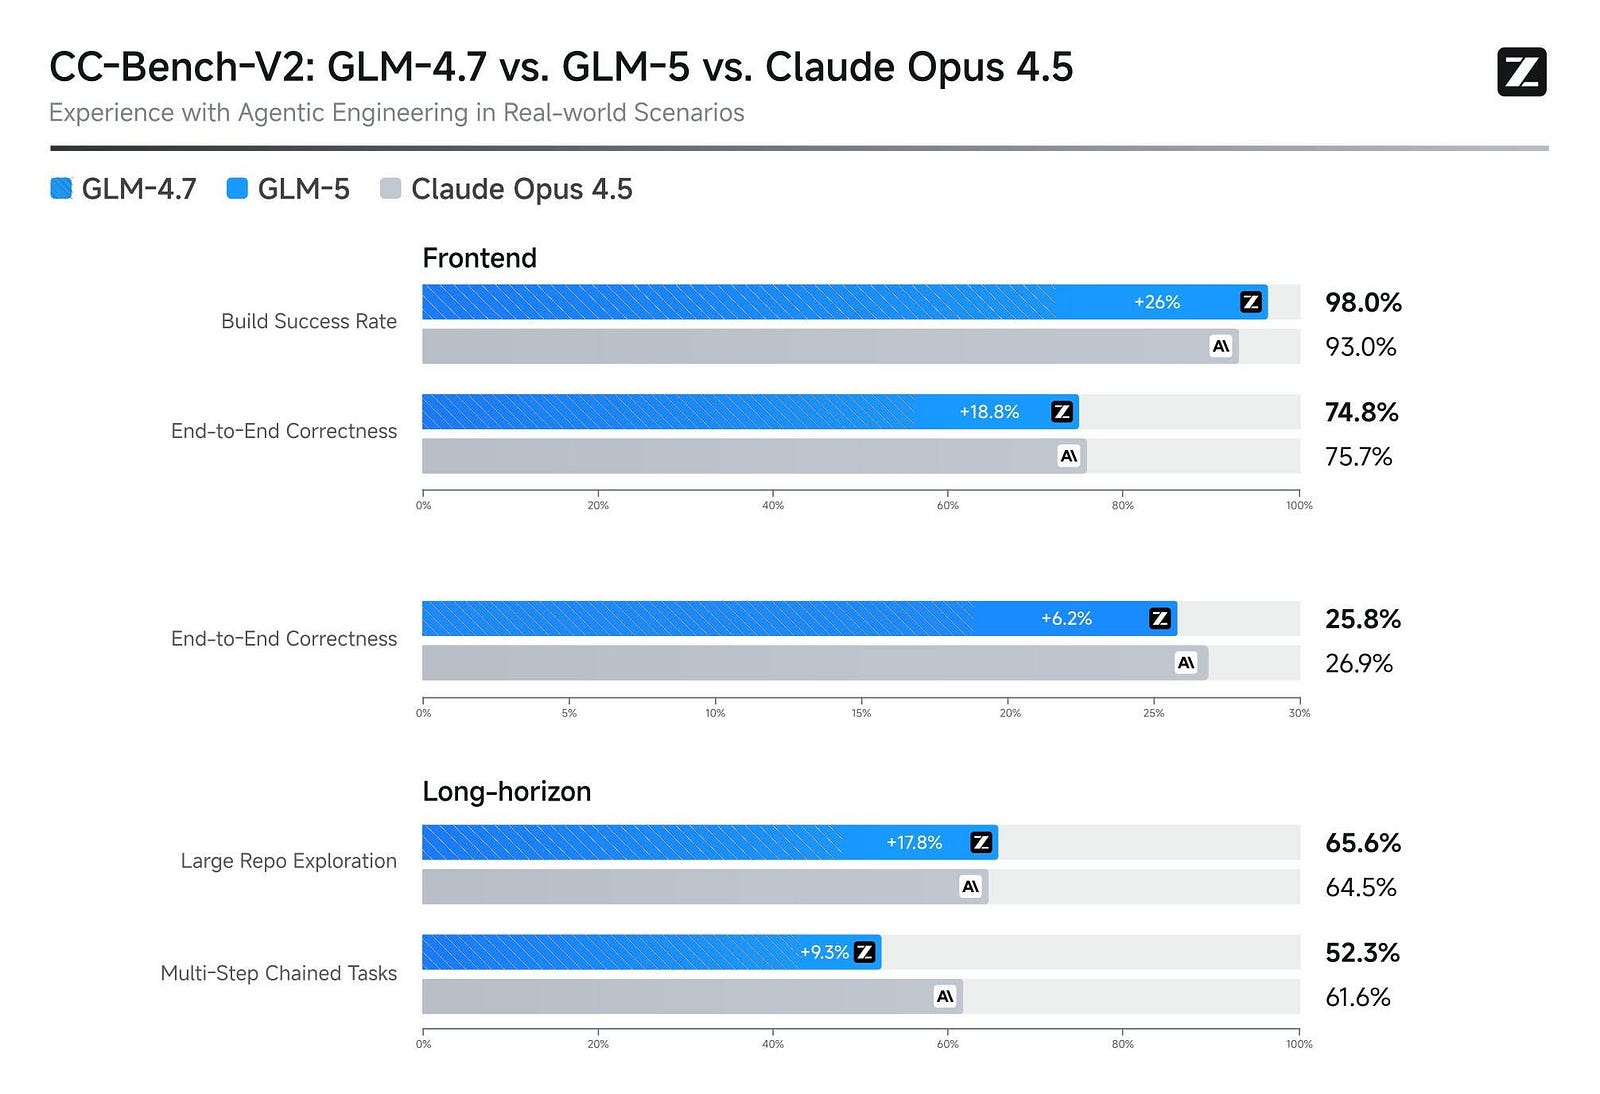
지난달(8/14) Z.ai는 GLM-5.3을 공개했습니다. 이 모델, 베이스 모델이 직전 버전인 GLM-5.2와 완전히 동일합니다. 사전학습을 새로 돌리지 않았어요. 그런데 자체 평가 기준으로, 50%의 성능 향상이 있었다고 말합니다.
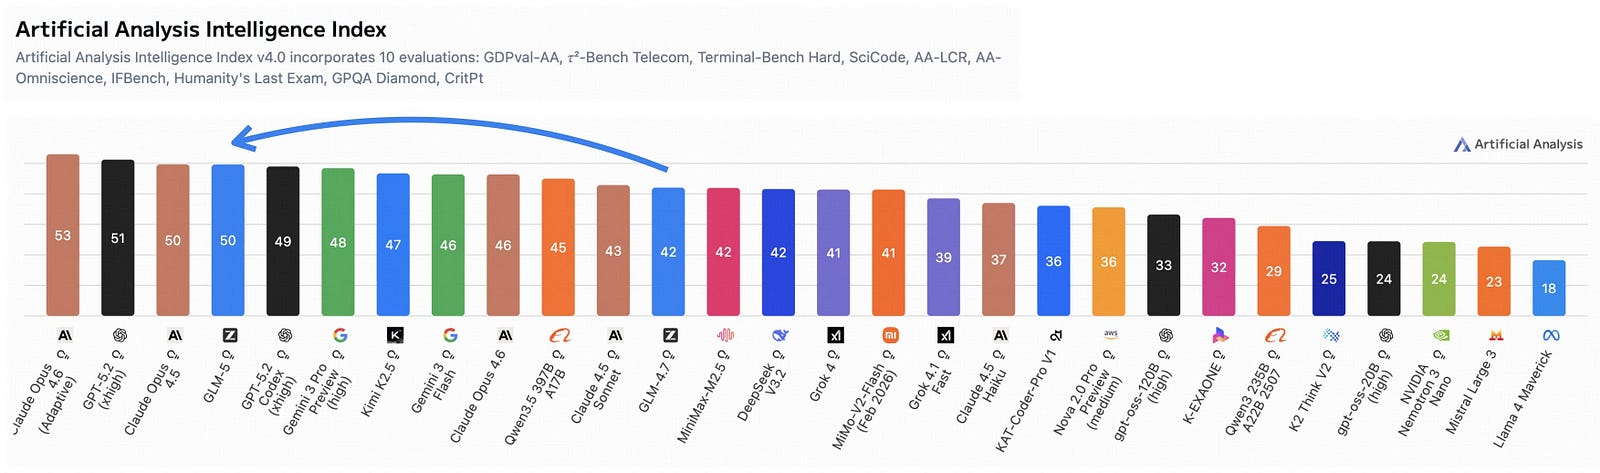
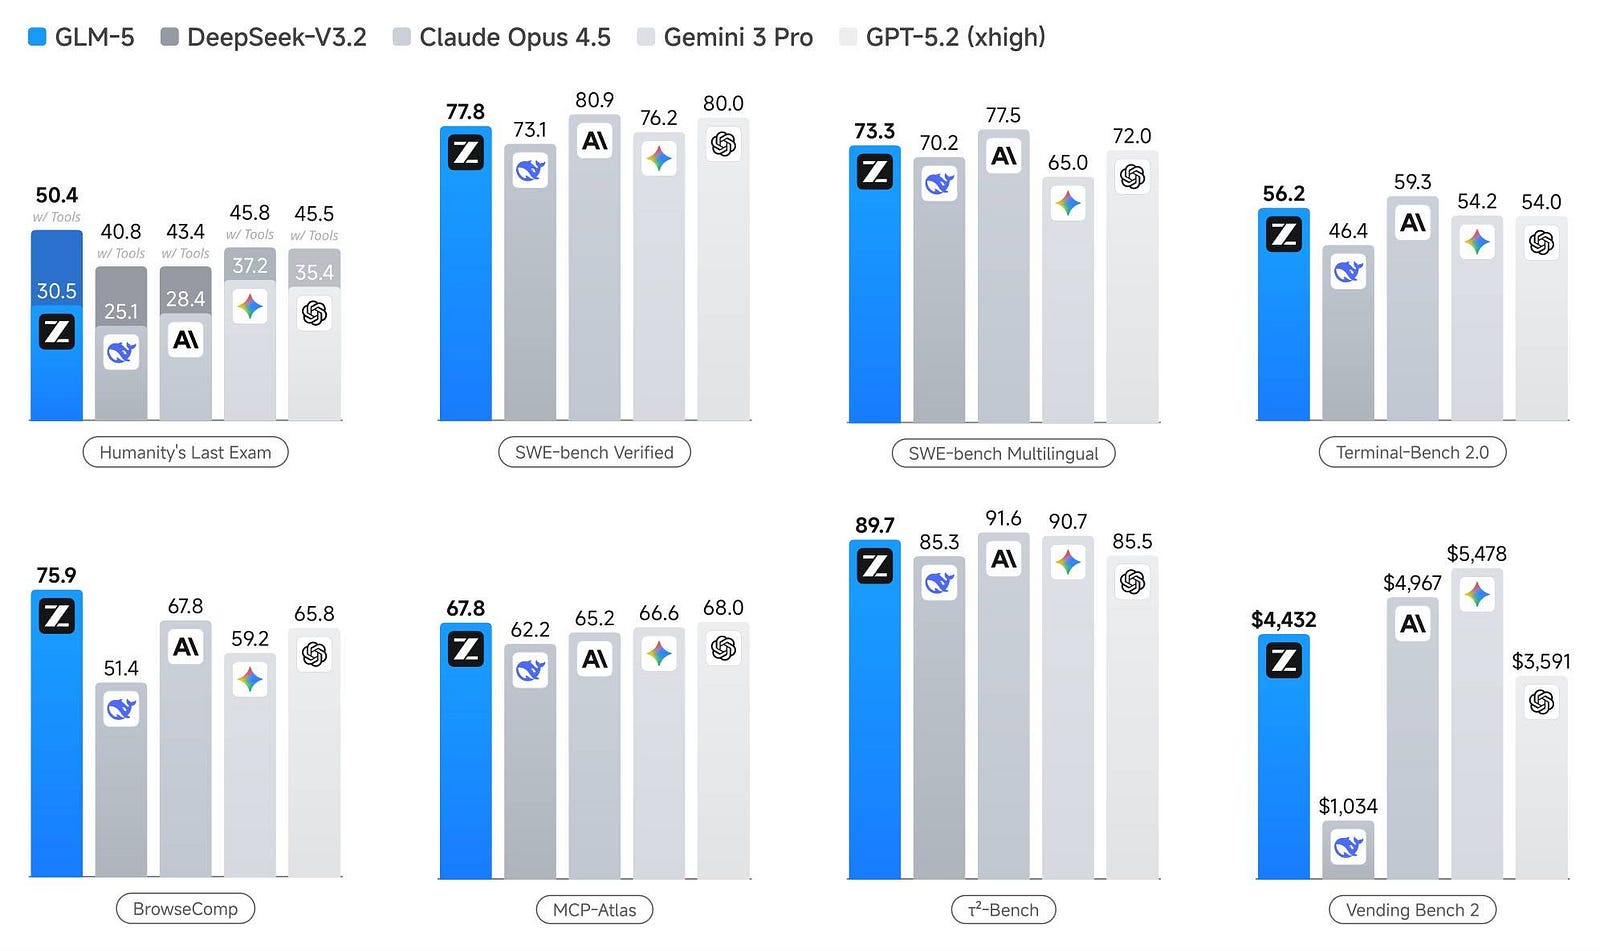
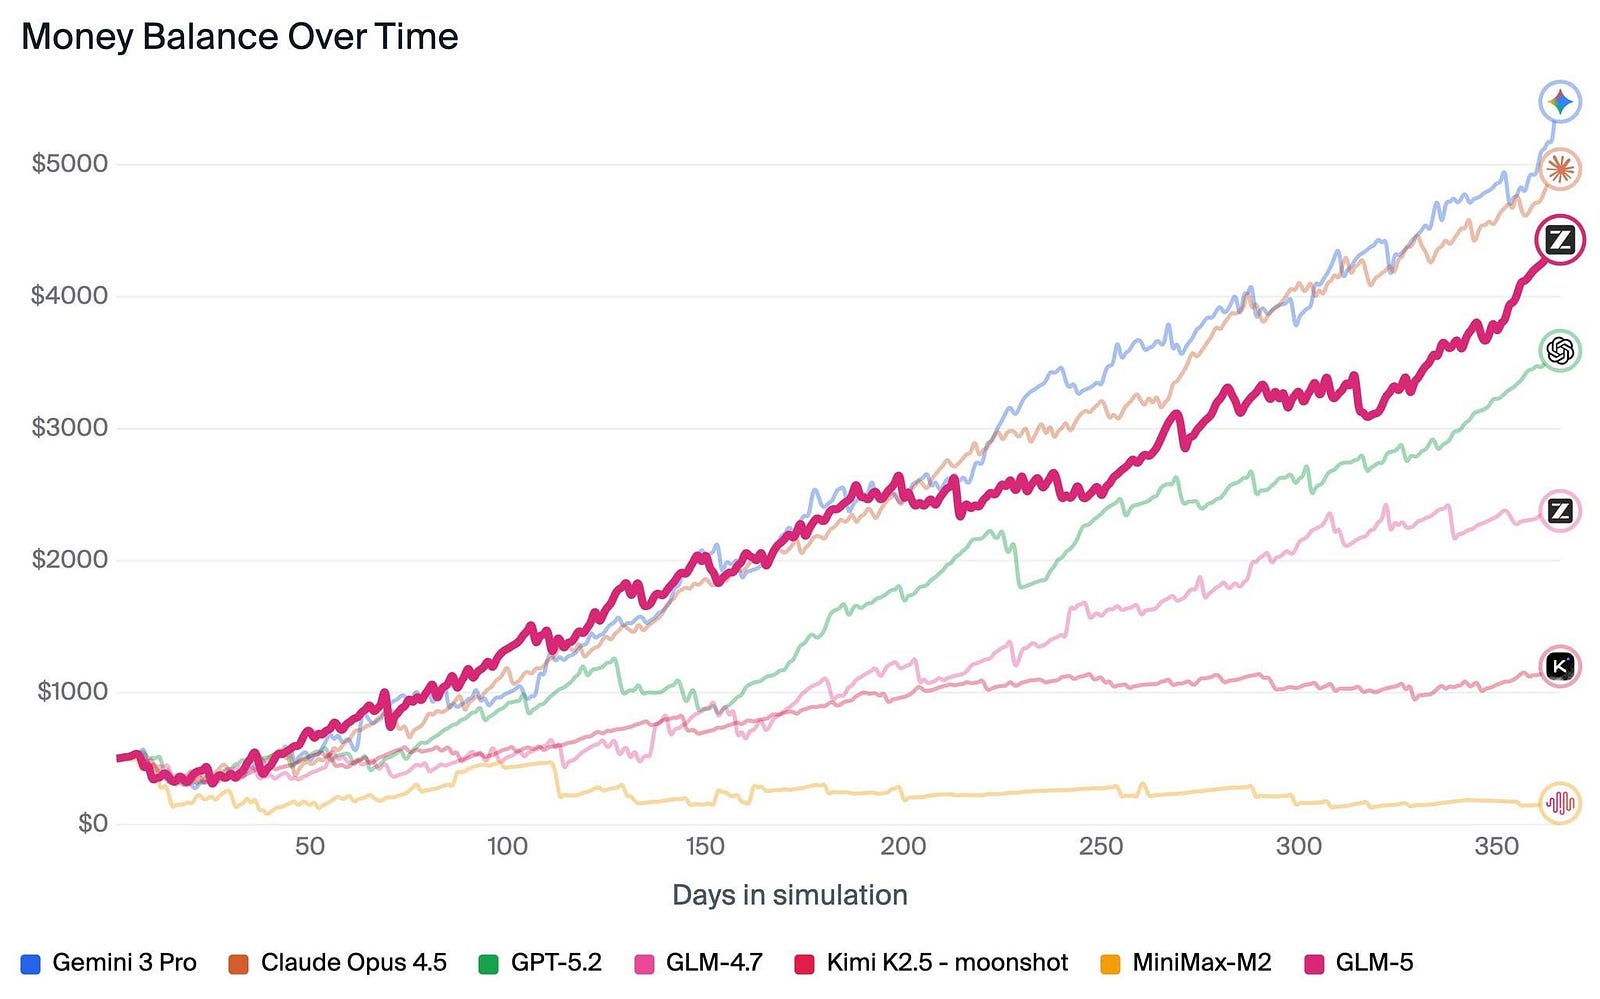
Z.ai에서 밝힌 이유는 딱 하나였습니다. “수십 배 많은 장기 과제(long-horizon) 환경, 더 다양한 환경 종류, 더 긴 사후학습(post-training) 기간.” 새 데이터를 긁어온 게 아니라, 모델이 스스로 굴러다니며 배울 놀이터를 늘린 겁니다.
핵심은 채점이 자동으로 된다는 점입니다. Qwen 팀이 Qwen3-Coder 블로그에서 이걸 한 문장으로 정리했는데요. “풀기는 어렵지만 검증은 쉬운(hard-to-solve, easy-to-verify)” 과제가 대규모 강화학습의 핵심으로 꼽혔습니다.
코드는 컴파일되거나 안 되거나, 테스트가 통과하거나 안 하거나 둘 중 하나입니다. 사람이 일일이 정답을 써줄 필요가 없습니다. 검증기만 있으면 문제를 무한히 찍어내고 모델한테 계속 풀리면 되는 거죠. 텍스트가 고갈돼도 이쪽은 안 고갈됩니다.
여기서 “그럼 코딩만 좋아지는 거 아니냐” 싶으실 텐데, 저도 같은 의문이 들었습니다. 요즘 Fable이나 Astra는 글 쓰는 능력도 확실히 좋아졌거든요.
찾아보니 ‘루브릭(채점 기준표)’으로 검증을 흉내 냅니다. 좋은 글이라는 뭉뚱그린 개념을 여러 하위 기준으로 쪼갠 다음, 심판 역할을 하는 다른 모델이 그 기준표를 들고 항목별로 채점하는 거예요. 코드는 컴파일러가 채점하고, 글은 루브릭 든 심판 모델이 채점하는 셈입니다. 더불어 사람이 채점하는 양도 시간이 지날 수록 많아져 좋아질 수도 있구요.
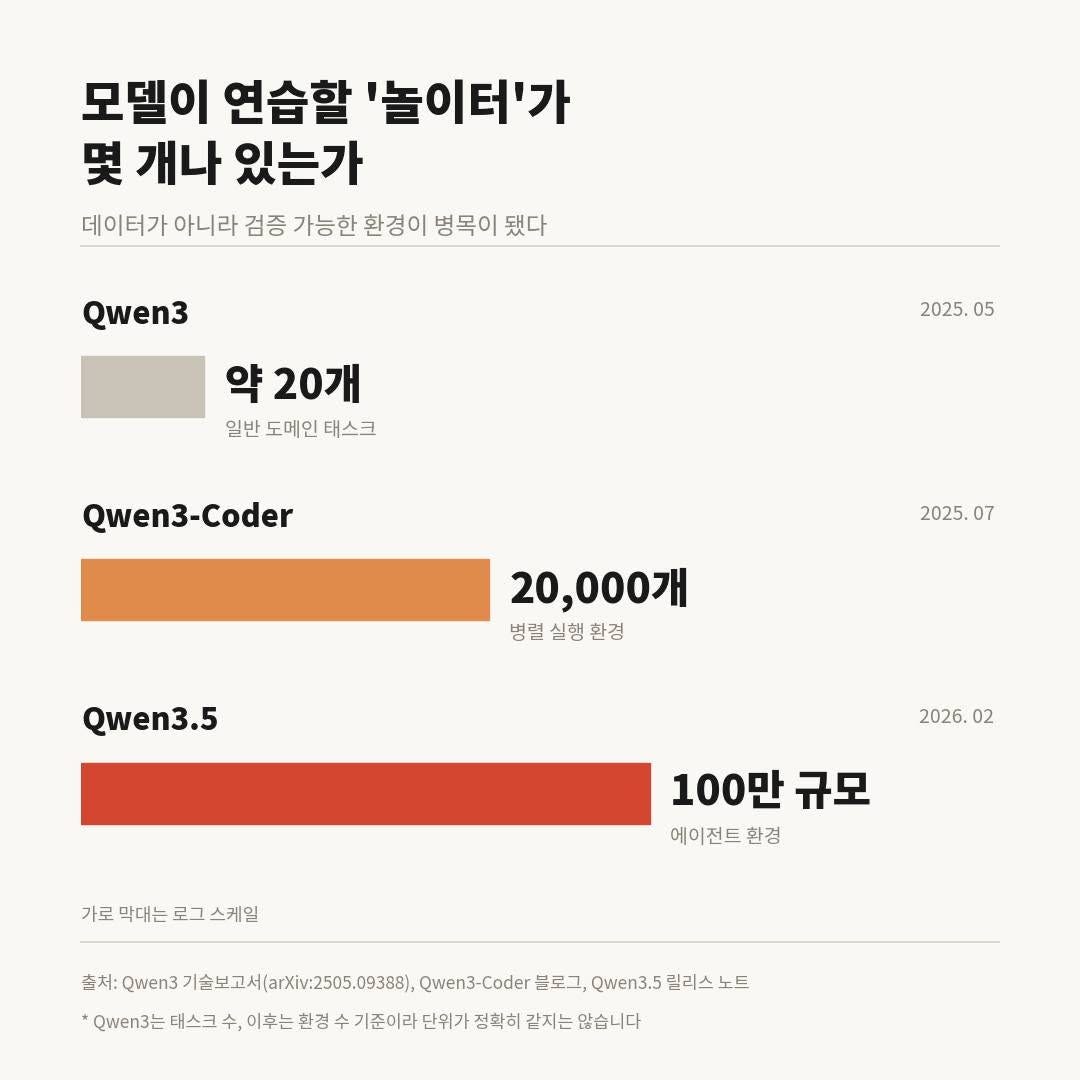
그래서 요즘 진짜 경쟁은 ‘환경 만들기’입니다. 숫자를 보면 좀 무섭습니다.
Qwen3가 약 20개 일반 도메인 태스크였는데, Qwen3-Coder에서 알리바바 클라우드 위에 2만 개 독립 환경을 병렬로 돌리는 시스템까지 갑니다. 그리고 올해 2월 나온 Qwen3.5는 아예 “백만 에이전트 환경”이라고 표현하더군요. Qwen 팀은 Qwen3.5 릴리스 노트에서 Qwen3 대비 사후학습 향상분의 대부분을 “생각해낼 수 있는 거의 모든 RL(Reinforcement Learning; 강화학습) 태스크와 환경의 광범위한 스케일링”에 돌립니다.
개인적으로 제일 재밌었던 건 GLM-5 기술 보고서에 나오는 트릭이었는데요.
코드 관련 웹페이지를 대량 수집한 다음, 품질 분류기로 거르고, 그중 터미널 작업으로 바꿀 수 있는 페이지만 골라냅니다. 그리고 코딩 에이전트한테 그 페이지랑 태스크 명세를 같이 주고 실행 가능한 문제를 합성시킵니다.
실제 GitHub 이슈로도 비슷한 걸 합니다. 저장소의 의존성 설정을 자동 분석해서 실행 환경을 구축하고, LLM으로 테스트 로그 파싱 함수를 생성해서 “고치기 전엔 실패하고 고친 후엔 통과하는” 테스트를 뽑아냅니다. 이렇게 9개 언어, 수천 개 저장소에 걸쳐 1만 개 이상의 검증 가능한 환경을 만들었다고 합니다.
그럼 다음 벽은 뭘까요. 아마 환경 제작 비용일 텐데, 이미 답이 나오고 있습니다. Qwen이 6월에 낸 Qwen-AgentWorld는 환경 자체를 시뮬레이션하는 세계모델을 따로 학습시켜서, 진짜 환경 없이도 RL을 돌리는 방향을 제안합니다.
모델이 직접 데이터를 만드는 단계에서, 이제는 본인을 시뮬레이션, 테스트하는 환경까지 구축해내는 단계로 도약하고 있는 과정입니다!