
90분동안 세 모델 출시.
송찬우 6분 분량
한국 시간으로 오늘 새벽 1시 반쯤, Anthropic이 Claude Opus 5.5를 냈습니다. 그리고 90분쯤 뒤, OpenAI가 GPT-6 Sol과 Luna를 냈고요.
하룻밤에 세 모델이 나왔는데, 발표문을 읽다 보니 공통점이 하나 보였습니다. 셋 다 성능보다 가격을 먼저 말한다는 겁니다.
선물도 줬습니다. 두 회사 모두 구독자에게 아무 때나 쓸 수 있는 사용량 초기화권을 한 장씩요. 여러분들 모두 아끼지 마시고 다들 신나게 달려주시길 바랍니다.
먼저 이름부터 정리하면
두 회사 모델 이름이 헷갈리실 텐데, 급을 맞춰보면 이렇습니다.
가장 큰 모델은 Anthropic의 Fable, OpenAI의 Astra 그 아래 주력 모델이 Opus와 Sol 중간급이 Sonnet과 Terra 가장 가볍고 싼 모델이 Haiku와 Luna.
그러니까 오늘 나온 건 양쪽의 주력급(Opus 5.5, Sol)과 OpenAI의 경량급(Luna)입니다.
Claude Opus 5.5
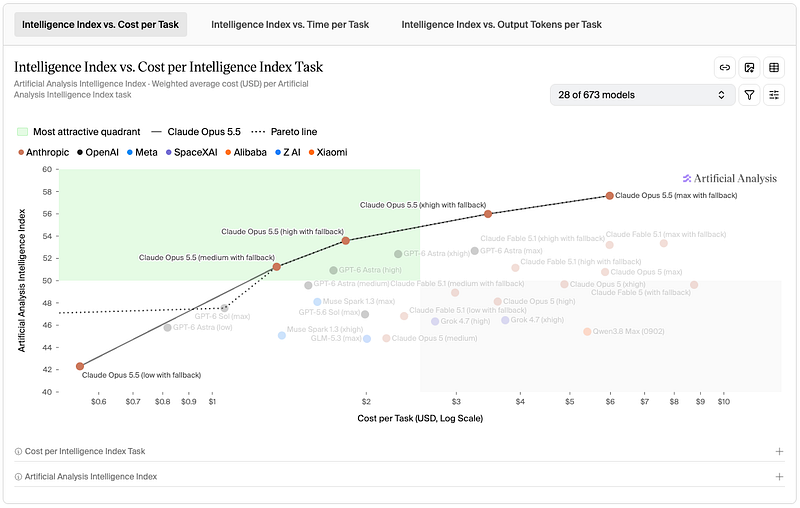
Anthropic의 설명은 “대부분의 작업에서 Fable 5.1 수준 이상의 성능을 내면서, Opus 5보다 작업당 40% 싸게 돈다”입니다. 한 단계 위 모델의 성능을 주력 모델 가격에 준다는 거죠. 속도도 30% 정도 빨라졌다고 하고요.
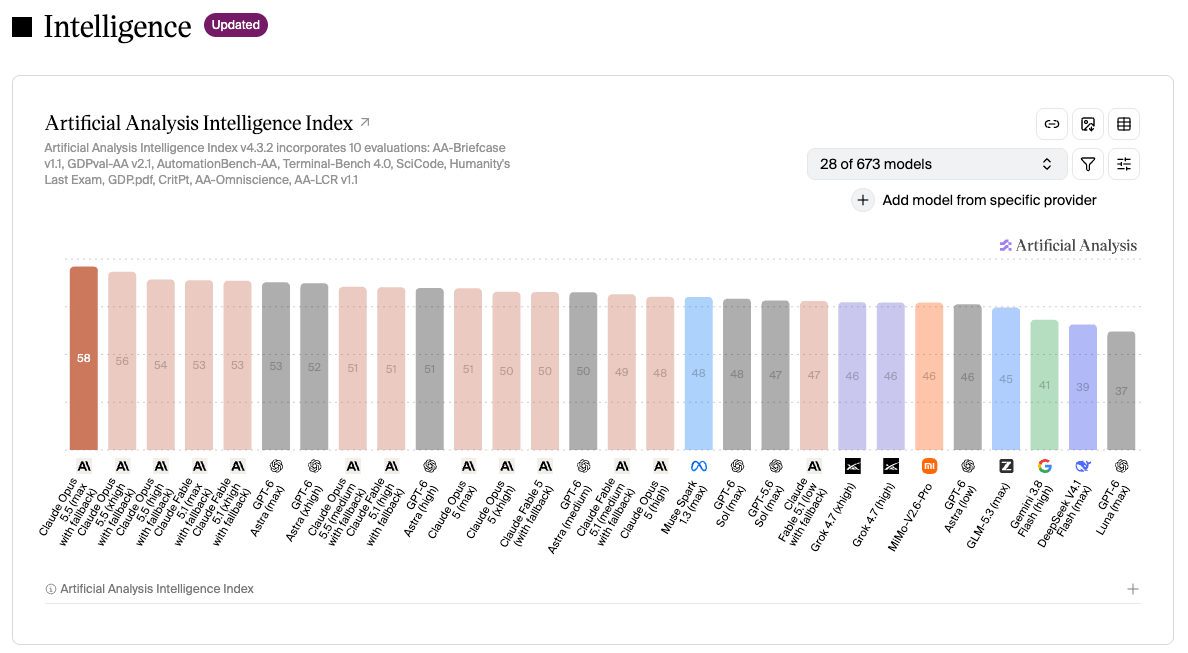
심지어 요금은 AI가 읽고 쓰는 토큰 100만 개당 입력 4달러, 출력 20달러로, 이전 Opus 5보다 20% 내렸습니다.
말투 부분에서도 업데이트가 되었는데요. 이전 버전에 “말이 어렵다”는 피드백이 많았는지, 전문용어를 덜 쓰고 중요한 내용을 앞에 두도록 바꿨다고 합니다.
눈에 띄는 외부 평가도 하나 있었는데요. 평가 기관 Vals AI에 따르면, AI가 작은 모델을 하루 안에 직접 학습시키는 과제에서 공개된 기준치를 처음으로 넘은 모델이라고 합니다. 전에 다룬 “AI가 AI를 만드는” 흐름이 여기서도 이어지는 셈이죠.
그리고 이번엔 순서가 특이합니다. 보통 중간급부터 냈는데, 이번엔 Opus가 먼저 나오고 Sonnet 5.5와 Haiku 5.5는 몇 주 안에 나온다고 합니다.
GPT-6 Sol과 Luna
OpenAI 쪽은 더 직설적입니다. 토큰당 가격을 절반 이하로 내렸습니다.
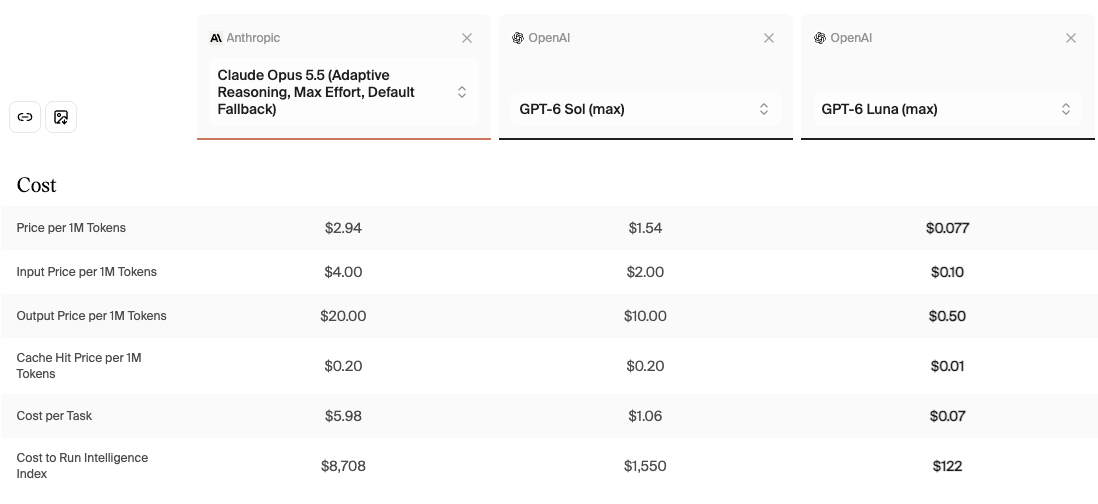
Sol은 100만 개당 입력 2달러, 출력 10달러로 이전 GPT-5.6 Sol의 절반이고, Luna는 입력 0.1달러, 출력 0.5달러입니다. 이전 5.6 때 가격은 “행사가”였는데, 이번 가격은 정가라고 못박았습니다.
OpenAI는 발표 내내 “같은 일을 하는 데 얼마가 드냐”로 비교합니다. 코딩 시험에서 Sol이 Anthropic의 Fable 5와 거의 같은 점수를 5분의 1 비용으로 냈고, 컴퓨터를 직접 조작하는 시험에서는 Claude Opus 5와 비슷한 점수를 80% 싸게 냈다는 식이요.
정확도 얘기도 있습니다. 사용자들이 “틀렸다”고 표시한 실제 대화로 평가해보니 Sol의 실수가 이전 모델의 절반으로 줄었고, 코딩하면서 결과를 속이는 비율도 10.4%에서 1.3%로 떨어졌다고 합니다.
Luna는 무료 사용자도 쓸 수 있게 풀립니다.
그런데 “싸졌다”를 그대로 믿기 전에
첫째, 토큰당 가격과 실제 비용은 다릅니다.
가격표는 글자 조각 하나당 값인데, 모델마다 같은 일을 하면서 쓰는 글자 수가 크게 다릅니다. 분석 기관 Artificial Analysis 기준으로, 같은 과제를 푸는 데 Opus 5.5는 평균 11만 9천 개, GPT-6 Astra는 1만 7천 개를 썼다고 합니다. 7배 차이예요.
단가가 싸도 말이 많으면 결국 비싸집니다. 전에 DeepSeek 모델을 다룰 때도 “싸지만 말이 많다”는 게 약점이었죠. 두 회사가 모두 “작업당 비용”을 강조하는 게 그래서입니다.
한마디로, 토큰당 가격이 싸졌다고 해도 말을 너무 많이 하거나 불필요한 작업을 너무 많이 한다면 안 좋을 거고, 토큰당 가격이 비싸졌다고 하더라도 굉장히 효율적으로 동작한다면 같은 지시여도 좋을 것입니다.
둘째, 아직 서로 제대로 비교된 적이 없습니다.
OpenAI의 비교 대상은 Opus 5입니다. Opus 5.5가 90분 먼저 나왔으니 비교할 시간이 없었던 거죠. Anthropic은 자기네 Fable 5.1과 비교하고요. Opus 5.5와 GPT-6 Sol을 같은 시험대에 올린 결과는 아직 없습니다.
셋, 성능과 안전 수치는 대부분 자체 발표입니다.
Opus 5.5는 Anthropic이 “AI 발전 속도를 안전 연구 속도에 맞춰 조절하자”고 공개적으로 밝힌 뒤 처음 내는 모델입니다. 출시 전에 METR 같은 외부 기관의 평가를 받았고, 자체 행동 감사에서 역대 가장 높은 점수를 받았다고 하는데요. 한편으론 Opus 5 이후 두 달, Fable 5.1 이후 3주 만의 출시라, 속도 조절과 맞는 행보냐는 지적도 나옵니다.
OpenAI의 실수 절반, 속임수 1.3%도 자체 평가 수치고요.
그래도 흐름은 분명해 보입니다.
한 달 전만 해도 발표문 첫 줄은 “가장 똑똑한 모델”이었는데, 오늘 새벽 발표문 첫 줄은 “더 싸게, 더 빠르게”였습니다. 성능 경쟁이 비용 경쟁으로 옮겨가고 있는 거죠.
전에 Jev를 소개하면서 제번스 역설 얘기를 했었는데요. 효율이 좋아지면 오히려 총소비가 늘어난다는 것. 오늘 밤 세 모델이 모두 싸졌으니, 우리가 AI에게 일을 시키는 양은 아마 더 늘어날 겁니다.
#AI #Claude #Opus5.5 #GPT6 #OpenAI #Anthropic