
Tencent가 공개한 목소리판 ‘나노바나나’가 무료로 풀렸습니다
송찬우 5분 분량
구글의 나노바나나 기억하시죠. 사진을 올려놓고 “배경을 바다로 바꿔줘”, “표정을 웃는 얼굴로” 하고 말로 시키면 그대로 고쳐주던 이미지 편집 AI요.
그 목소리 버전이 나왔습니다. 텐센트가 9월 9일 공개한 AuK인데요. 발표 당시 텐센트가 ‘오디오판 나노바나나’라는 별명을 붙였다고 전해집니다.
텐센트의 AI 조직인 훈위안이 상하이교통대 등과 함께 만들었고, 코드와 모델을 상업적으로도 자유롭게 쓸 수 있는 조건으로 공개했습니다. 크기도 요즘 기준으론 작은 편이고요.
뭘 할 수 있냐면요.
녹음 파일을 하나 올리고, 하고 싶은 걸 말로 적으면 됩니다.
한 말을 바꿉니다. 녹음 속 “받아들이는 것”이라는 문장을 “잘 살아가는 것”으로 바꿔달라고 하면, 그 사람 목소리 그대로 그 부분만 바뀝니다. 다시 녹음할 필요가 없어요. 노래도 됩니다. 멜로디와 목소리는 그대로 두고 가사만 바꿀 수 있습니다.
말투를 바꿉니다. 같은 문장을 화난 목소리로, 들뜬 목소리로 바꾸거나, 사투리를 빼거나, 속삭이는 소리를 평소 목소리로 바꿀 수 있습니다. 중간에 들어간 숨소리나 웃음, 기침을 지우거나 오히려 넣을 수도 있고요.
소리를 다듬습니다. 높이, 빠르기, 크기를 조절하고, 잡음과 울림을 걷어냅니다.
소리를 골라냅니다. 여러 사람이 동시에 말하는 녹음에서 한 사람 목소리만 남기거나, 노래에서 목소리만 뽑아낼 수 있습니다. 재밌는 건 “무슨 말을 한 사람”인지로 지정할 수도 있다는 점이에요.
없던 목소리도 만듭니다. 몇 초짜리 목소리 샘플을 주면 그 목소리로 새 문장을 읽고, 샘플이 없어도 “20대 여성이 다정하고 조금 애교 섞인 말투로” 같은 설명만으로 목소리를 지어냅니다.
핵심은 이게 전부 모델 하나, 입력창 하나라는 겁니다.
지금까지는 도구가 다 따로였습니다. 음성 합성 따로, 잡음 제거 따로, 목소리 분리 따로요. 작업마다 다른 프로그램을 찾아 써야 했죠. AuK는 16가지 작업을 한 모델에 넣고, 전부 말로 시키는 방식 하나로 통일했습니다. 나노바나나가 사진에서 한 일을 목소리에서 한 셈입니다.
실제로 텐센트가 공개한 성적표를 보면, 이 ‘고치기’ 쪽이 제일 두드러집니다.
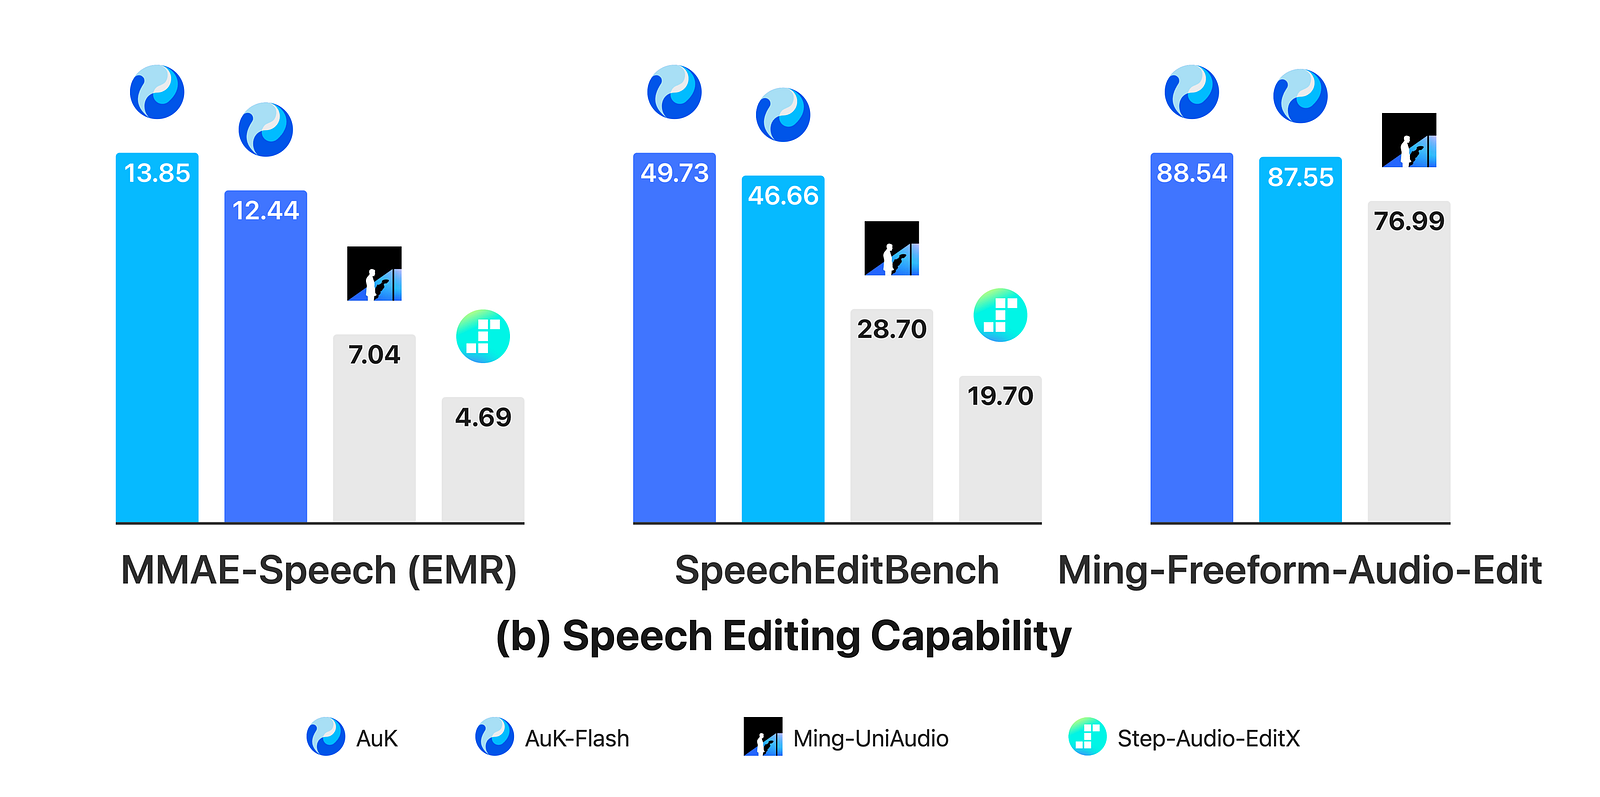
AuK의 음성 편집 성능(텐센트 발표 기준). 파란 막대 두 개가 AuK와 빠른 버전, 회색이 기존 편집 모델들입니다. 세 가지 시험 모두 앞섰고, 격차가 큰 곳은 두 배 가까이 납니다.
이걸 위해 모은 학습 데이터가 지시문과 음성을 짝지은 예시 약 30억 건, 195만 시간 분량입니다. 먼저 목소리 만드는 법부터 가르친 다음 고치는 법을 함께 가르쳤고, 마지막엔 사람들의 평가를 받아가며 다듬었다고 하네요.
학계에서도 바로 쓰이기 시작했습니다. 내년 음성 분야 국제 학회(ICASSP 2027)의 오디오 편집 대회에서 기준 모델로 채택됐거든요.
빠른 버전도 같이 냈습니다.
AuK-Flash라는 압축 버전인데, 원래 32번 거치던 생성 과정을 4번으로 줄여서 4.5배 빨라졌다고 합니다.
그리고 재밌는 후기가 하나 있었습니다. 한 개발자가 직접 돌려보니 처음엔 엄청 느렸는데, 알고 보니 모델 문제가 아니라 같이 딸려 온 실행 코드가 메모리를 과하게 쓰고 있었답니다. 그걸 고치니 같은 모델이 7배 빨라졌다고요.
지난번 Nari Labs 얘기와 똑같죠. 모델보다 돌리는 방식이 속도를 좌우하는 경우가 생각보다 많습니다.
다만 짚어둘 게 있습니다.
성능은 텐센트 자체 평가입니다. 그리고 같은 벤치마크를 전체로 펼쳐보면, 어디가 강하고 어디가 평범한지도 보입니다.
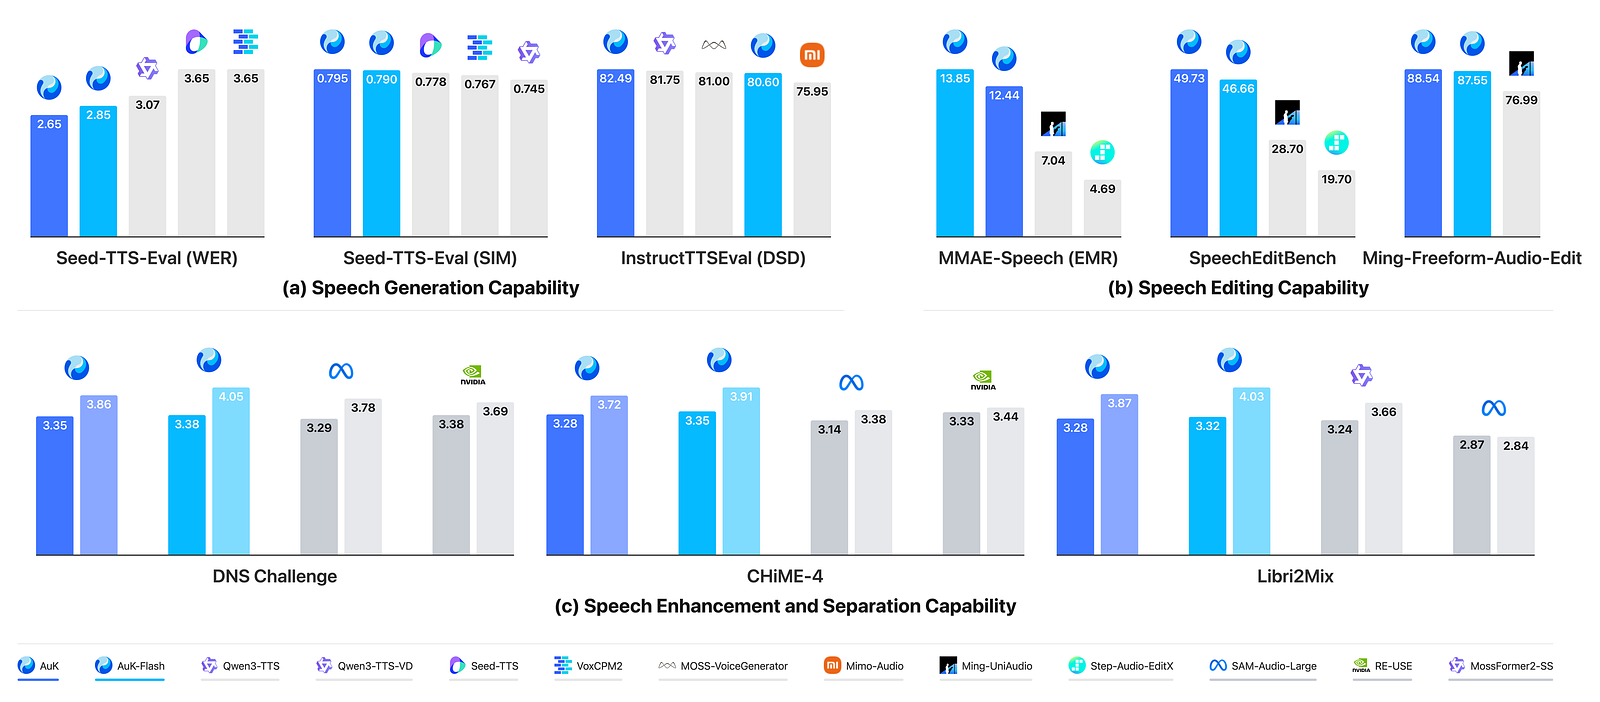
위 왼쪽이 목소리 만들기, 위 오른쪽이 편집, 아래가 잡음 제거/분리 성능입니다(텐센트 발표 기준).
만들기와 편집에서는 크게 앞서지만, 아래 줄 잡음 제거/분리에서는 메타와 엔비디아 등의 전용 모델들과 격차가 거의 없습니다. 텐센트도 이 부분은 “경쟁력 있는 수준”이라고만 표현했고요. 편집이 진짜 강점이고, 나머지는 같이 되는 정도로 보시면 됩니다.
한국어는 따로 확인하셔야 합니다. 공개된 예시가 영어와 중국어뿐이거든요.
생각보다 준비물도 많습니다. 따로 내려받아야 하는 보조 모델이 11GB쯤 되고, 대충 적은 요청을 알아듣게 다듬어주는 기능은 별도 AI 서비스의 API 키가 있어야 켜집니다. 기본값은 텐센트 클라우드고요. 공식 연동 도구 기준으로는 원본과 결과를 합쳐 30초까지만 한 번에 다룰 수 있습니다.
그리고 제일 무거운 얘기가 남아 있습니다.
“녹음 속 한 말을 그 사람 목소리 그대로 바꿀 수 있다”는 건, 뒤집으면 하지 않은 말을 한 것처럼 만들 수 있다는 뜻이기도 합니다. 그게 이제 누구나 무료로 쓸 수 있게 풀렸고요. 제가 본 공개 문서에서는 AI가 만든 음성임을 표시하는 장치에 대한 언급을 찾지 못했습니다.
더빙을 고치고, 오디오북 오타를 다시 녹음 없이 바로잡고, 팟캐스트를 편집하는 데는 정말 유용한 도구입니다. 동시에 “녹음이 있으면 그 사람이 한 말”이라는 오래된 전제는, 사진에 이어 목소리에서도 조용히 무너지고 있는 것 같습니다.
직접 들어보실 수 있는 데모가 공개돼 있습니다. 녹음 하나 올려서 말로 고쳐보시면, 글로 읽는 것보다 훨씬 와닿으실 거예요. https://huggingface.co/spaces/tencent/AuK
#AI #음성AI #텐센트 #AuK #오픈소스 #나노바나나