
Sonnet 5.5는 싸진 걸까, 비싸진 걸까?
송찬우 11분 분량
Anthropic이 9월 28일(한국 시간으로는 29일 새벽) Claude Sonnet 5.5를 내놨습니다. 지난주 나온 Opus 5.5에 이어, Claude 5.5 패밀리 모델의 두 번째 모델입니다.
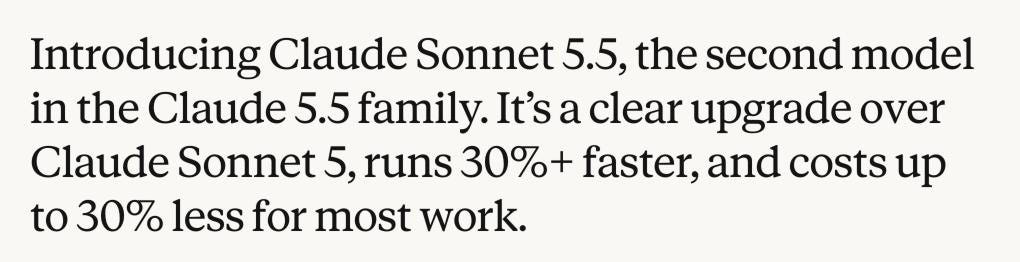
게시글 첫마디는 이렇습니다. “Sonnet 5보다 확실히 좋아졌고, 30% 이상 빠르며, 대부분의 작업에서 최대 30% 싸다.”
그런데 같은 날, AI 모델을 독립적으로 시험하는 Artificial Analysis(AA)는 결이 다른 숫자를 내놨습니다. 점수는 Opus 5.5 바로 다음인 2위인데, 과제 하나를 푸는 데 드는 돈은 Sonnet 5보다 50% 가까이 비싸다는 겁니다.
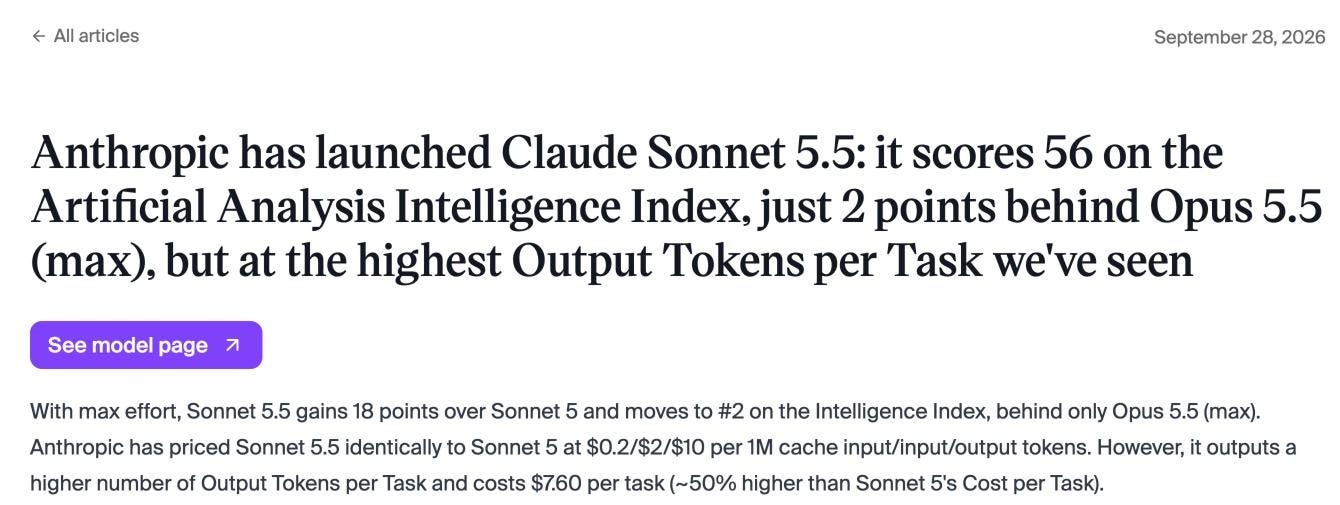
30% 싸다와 50% 비싸다. 같은 모델인데 숫자가 반대입니다.
결론부터 말씀드리면 둘 다 맞습니다. 차이는 AI를 ‘얼마나 오래 생각하게 했느냐’에서 나옵니다. 이번 Sonnet 5.5를 쓸 때 제일 중요한 포인트라서, 뭐가 좋아졌는지부터 차근차근 보겠습니다.
뭐가 좋아졌나
먼저 Anthropic이 공개한 성적표입니다.
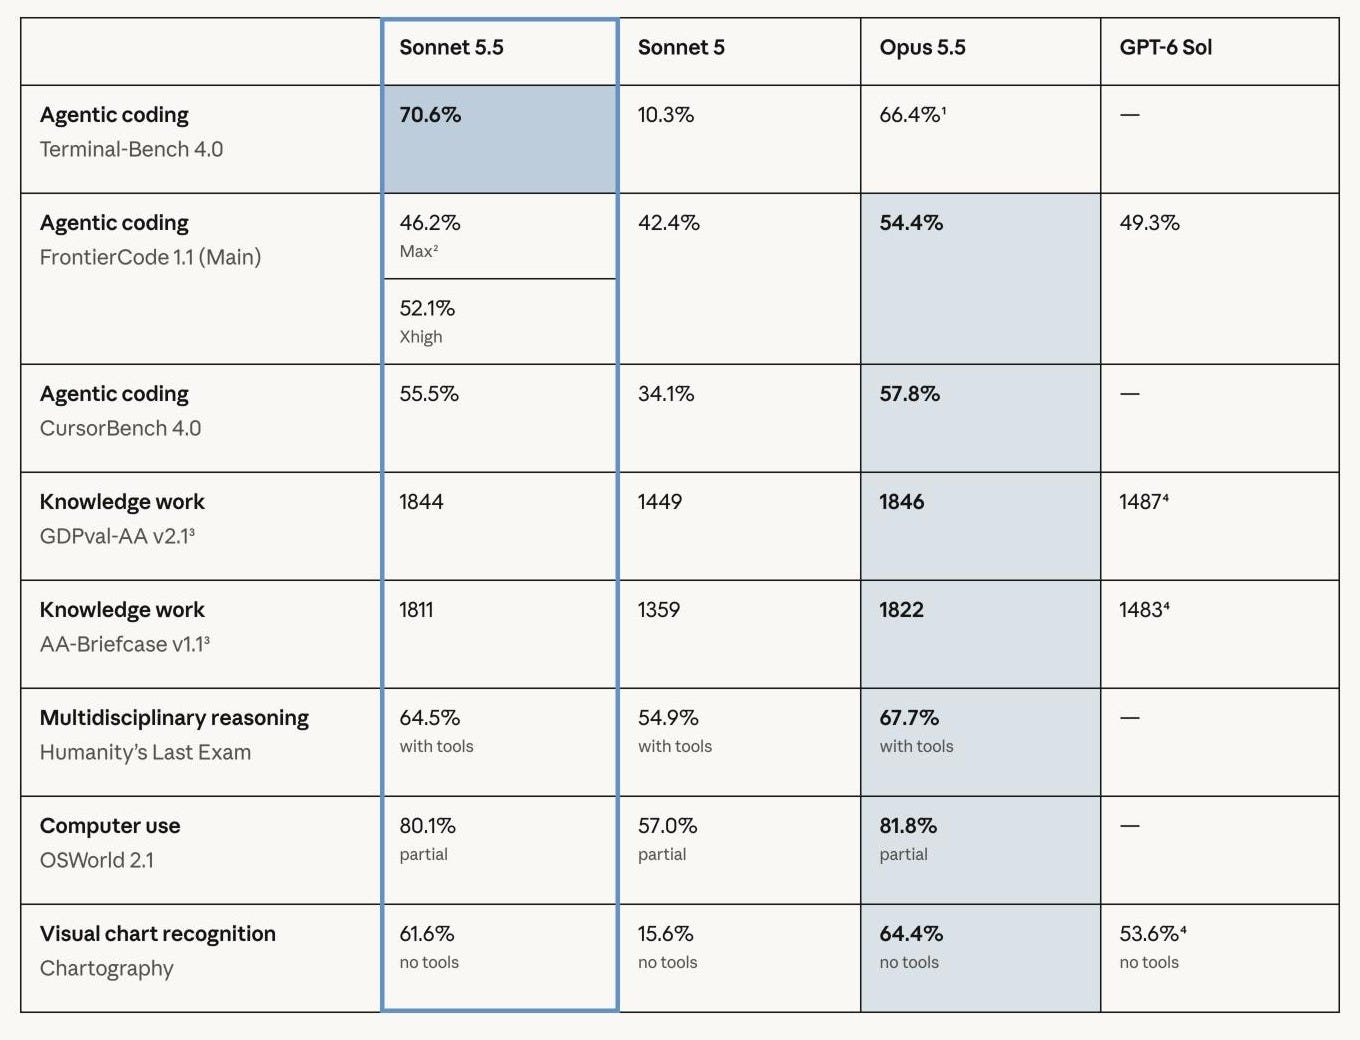
명령어 창에서 여러 단계짜리 작업을 끝까지 해내는 시험(Terminal-Bench 4.0)에서 Sonnet 5는 10.3%였는데, Sonnet 5.5는 70.6%입니다. 한 등급 위인 Opus 5.5(66.4%)보다도 높습니다.
44개 직업의 실제 업무를 시켜보는 시험(GDPval-AA)은 1449점에서 1844점으로 올라, Opus 5.5(1846점)와 2점 차이입니다. 컴퓨터 화면을 보고 직접 조작하는 시험(OSWorld)은 57.0%에서 80.1%, 차트를 읽는 시험(Chartography)은 15.6%에서 61.6%로 뛰었습니다. 스크린샷만 보고 게임 ‘포켓몬스터 레드’를 끝까지 깬 첫 Sonnet이기도 하고요.
숫자 말고도 재밌는 테스트가 있었는데요. Anthropic이 내부에서 한 상장사의 분기 실적 자료와 컨퍼런스콜 녹취록, 슬라이드 양식을 주고 10장짜리 보고서를 만들게 했더니, 전문가 두 명이 첫 초안을 그대로 보내도 되겠다고 평가했다고 합니다.
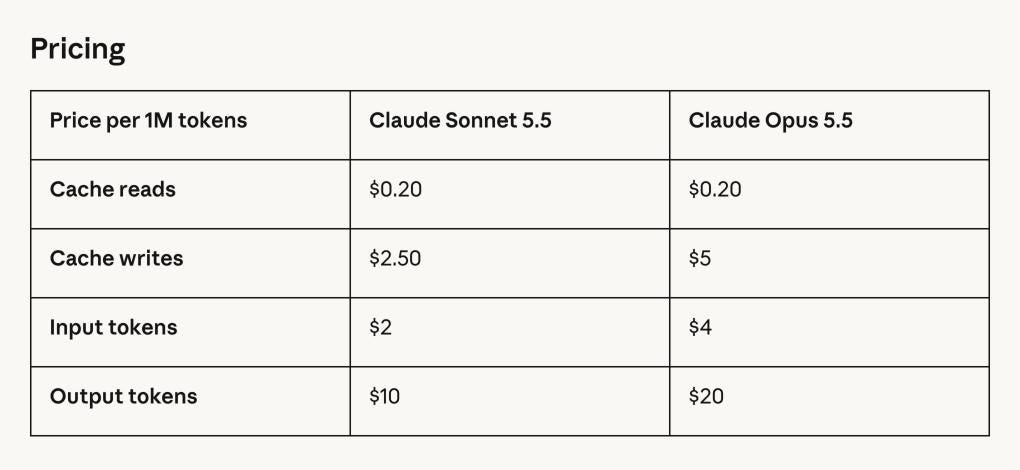
가격은 그대로입니다. 입력 100만 토큰에 2달러, 출력 100만 토큰에 10달러. 입력과 출력 모두 Opus 5.5의 딱 절반입니다.
앱 빌더 Base44는 실제 앱 118개를 만들게 했더니, Opus 5와 같은 품질을 평균 3.6번 만에 냈다고 합니다. Opus 5는 7.7번이 걸렸고요. 헤지펀드 Balyasny는 금융 과제 2,441개에서 답 하나에 쓰는 토큰이 Sonnet 5의 49만 7천 개에서 12만 1천 개로 줄었다고 합니다.
한마디로 더 똑똑해졌는데, 더 적게 쓰고, 값은 그대로라는 게 Anthropic의 설명입니다.
독립 평가에서도 2위
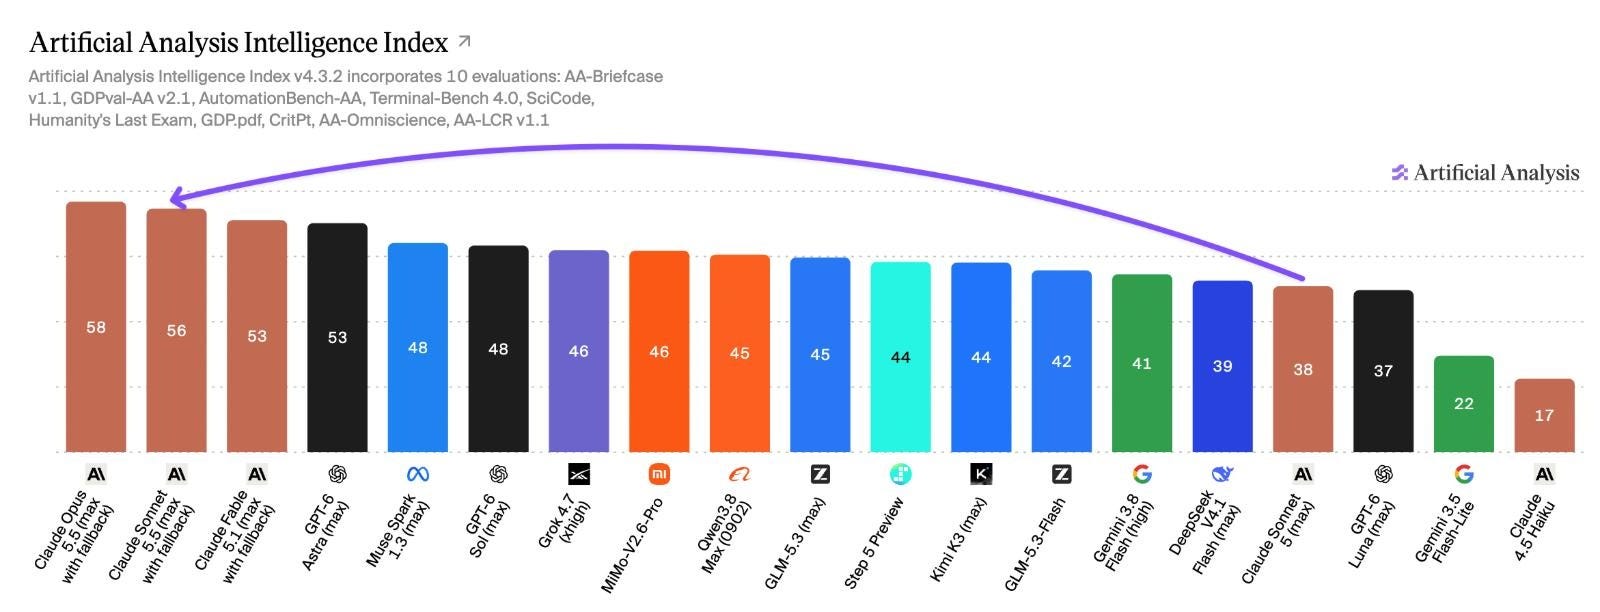
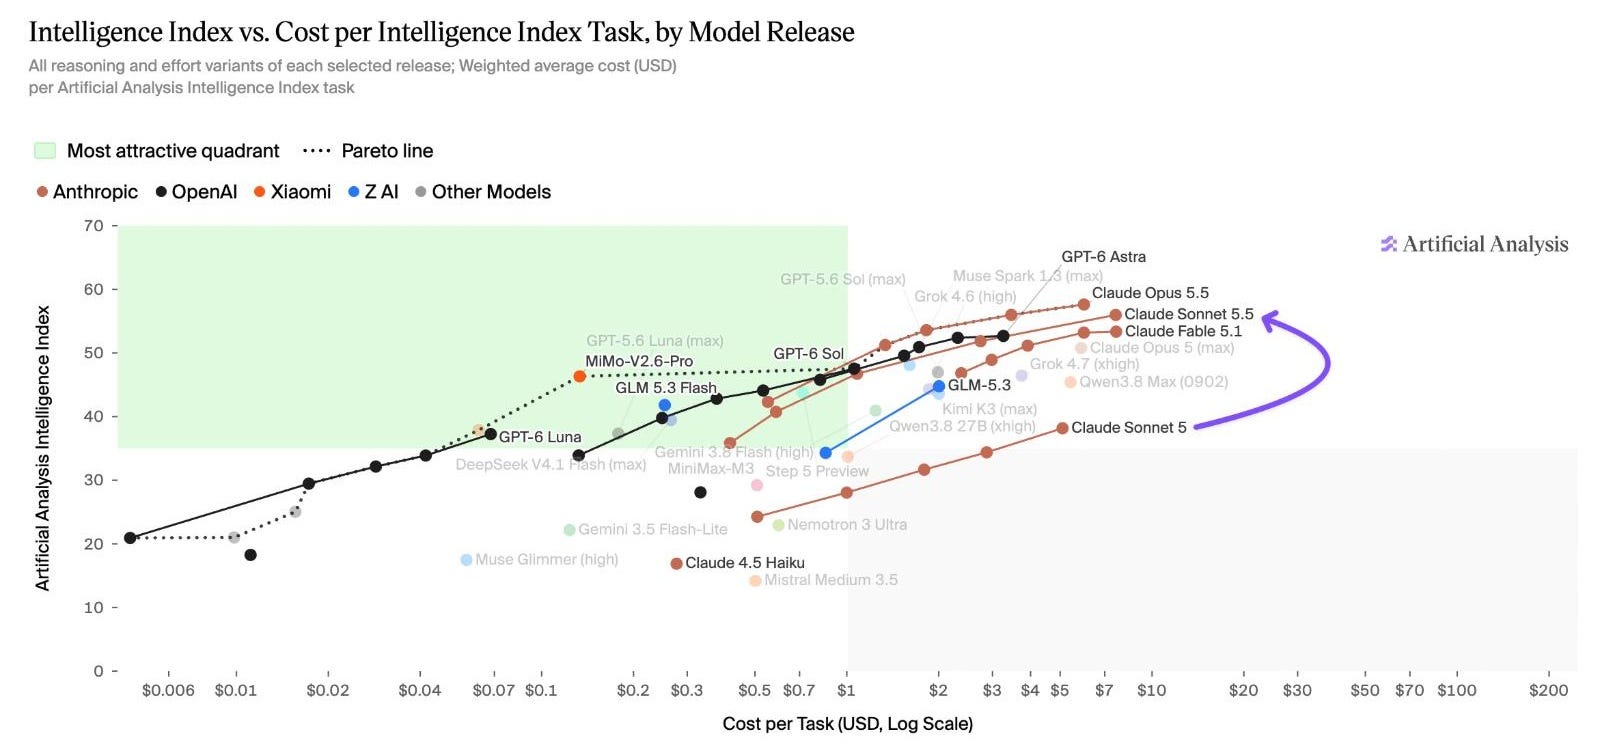
AA는 여러 회사의 모델을 같은 시험지로 돌려서 순위를 매기는 곳입니다. 열 가지 시험을 묶은 종합 점수(Intelligence Index)에서 Sonnet 5.5는 56점으로, Opus 5.5(58점)에 이어 2위입니다. Sonnet 5(38점)보다 18점 올랐고, OpenAI의 GPT-6 Astra와 Claude Fable 5.1(각 53점)보다도 높습니다.
AA가 직접 잰 Terminal-Bench 4.0에서도 64%로, Opus 5.5와 GPT-6 Astra(각 60%)를 앞섰습니다. 업무 과제 쪽(GDPval-AA 1844 대 1846, AA-Briefcase 1811 대 1822)은 Opus 5.5와 사실상 같은 수준이고요.
여기까지만 보면 “Opus급인데 값은 절반”입니다. 그런데 AA는 다른 그래프 하나를 같이 보여줍니다.
그런데, 토큰을 역대 가장 많이 씁니다
AA 기준으로 Sonnet 5.5가 가장 오래 생각하는 설정(max)에서 과제 하나에 쓴 출력 토큰은 약 19만 3천 개입니다. AA가 지금까지 잰 모델 중 가장 많습니다. Opus 5.5(11만 9천 개)나 Sonnet 5(11만 8천 개)보다 60%쯤 많고, GPT-6 Astra(2만 7천 개)의 7배입니다.
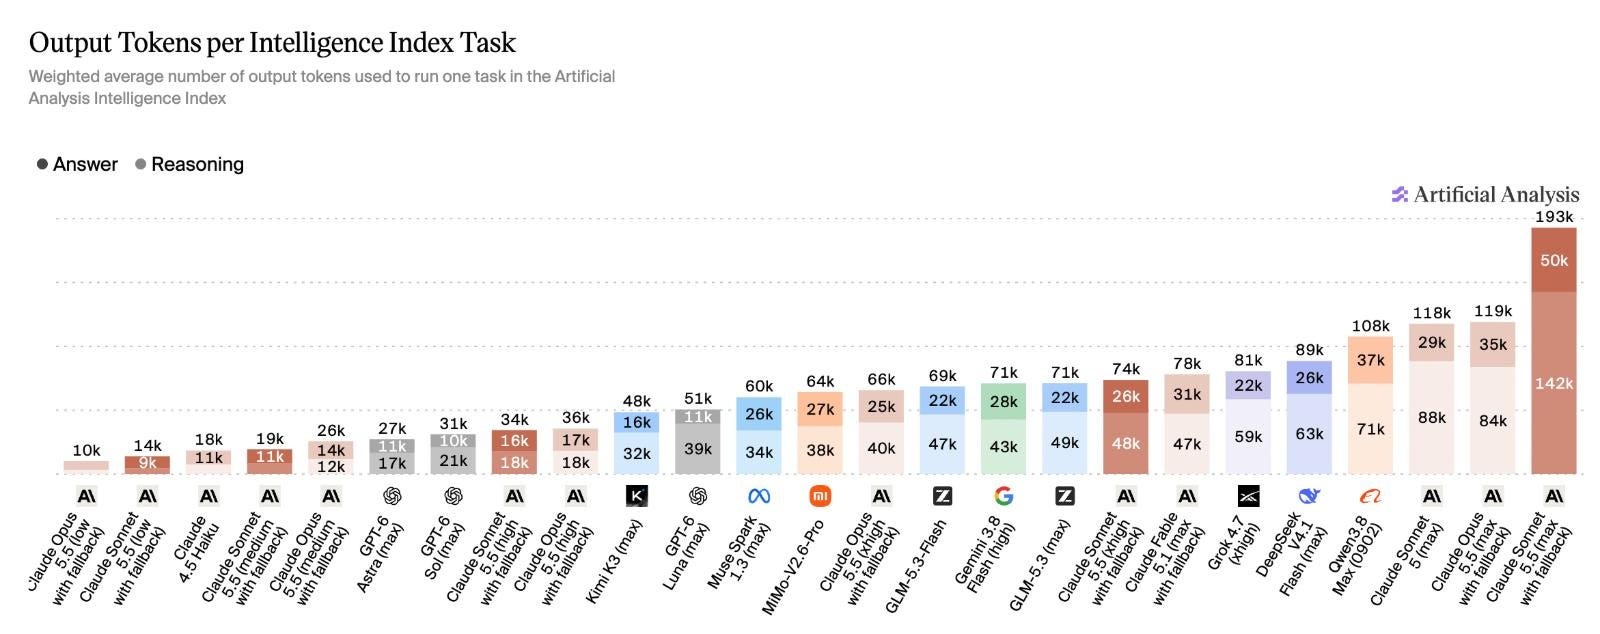
토큰 단가가 같아도 토큰을 많이 쓰면 비싸집니다. 그래서 AA 계산으로는 과제 하나에 7.60달러, Sonnet 5(max)의 5.09달러보다 50% 가까이 비쌉니다. 앞의 ‘50% 비싸다’가 바로 이 숫자입니다.
Effort
여기서 알아야 할 게 effort(추론 강도) 설정입니다. AI에게 얼마나 오래, 깊게 생각할지 정해주는 설정인데요. Sonnet 5.5에는 low, medium, high, xhigh, max 다섯 단계가 있습니다.
시험에 비유하면, 문제를 한 번 풀고 바로 내느냐, 세 번 검산하고 내느냐의 차이입니다. 검산을 많이 할수록 점수는 오르지만 시간과 연습장(토큰)이 많이 듭니다.
AA의 ‘50% 비싸다’는 가장 오래 생각하는 max끼리 비교한 숫자입니다. AA가 다섯 단계를 모두 잰 결과를 보면 그림이 달라집니다.
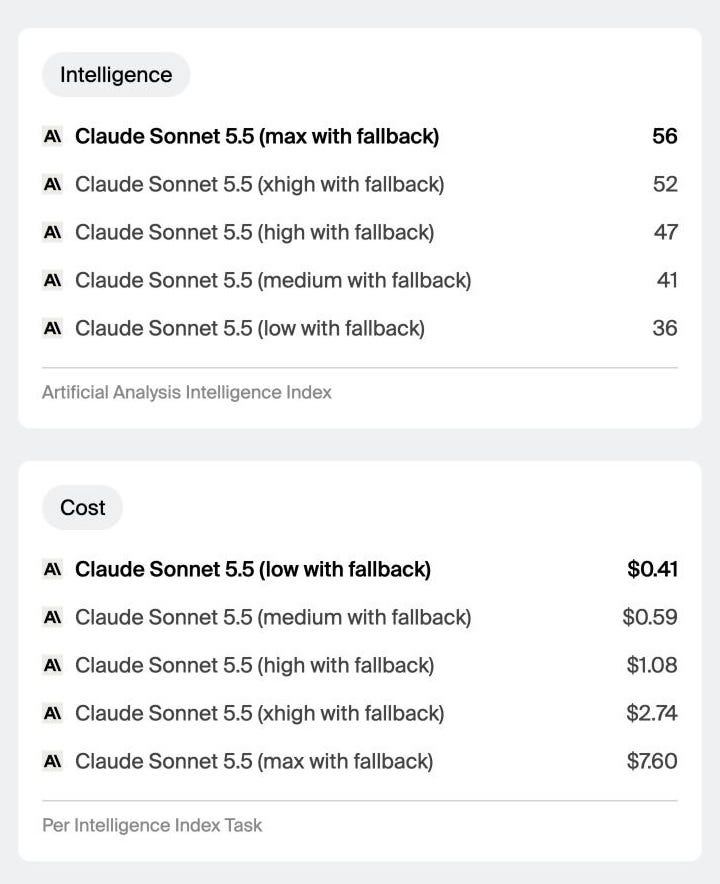
같은 단계끼리 Sonnet 5와 비교해보면, low부터 xhigh까지는 Sonnet 5.5가 12~18점 높으면서 과제당 비용은 5~41% 쌉니다. 비싸지는 건 max 하나뿐입니다(7.60달러 대 5.09달러).
즉 같은 단계로 쓰면 더 똑똑하고 더 싼데, 끝까지 쥐어짜는 max에서만 비싸집니다. Anthropic의 ‘30% 싸다’와 AA의 ‘50% 비싸다’는 서로 다른 지점을 본 거죠.
특히 medium이 눈에 띕니다. Sonnet 5.5(medium)는 41점으로 Sonnet 5의 최고치(max, 38점)를 넘는데, 비용은 0.59달러로 Sonnet 5 max(5.09달러)의 9분의 1 수준입니다. Anthropic도 “여러 시험에서 low나 medium만으로 Sonnet 5의 최고 점수를 약 10분의 1 비용에 넘는다”고 했는데, AA 숫자로 봐도 비슷하게 나옵니다.
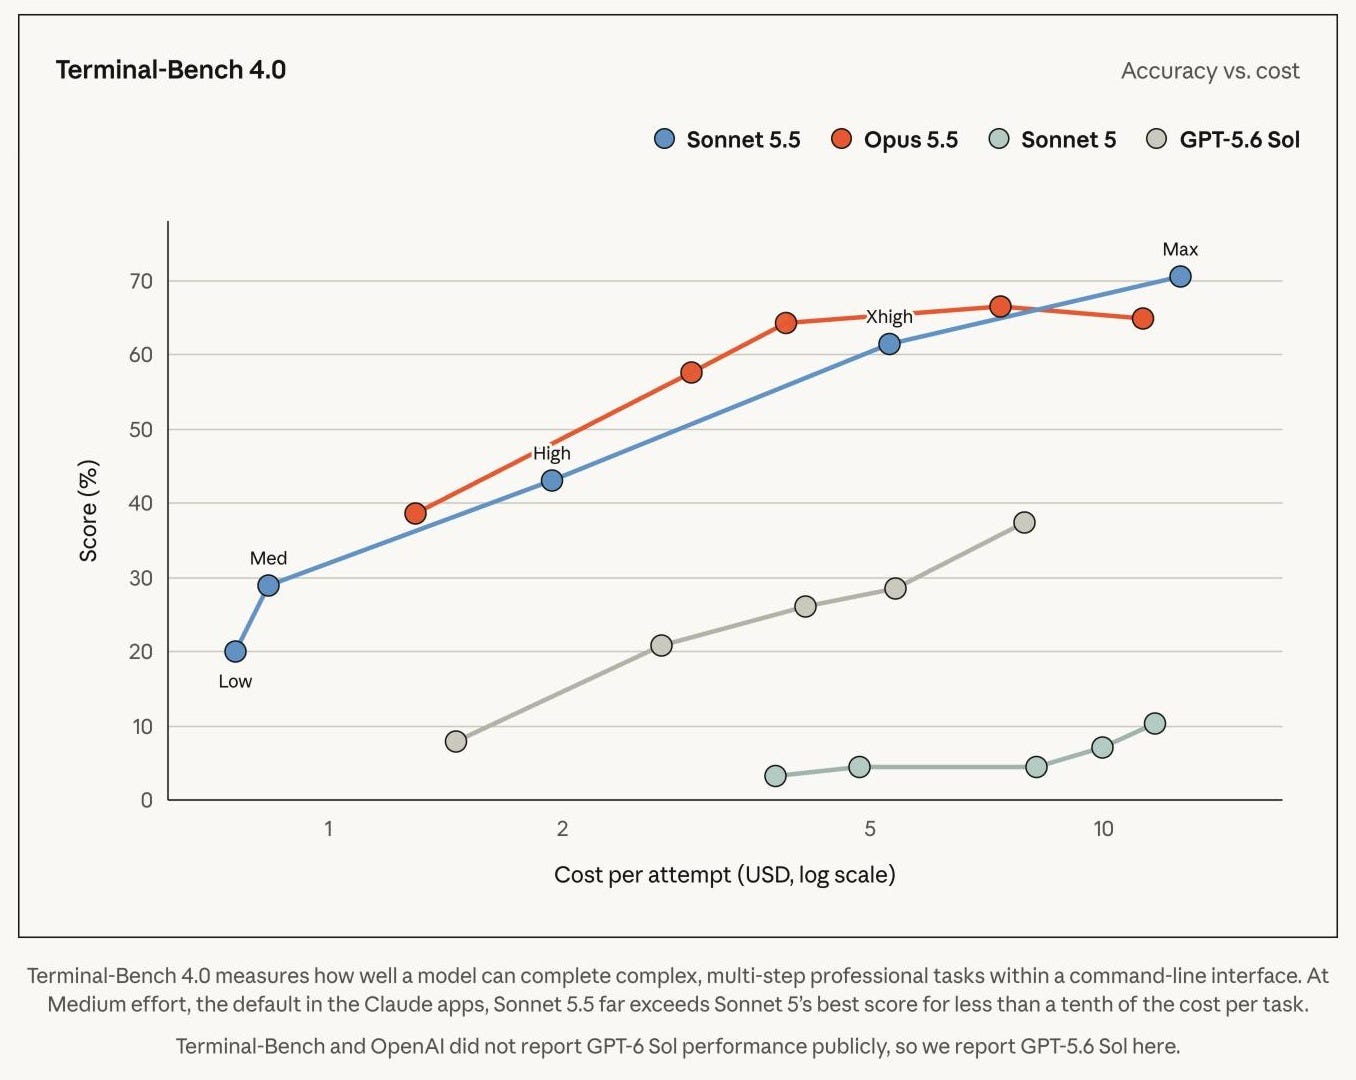
그리고 Claude 앱과 Claude Code의 기본값이 바로 이 medium입니다. 개발자용 Claude Platform (웹 채팅)은 high가 기본이고요. 따로 건드리지 않으면 대부분 ‘가성비 구간’에서 쓰게 되는 셈입니다.
재밌는 건 max가 늘 좋은 것도 아니라는 점입니다. 고친 코드를 사람 손 안 대고 바로 합칠 수 있는지 보는 시험(FrontierCode)에서, Sonnet 5.5는 xhigh가 52.1%인데 max는 46.2%로 오히려 낮았습니다. Anthropic 설명으로는 max에서 코드 검토를 여러 하위 에이전트로 쪼개 돌리다가 시간이 초과되거나, 시키지 않은 부분까지 고쳐서 감점된 경우가 있었다고 합니다. 추론을 많이 시킨다고 무조건 나아지는 건 아닌 거죠.
그럼 Opus 대신 Sonnet을 쓰면 될까
Sonnet을 max까지 쥐어짜면 Opus에 가까워지는 건 맞습니다. 그런데 그 돈이면 Opus를 쓰는 게 낫습니다.
AA 숫자로 보면 Opus 5.5는 xhigh에서 56점을 3.46달러에 냅니다. Sonnet 5.5가 같은 56점을 내려면 max로 7.60달러가 듭니다. Opus 5.5 medium(51점, 1.34달러)도 Sonnet 5.5 xhigh(52점, 2.74달러)와 점수는 비슷한데 비용은 절반이고요. 토큰 단가는 Opus가 두 배지만, 같은 점수를 훨씬 적은 토큰으로 내기 때문입니다.
사실 앞의 Anthropic Terminal-Bench 그래프에서도 비용이 겹치는 구간에서는 대부분 Opus 5.5(주황 선)가 Sonnet 5.5(파란 선)보다 위에 있습니다. Sonnet 5.5가 앞서는 건 Opus가 닿지 않는 1달러 이하 구간과 맨 끝 max 정도입니다. Anthropic 스스로도 Sonnet 5.5는 “낮은 effort에서 Opus 5.5를 가장 잘 보완한다”고 적어뒀고요.
그래서 제 결론은 이렇습니다. 평소 일은 Sonnet 5.5를 medium으로, 정말 어려운 일은 Sonnet을 max로 쥐어짜지 말고 Opus 5.5로. API로 직접 비용을 내며 쓰는 경우라면 더더욱 그렇습니다.
대신 Sonnet 5.5의 진짜 무기는 속도입니다. AA 측정으로 초당 89~143토큰을 내서, Opus 5.5(75~95토큰)는 물론 Sonnet 5(56~81토큰)보다도 확실히 빠릅니다. 빨리 주고받으며 다듬는 작업이라면 Sonnet 5.5가 훨씬 편할 겁니다.
다만 짚어둘 게 있습니다
첫째, AA 평가는 출시 전 버전으로 한 겁니다. 특정 형식(구조화된 출력)으로 답을 요청하면 답이 나빠질 수 있는 버그가 있었고, 지금은 고쳐졌다고 합니다. AA도 곧 다시 돌린다고 했으니 숫자는 조금 바뀔 수 있습니다.
둘째, 벤치마크 점수가 전부는 아닙니다. Anthropic도 “꾸준한 판단이 필요한 복잡하고 열린 일에서는 여전히 Opus 5.5가 분명히 더 강하다”고 적었습니다. 사실 지식을 묻는 시험(AA-Omniscience)에서도 Sonnet 5.5는 54%로 Opus 5.5(66%)보다 낮습니다. 대신 모르는 걸 지어내는 비율은 47%로 Opus(59%)보다 낮았고요.
셋째, 보안 쪽 제한이 생겼습니다. 해킹 관련 능력이 Opus 5 수준까지 올라와서, 위험도가 높은 보안 요청은 눈에 보이게 Sonnet 5로 넘어갑니다. 평범한 버그 수정은 괜찮다고 하고, AA 평가에서는 과제의 0.1% 정도에서 이런 전환이 있었습니다.
넷째, ‘증류 공격’을 막는 장치가 처음 들어갔습니다. 가짜 계정 수천 개로 모델의 능력, 특히 생각 과정을 대량으로 빼내 다른 모델을 만드는 걸 막는 건데요. 생각 과정이 그걸 만든 계정에 묶이기 때문에, Claude Code에서 작업 도중 계정을 바꾸는 경우엔 영향이 있을 수 있습니다. 대부분은 체감할 일이 없다고 합니다.
모델 이름보다 추론 강도
예전엔 “어떤 모델 쓰세요?”가 질문이었다면, 이제는 “어떤 모델을, 얼마나 생각하게 하세요?”까지 물어야 할 것 같습니다. 같은 Sonnet 5.5라도 low와 max 사이에 점수는 20점, 과제당 비용은 18배 차이가 나니까요.
몇 주 뒤에는 가볍고 싼 Haiku 5.5도 나온다고 합니다. 고를 수 있는 조합은 더 늘어나겠죠. 결국 중요한 건 제일 비싼 조합이 아니라 내 일에 맞는 조합입니다.
다음에 Claude를 쓰실 때, 모델 이름 옆의 effort 설정도 한 번 확인해보세요. 생각보다 차이가 큽니다.
https://www.anthropic.com/claude-sonnet-5-5
#AI #Claude #Sonnet55 #Anthropic #ArtificialAnalysis #LLM