
AI 회사들은 왜 한국어 책 10만 권을 한 권씩 사려 했을까?
송찬우 8분 분량

10월 14일 중앙일보 단독 보도로, 국내 최대 서점 교보문고에 이상한 주문 문의가 이어졌다는 사실이 알려졌습니다. 올해 초부터 미국, 영국 등 해외 업체 약 10곳이 한국어 책을 사고 싶다고 연락해 왔는데, 원하는 책이 따로 없었습니다. 제목도 분야도 상관없이 서로 다른 책 약 10만 권을 한 권씩 사겠다는 주문이었어요.
교보문고가 최종 납품처를 묻자 업체들은 “최종 납품처 정보는 비밀유지 사항으로 공개할 수 없다”고 답했습니다. 한 업체는 “AI 학습 목적은 아니다”라면서도 최종 납품처는 “데이터 관련 기업”이라고 했어요. 교보문고는 AI 학습에 쓰일 가능성을 배제하기 어렵다며 거래 논의를 끊었습니다.
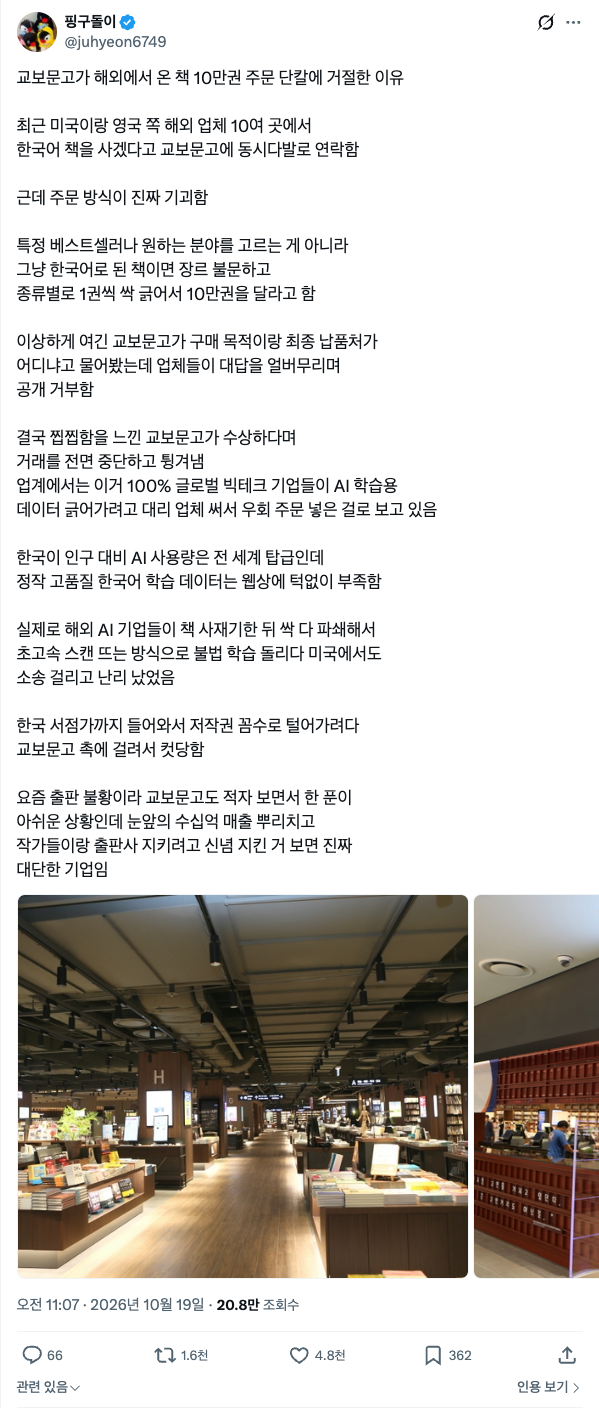
이 이야기를 정리한 X 글은 10월 19일 오전에 올라와 그날 저녁까지 조회 20만을 넘기고 좋아요 4,800개를 받았습니다. 그런데 눈여겨볼 건 주문 방식입니다. 업체들은 왜 하필 한 권씩 사려 했을까요?
결론부터 말하면, ‘한 권씩’은 AI 학습용 책을 모으는 방식과 똑같습니다.
다시 팔 책이라면 잘 팔릴 책을 골라 여러 권 삽니다. 교보문고도 “미국, 유럽, 베트남 등 한국 도서를 사 가는 해외 서점들은 일반적으로 도서 목록과 구매 목적을 제시한다”고 설명했어요. 반대로 AI 학습에는 같은 책이 두 권 필요 없습니다. 한 번 스캔하면 끝이기 때문입니다.
지난 8월에는 미국 애리조나주의 한 업체가 예스24 중고서점과 서울책보고에 헌책을 대량으로 사겠다고 문의했습니다. 중앙일보 기자가 이 업체에 직접 물었더니 “도서별로 한 권씩 매입하니, 전체 권수보다 서로 다른 도서의 종수가 더 중요하다”는 답이 돌아왔어요. 이 업체는 교보문고에도 문의했습니다.
이 방식을 가장 크게 벌인 곳이 Anthropic입니다. 2025년 6월 미국 법원 판결문에 따르면 Anthropic은 종이책 수백만 권을 사들였습니다. 상당수는 중고책이었고, 제본을 뜯고 페이지를 잘라 스캔한 뒤 종이 원본은 버렸어요. 2026년 1월 워싱턴포스트가 보도한 내부 문서에서는 이 일을 ‘프로젝트 파나마’라고 부르며 “세상의 모든 책을 파괴적으로 스캔하려는 노력”이라고 적었습니다.
한국 책은 이미 팔려 나갔습니다.
10월 18일 뉴시스 보도에서 국내 도서유통사 웅진북센은 “2024년 Anthropic과 계약을 맺고 2025년에 공급했다”고 밝혔습니다. 몇 권을 보냈는지는 계약을 이유로 밝히지 않았어요. 웅진북센은 “2024년도에는 AI 학습 문제가 익숙하지 않아 통상 책 거래로 생각하고 제공했다”며, 앞으로 AI 업체로 갈 수 있는 거래는 하지 않겠다고 했습니다.
일본도 같은 길을 걸었습니다. 일본 도서유통사 닛판(日販) 그룹은 2024년 12월부터 1년 동안 Anthropic에 일본어 새 책을 팔았다고 인정했어요. 닛판 역시 당시에는 AI 학습에 쓰일 줄 몰랐다고 밝혔습니다.
교보문고만 연락을 받은 것도 아닙니다. 예스24는 지난 8월 한국을 찾은 업체와 만나기까지 했고, 알라딘은 9월 캐나다의 중고책 유통사에서 대량 구매 문의를 받았습니다. 두 곳 모두 거래로 이어지지는 않았어요.
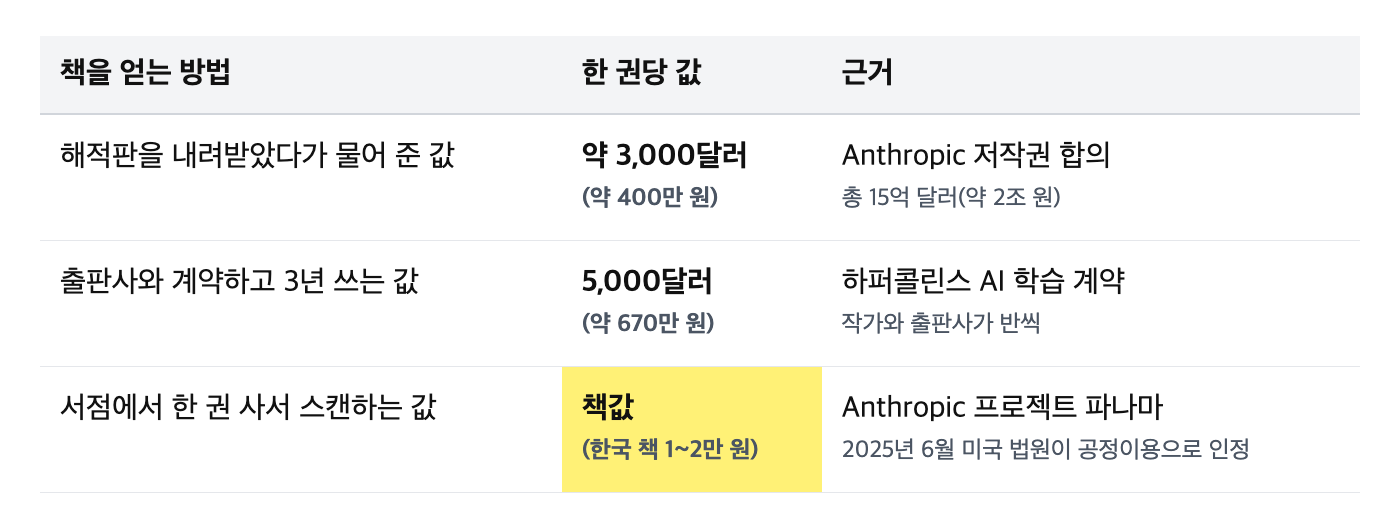
사서 스캔하면 합법이고, 내려받으면 한 권에 약 400만 원입니다.
업체들이 굳이 돈을 내고 한 권씩 사는 데는 이유가 있습니다. 2024년 미국 작가들이 Anthropic을 상대로 낸 집단소송에서, 윌리엄 알섭(William Alsup) 판사는 2025년 6월 판단을 둘로 나눴습니다. 책으로 AI를 학습시킨 것, 그리고 산 종이책을 스캔해 디지털로 바꾼 것은 공정이용으로 인정했어요. 반대로 해적 사이트에서 내려받은 책을 쌓아 둔 것은 공정이용이 아니라고 봤습니다.
그 대가가 15억 달러(약 2조 원)입니다. Anthropic은 라이브러리 제네시스(LibGen)와 파이럿 라이브러리 미러(PiLiMi)에서 파일 약 700만 개를 내려받았고, 작가와 출판사에 작품당 약 3,000달러(약 400만 원)를 물어 주기로 합의했습니다. 합의 사이트는 이를 역사상 가장 큰 저작권 집단소송 합의라고 소개해요. 법원은 2026년 7월 20일 이 합의를 최종 승인했습니다.
정식으로 허락을 받고 쓰는 길도 있습니다. 2024년 11월 하퍼콜린스는 책을 3년 동안 AI 학습에 쓰게 해 주는 대가로 한 권에 5,000달러(약 670만 원)를 받는 계약을 맺었고, 이 돈을 작가와 출판사가 반씩 나눴습니다. 블룸버그는 계약 상대를 마이크로소프트로 보도했어요. 서점에서 한 권 사면 1~2만 원이니, 한 권씩 사서 스캔하는 쪽이 수백 배 쌉니다.
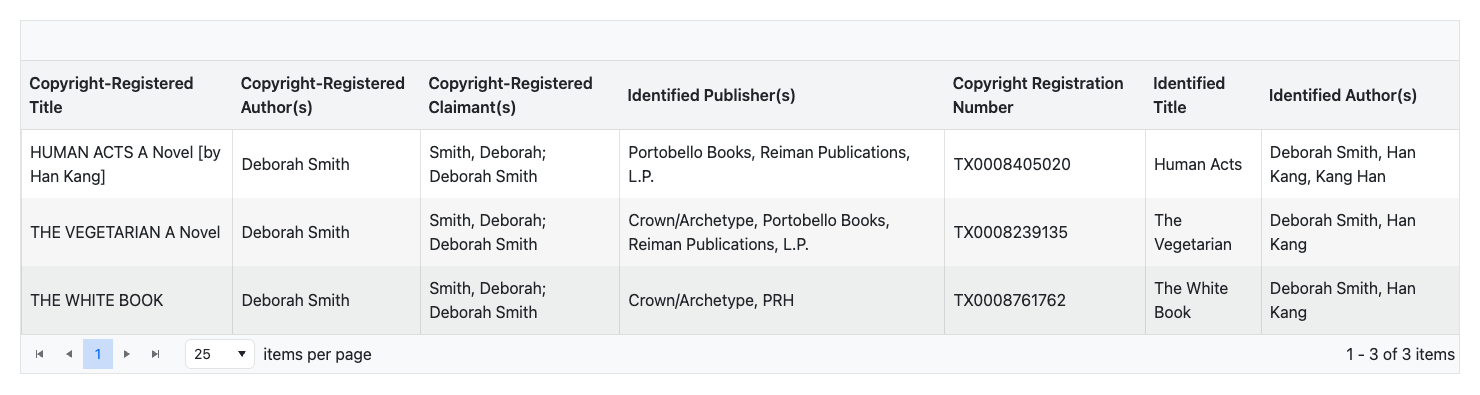
한강의 책도 합의 목록에 있었습니다.
10월 17일 한국문학번역원은 이 합의의 보상 대상 목록에서 한국 작가의 책 21권을 찾아 작가들에게 알렸습니다. 한강의 ‘소년이 온다’, ‘채식주의자’, ‘흰’, 김영하의 ‘빛의 제국’, 신경숙의 ‘엄마를 부탁해’, 김애란의 ‘두근두근 내 인생’, 김숨의 ‘한 명’, 황선미의 ‘마당을 나온 암탉’, 황석영의 ‘손님’ 등이에요. 모두 영어 번역판입니다.
한국어 원서는 이 목록에 들어가기 어렵습니다. 미국 저작권청에 제때 등록된 책만 합의 대상이기 때문입니다. 합의 사이트 설명을 보면 Anthropic이 내려받은 고유 작품 약 400만 권 가운데 약 250만 권이 영어가 아닌 책이었고, 대부분 등록되지 않아 목록에서 빠졌어요. 해적 사이트에 한국어 원서가 있었더라도 이 합의로는 받을 돈이 없다는 뜻입니다.
웹에는 한국어 문장이 적습니다.
업체들이 한국어 원서를 찾는 이유도 여기서 짐작할 수 있습니다. 공개 웹 페이지를 모아 두는 커먼크롤(Common Crawl)의 2026년 9월 수집분에서 한국어 페이지는 0.84%로 17위였습니다. 영어는 41.86%, 일본어는 5.17%예요. 편집을 거친 한국어 문장이 한 권 내내 이어지는 책은 웹에서 대신 구하기 어렵습니다.
지난달 ‘학습할 데이터는 다 떨어졌을 텐데, AI는 왜 더 좋아질까’에서 소개했던 강화학습은 검증기만 있으면 수학/코드 문제를 얼마든지 찍어 냅니다. 사람이 쓴 한국어 문장은 그렇게 찍어 낼 수 없으니, 결국 사 와야 합니다.
다만 누가 샀는지는 아직 모릅니다.
교보문고에 문의한 업체들의 최종 고객이 AI 회사인지는 확인되지 않았습니다. 교보문고도 AI 학습에 쓰일 가능성을 배제하기 어렵다고 했을 뿐이에요. 웅진북센이 Anthropic에 보낸 책이 몇 권이고 어떤 책인지도 공개되지 않았습니다.
화제가 된 X 글에도 바로잡을 부분이 있습니다. 책을 사서 파쇄하고 스캔하는 방식으로 불법 학습을 하다 소송이 났다고 적었지만, 미국 법원이 문제 삼은 건 해적 사이트에서 내려받은 책이었어요. 산 책을 스캔한 건 공정이용으로 인정받았습니다. 그렇다고 한국에서도 그대로 통한다는 보장은 없습니다. 덕성여대 AI 연구소 박정인 교수는 “헌책을 매입하는 행위 자체는 통상 적법하지만 그 책을 스캔하고 복제해 AI 학습에 이용하는 권리까지 취득하는 것은 아니다”라고 짚었어요.
출판계도 움직이기 시작했습니다. 대한출판문화협회는 서점과 중고서점, 유통사를 상대로 실태조사를 하기로 했고, 10월 16일 한국출판인회의 등과 함께 ‘대한민국 호소문’을 냈습니다. 같은 날까지 단체 174곳과 개인 358명이 이름을 올렸어요. AI 회사에 학습 데이터 공개와 이용 허락, 정당한 보상을 요구하는 내용입니다. 미국 도서유통사 잉그램은 올해 1월부터 AI 회사에 책을 팔고 싶지 않은 출판사가 빠질 수 있게 했습니다.
책 한 권의 값이 두 갈래로 나뉘고 있습니다. 사람에게는 1~2만 원이지만, AI가 배울 때는 해적판으로 약 400만 원, 계약으로 약 670만 원이었어요. 교보문고와 웅진북센이 쓰임새를 모르는 주문은 받지 않겠다고 한 만큼, 한국어 책도 사서 스캔하기보다 출판사와 값을 정하고 쓰는 쪽으로 옮겨 갈 듯싶습니다.