
DeepSeek V4.1 Flash 1017은 정말 Opus 5를 이겼을까?
송찬우 7분 분량
10월 17일, DeepSeek이 V4.1 Flash 1017을 내놨습니다. 스스로 ‘작은 업데이트(minor update)’라고 부른 버전인데, 반응은 전혀 작지 않았습니다. 공식 X 계정의 발표 글은 이틀 만에 조회수 680만, 좋아요 3만 6천을 넘겼고, 허깅페이스에서는 트렌딩 모델 1위에 올랐어요.
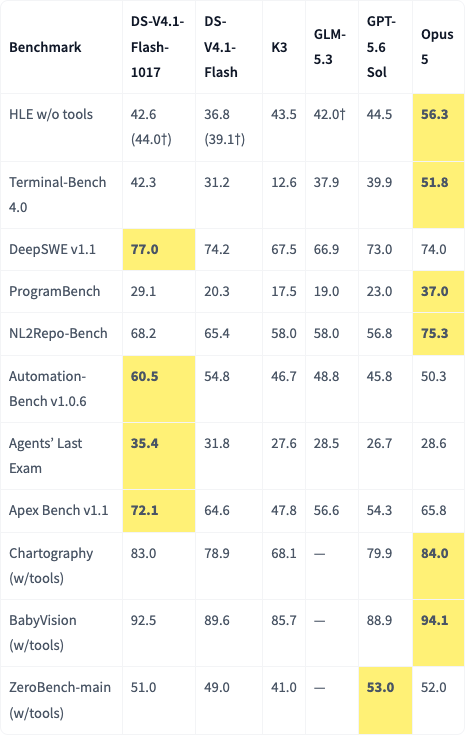
화제가 된 건 모델 카드에 실린 표 한 장입니다. 코딩 에이전트 평가인 DeepSWE에서 77.0점을 받아 Claude Opus 5(74.0)와 GPT-5.6 Sol(73.0)을 앞섰거든요.
그런데 좀 이상하죠. 새 모델도 아니고 ‘작은 업데이트’인데, 어떻게 한 달 남짓 만에 Opus 5를 넘었다는 걸까요?
결론부터 말하면, 모델은 그대로입니다.
1017은 9월 10일에 나온 V4.1 Flash와 규모가 똑같아요. 허깅페이스에 올라온 두 모델의 파라미터 수는 7,632억 531만 5,794개로 마지막 자리까지 같습니다. 구조도 그대로예요. 전체 파라미터는 7,600억 개가 넘지만 토큰 하나를 처리할 때 실제로 쓰는 건 80억~160억 개뿐인 MoE(전문가 혼합) 구조이고, 한 번에 100만 토큰까지 읽습니다.
규모는 그대로인데 점수는 크게 올랐습니다. 이전 V4.1 Flash와 비교하면 터미널 작업 평가(Terminal-Bench 4.0)는 31.2점에서 42.3점으로, ProgramBench는 20.3점에서 29.1점으로 뛰었어요. DeepSeek은 점수는 오르고, 답은 짧아지고, 일은 더 빨리 끝난다며 성능과 비용 모두에서 나아졌다고 소개했습니다.
바뀐 건 ‘연습량’입니다.
DeepSeek은 1017에서 정확히 무엇을 했는지 따로 밝히지 않았습니다. 대신 V4.1 Flash 기술 보고서에 힌트가 있어요. 사후 학습은 SFT, 강화학습(RL), 온폴리시 증류(OPD)로 이어지는 표준 방식을 알고리즘 수정 없이 그대로 썼고, 실질적인 변화는 전부 데이터 쪽에 있다고 적었습니다. 에이전트가 풀 과제와 그 과제를 풀 환경을 자동으로 대량 만들어 내고, 데이터와 과제와 풀어 보는 횟수를 점점 늘렸다는 거죠. 지난달 ‘학습할 데이터는 다 떨어졌을 텐데, AI는 왜 더 좋아질까’에서 소개했던, 채점이 자동으로 되는 시험지를 끝없이 찍어 내 AI를 연습시키는 바로 그 방식입니다.
쉽게 말해 같은 뇌에 문제집을 더 풀린 겁니다. 모델을 처음부터 다시 학습시키려면 몇 달과 막대한 비용이 들지만, 연습은 몇 주 단위로 더 시킬 수 있어요. 1017은 V4.1 Flash가 나온 지 5주 만에 나왔습니다.
Z.ai의 GLM-5.3도 기반 모델은 GLM-5.2 그대로였는데, 연습 환경을 늘려 자체 평가 점수를 50% 끌어올렸죠. 이제 모델 경쟁은 누가 더 큰 모델을 새로 만드느냐보다, 누가 더 많은 연습장을 만드느냐로 옮겨 가고 있어요.
그럼 정말 Opus 5를 이겼을까요?
표를 끝까지 보면 이야기가 조금 달라집니다. 모델 카드에서 Opus 5와 나란히 비교한 평가는 11개인데, 1017이 이긴 건 4개예요.
- 이긴 평가: DeepSWE 77.0 대 74.0, Automation-Bench 60.5 대 50.3, Agents’ Last Exam 35.4 대 28.6, Apex Bench 72.1 대 65.8
- 크게 진 평가: HLE(도구 없이) 42.6 대 56.3, Terminal-Bench 4.0 42.3 대 51.8, ProgramBench 29.1 대 37.0, NL2Repo-Bench 68.2 대 75.3
- 나머지 이미지 이해 평가 3개는 1~2점 차로 졌습니다.
에이전트처럼 여러 단계를 거쳐 일을 처리하는 평가에서는 앞섰지만, 아주 어려운 문제를 푸는 추론(HLE)이나 터미널 작업에서는 9~14점 차로 뒤졌어요.
그리고 하나 더. 비교 대상은 Opus 5입니다. Anthropic은 9월 22일에 Opus 5.5를 냈고, 스스로 Opus 5보다 큰 폭으로 좋아졌다고 밝혔어요. 1017과 Opus 5.5를 나란히 놓은 공식 표는 아직 없습니다. 그러니 정확히 말하면 “한 세대 전 Opus 5를, 에이전트 평가 몇 개에서 이겼다” 정도예요.
진짜 무기는 가격입니다.
그런데도 사람들이 열광하는 이유는 점수보다 가격이에요. DeepSeek API에서 1017의 출력 가격은 100만 토큰당 1.2달러, 한가한 시간에는 0.6달러입니다. Opus 5.5는 20달러, Opus 5는 25달러예요. 출력 기준으로 Opus 5.5보다 약 17배, 한가한 시간에는 33배 쌉니다. 입력도 0.3달러 대 4달러로 13배쯤 차이가 나고요.
X에서 퍼진 것도 이 대목입니다. 한 사용자는 같은 로켓 발사 장면을 만들게 했더니 GPT-6.1 Sol은 6.10달러에 5분, 1017은 0.78달러에 3분이 걸렸다며 결과를 비교했어요. “Opus 5급”보다 “이 가격에 이 정도?”라는 반응이 훨씬 많습니다.
한국에서 쓴다면 시간대도 챙겨야 합니다. DeepSeek은 평일 피크 시간에 두 배를 받는데, 한국 시간으로 오전 10시~오후 1시, 오후 3시~7시입니다. 하필 업무 시간과 많이 겹치죠. 이 시간을 피하면 절반 가격이고, 주말과 중국 공휴일은 종일 할인이에요.
누구나 받아 쓸 수 있습니다. 다만…
가중치는 MIT 라이선스로 공개돼서 누구나 내려받아 고치고 상업적으로 써도 됩니다. 다만 직접 돌리려면 장비가 만만치 않습니다. 내려받는 파일만 510GB예요.
원본 그대로는 GPU 8장이 기본입니다. DeepSeek이 공개한 실행 코드는 모델을 GPU 8장에 나눠 싣고, 전문가 부분은 4비트, 나머지는 8비트로 돌립니다. 80GB짜리 H100으로 치면 8장(640GB)은 있어야 가중치를 올리고 문맥을 담을 자리가 남습니다. AWS 같은 클라우드에서 H100 8장이 달린 서버를 빌리면 시간당 약 55달러(약 7만 3천 원), 한 달 내내 켜 두면 약 4만 달러(약 5,300만 원)입니다.
개인 장비로는 맥 스튜디오가 현실적인 선입니다. 일본 회사 엘브즈는 2비트로 줄인 버전을 메모리 512GB짜리 맥 스튜디오(M3 Ultra) 한 대에서 돌려 초당 약 36토큰을 냈습니다. 1,960억 개짜리 기억 표(Engram)는 필요한 줄만 그때그때 읽어서, 메모리에 늘 올려 두는 건 약 152GiB뿐이라고 해요. 다만 이 파일은 엘브즈 엔진에서만 돌아갑니다. 지금 파는 M5 Ultra 맥 스튜디오는 949만 원부터이고, 512GB 메모리 옵션은 10월 하순에 나옵니다.
그래서 실제로는 대부분 API로 쓰게 됩니다. Anthropic API 형식도 지원해서 Claude Code 같은 도구에 백엔드로 바로 붙일 수 있습니다. DeepSeek이 Terminal-Bench 점수를 잴 때 쓴 도구도 Claude Code였고요. 기존 deepseek-v4-flash 이름으로 호출하던 서비스는 따로 손대지 않아도 1017로 바뀌었습니다.
다음 모델을 기다리지 않아도 되는 시대
예전에는 모델이 좋아지려면 다음 버전을 기다려야 했습니다. 이제는 같은 모델이 몇 주 만에 한 단계씩 올라가요. 연습장만 늘리면 되니까요. 그래서 “어떤 모델이 1등이냐”보다 “내 일에 맞는 평가에서, 이 가격에, 충분하냐”를 묻는 게 더 중요해졌습니다.