
Mistral Timestral은 주가도 맞힐 수 있을까?
송찬우 7분 분량
10월 15일(현지 시간) Mistral이 첫 시계열 예측 모델 Timestral을 공개했습니다. 시계열은 공장 센서 값, 전력 사용량, 매출처럼 시간 순서대로 쌓이는 숫자를 말합니다. 가장 큰 Timestral-209M이 이 분야의 대표 벤치마크 세 개인 GIFT-Eval, TIME, fev-bench에서 모두 1위를 했다고 하고, GPU 없이 CPU만으로 돈다는 점이 눈길을 끌었어요. 10월 19일 해커뉴스 첫 화면에 올라 10월 20일 기준 564점, 댓글 105개를 모았습니다.
시간 순서대로 쌓인 숫자의 다음 값을 맞히는 모델이라고 하면 가장 먼저 떠오르는 건 주가입니다. Timestral은 주가도 맞힐 수 있을까요?
결론부터 말하면, 주가를 맞히라고 만든 모델은 아닙니다.
Mistral이 블로그에서 든 쓰임새는 설비 용량 계획, 에너지, 공급망, 리스크 관리, 유지보수입니다. 금융도 나오지만 자금 흐름과 거래량, 변동성을 예측해 헤지와 자금 운용에 쓰는 이야기이고, 주가가 오를지 내릴지를 맞히는 이야기는 아닙니다.
해커뉴스 반응도 비슷했습니다. 한 사용자는 서버 부하처럼 조금 틀려도 바로 고칠 수 있는 예측에 맞는 모델이라며, 주식을 살지 말지 정하는 데 쓰지는 않을 것이라고 적었어요. 비트코인 가격 예측 모델 약 20개의 성적을 직접 기록해 온 다른 사용자는, 백테스트에서 훌륭해 보였던 유명 모델이 지난 1년 동안 100% 넘게 빗나갔다며 “내일은 오늘과 같다”는 가장 단순한 예측과 나란히 비교해야 한다고 했습니다.
Mistral도 이 함정을 알고 있습니다. 미세조정 도구 Mistral Forge를 소개하며, 학습 데이터를 직접 통제할 수 있으니 백테스트하는 구간을 모델이 사전학습 때 미리 보지 않았다고 보장할 수 있다고 적었어요. 지난달 ‘주식 자동매매 해주는 주식 AI 에이전트’에서 소개했던, 모델이 이미 아는 과거로 성적을 매기는 시간적 지식 유출 바로 그 문제입니다.
잘하는 건 센서처럼 패턴이 있는 숫자입니다.
Timestral이 내세우는 건 반복되는 패턴과 미리 알려진 사정을 함께 읽는 능력입니다. 펌프의 진동, 온도, 압력은 따로 움직이지 않으니 셋을 한꺼번에 예측합니다. 요일이나 장비 상태(가동, 대기, 정비 중) 같은 범주 값도 그대로 받고, 생산 일정이나 계획된 가동 중단, 기상 예보처럼 미래 값을 이미 아는 변수도 넣을 수 있어요. 그래서 예정된 부하 증가를 이상 신호로 착각하지 않습니다.
답도 숫자 하나가 아니라 21개 분위수로 냅니다. 다음 값이 어느 정도 범위 안에 들어올지까지 보여 주니, 경보 기준을 불확실성에 맞춰 잡을 수 있습니다. 학습 데이터는 대부분 직접 만든 합성 데이터라고 합니다. 추세와 계절성, 잡음을 섞은 시계열로 먼저 사전학습하고, 실제 데이터와 합성 데이터를 섞어 4배 긴 맥락으로 다시 학습했어요. 그래서 처음 보는 데이터도 따로 학습시키지 않고 바로 예측합니다.
공장에서는 에이전트와 짝을 이룹니다.
Mistral 블로그에서 가장 공들인 대목은 공장 예시입니다. 센서 수천 개가 달린 공장에서 Timestral이 센서 값을 계속 지켜보다가 펌프에서 이상 신호를 잡으면, 에이전트가 그 신호를 과거 센서 기록과 비교해 비슷했던 고장 사례를 찾습니다. 이어서 하위 에이전트들이 정비 기록, 근무 일지, 작업자 메모, 설비 매뉴얼, 지난 작업 지시서를 뒤져 원인을 분석하고, 근거와 다음 조치를 붙인 진단안을 씁니다. 공장장은 경보 한 줄 대신 근거가 붙은 진단과 계획을 받게 되는 구조예요.
언어 모델이 센서 수천 개의 숫자를 직접 읽기는 어렵습니다. 숫자를 지켜보는 일은 작은 시계열 모델이 맡고, 기록을 찾아 원인을 설명하는 일은 언어 모델 에이전트가 맡는 분담입니다. X에서 Timestral을 소개한 David Hendrickson은 쓸모 있는 AI 모델이 다 말을 할 필요는 없다고 적었고, 이 글은 조회수 9만 6천, 좋아요 2,508개를 모았어요. 다만 이 공장 예시는 실제 고객 사례가 아니라 Mistral이 그린 구상입니다. 해커뉴스에서도 실제 도입 사례 대신 가상의 고객을 내세웠다는 지적이 나왔습니다.
벤치마크 1위는 맞지만, 차이는 작습니다.
Mistral에 따르면 Timestral-209M은 사전학습 후 따로 학습하지 않는 제로샷 모델 가운데 세 벤치마크의 다섯 지표에서 모두 1위입니다. 앙상블 없이 체크포인트 하나로 낸 결과이고, GIFT-Eval과 TIME 순위표에는 결과를 제출해 둔 상태예요. 이전 최고 모델보다 파라미터가 3분의 2뿐인데도 앞섰고, 28M 모델은 약 4배 큰 Chronos-2를 GIFT-Eval과 TIME에서 이겼습니다.
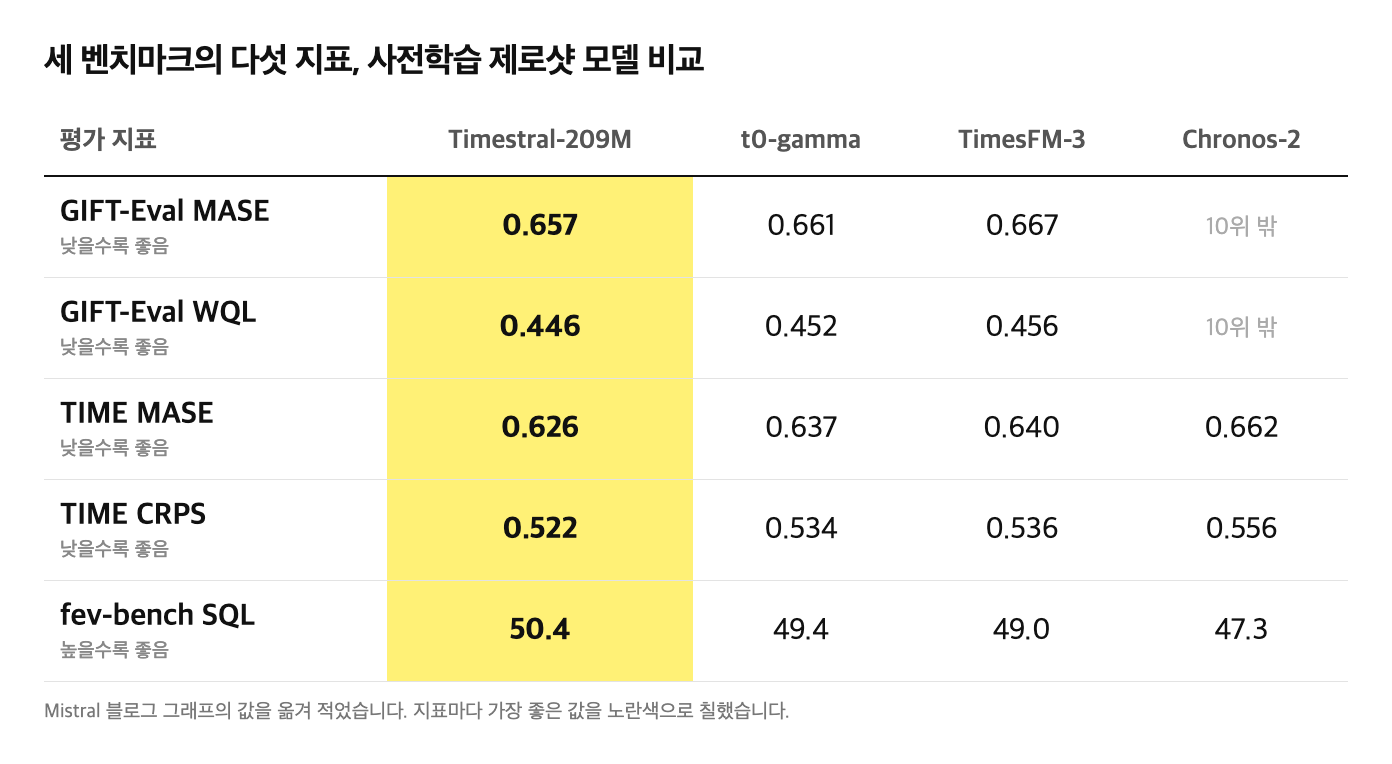
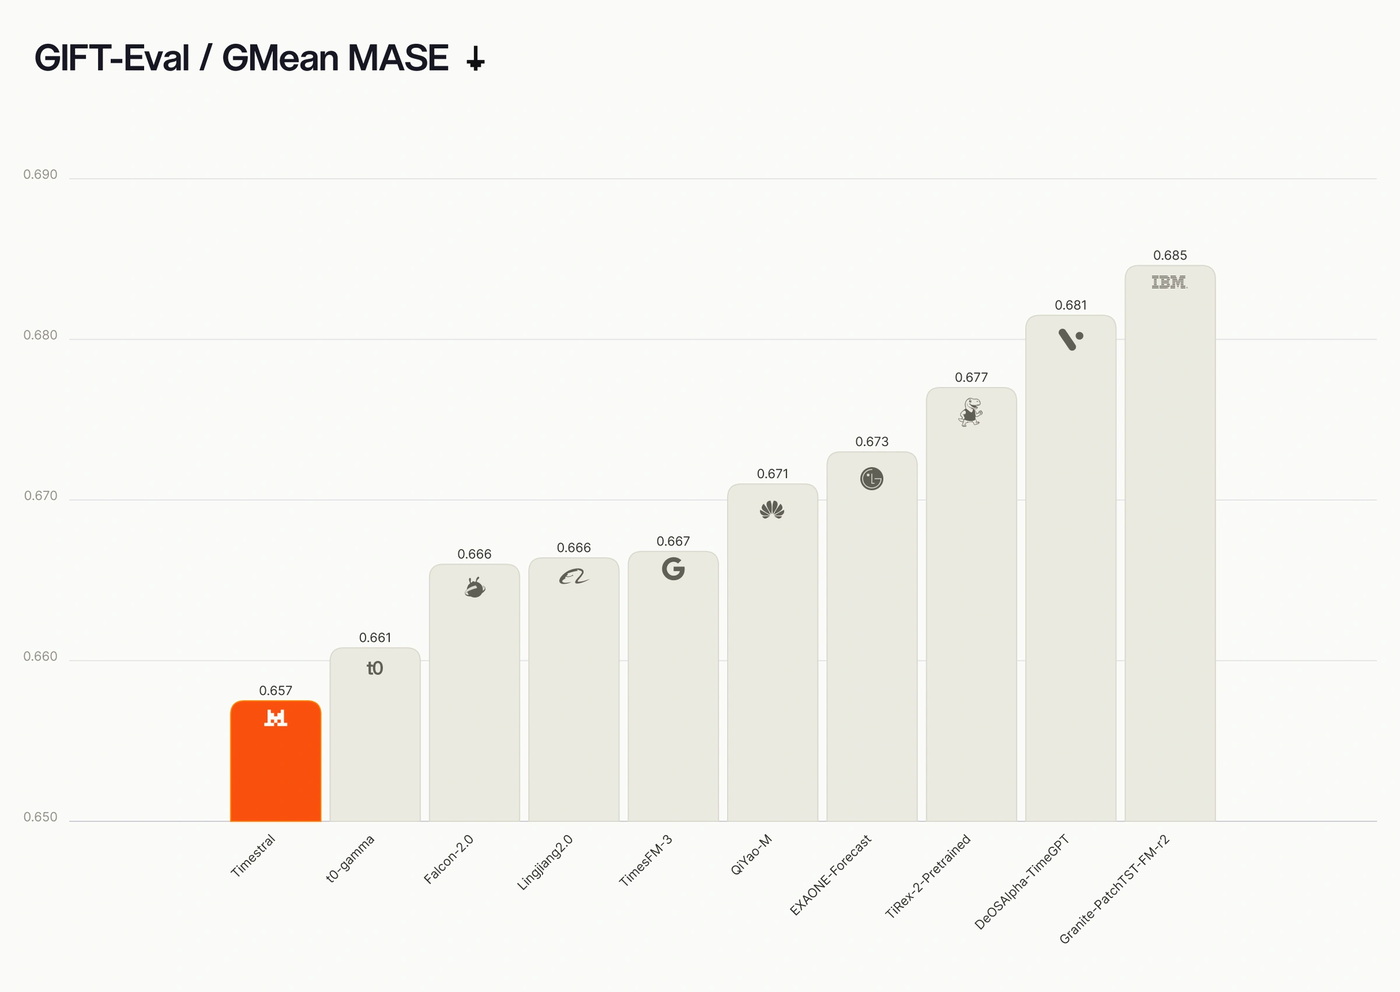
그런데 숫자를 나란히 놓으면 차이는 크지 않습니다. GIFT-Eval MASE는 0.657 대 0.661, fev-bench는 50.4 대 49.4입니다. 해커뉴스에서는 0.03 정도의 개선을 다섯 배 차이처럼 보이게 그렸다는 댓글이 달렸어요. 실제로 블로그 그래프의 세로축은 0.650에서 시작해서, 1위 0.657과 10위 0.685의 막대 높이가 다섯 배 가까이 차이 나 보입니다. 전체 결과를 담은 기술 보고서는 아직 나오지 않았습니다.
돌리는 데 GPU는 필요 없습니다.
Timestral은 오픈 웨이트 모델이라 허깅페이스에서 가중치를 받아 직접 돌릴 수 있습니다. 파일 크기는 5M이 21MB, 28M이 111MB, 123M이 490MB, 가장 큰 209M도 837MB입니다. 깃허브 코드는 PyTorch, NumPy 정도만 있으면 설치되고, 맥락은 최대 32,768개 시점까지 넣을 수 있어요. 15분 간격 데이터라면 약 341일치입니다.
속도도 빠릅니다. 8스레드 서버 CPU에서 15분 간격 데이터 3주치를 넣고 다음 하루를 예측하는 데 5M은 10ms, 209M은 140ms가 걸렸다고 합니다. 28M은 209M보다 5배 빠르고, 123M은 209M 점수와 0.2% 안쪽 차이로 시간은 4분의 3만 씁니다. 이 정도 CPU를 AWS에서 빌리면 vCPU 8개짜리 c7i.2xlarge가 시간당 0.357달러(약 470원), 한 달 내내 켜 두면 약 257달러(약 34만 원)입니다.
걸리는 건 라이선스입니다. 코드는 Apache 2.0이지만 가중치는 Modified MIT라는 별도 라이선스인데, 쓰는 회사(개인이라면 다니는 회사)의 전 세계 연결 기준 월 매출이 직전 달에 2천만 달러(약 266억 원)를 넘으면 쓸 수 없다는 조건이 붙어 있습니다. 연 매출로 치면 약 2억 4천만 달러(약 3,190억 원) 규모라, 국내 대형 제조사는 Mistral과 상용 라이선스를 따로 맺거나 Mistral의 호스팅 서비스를 써야 합니다. 해커뉴스에서도 성능은 인상적인데 라이선스가 아쉽다는 반응이 나왔어요. 자기 데이터로 미세조정하려면 Mistral Forge를 쓰는데, 고객사 서버나 인터넷이 끊긴 환경에도 설치할 수 있다고 합니다.
언어 모델이 말로 일하는 동안, 숫자를 지켜보는 작은 모델이 그 옆에 붙는 구성이 하나둘 나오고 있습니다. 주가를 맞혀 주는 모델은 아니지만, 센서와 수요처럼 패턴이 있는 숫자를 다루는 현장이라면 GPU 없이 바로 시험해 볼 선택지가 하나 늘어난 것 같습니다.