주식 자동매매 해주는 주식 AI 에이전트
송찬우 5분 분량
AI가 이렇게 활발히 있기 전부터, 많은 연구 기관과 기업에서 알고리즘을 통해 주식 매매를 사람 대신해 수익률을 낼 수 있는 방법을 연구해왔습니다. 대부분 시계열 데이터를 예측하는 모델을 개선하거나, 이 모델에 넣을 파라미터를 개선하는 방향으로 진행해왔습니다. 정해둔 뉴스 창구에서 부정적인 뉴스가 많은지, 긍정적인 뉴스가 많은지 등이요.
요즘 AI 모델에 스킬을 붙이는 게 뭐 큰 일도 아닐 정도로 대중화되고 있는 마당에, 여기서 ‘Tauric Research’라는 조직이 등장합니다.
타우릭 리서치는 UCLA 컴퓨터과학과 박사과정생, Yijia Xiao가 만든 스타트업입니다. 연구 조직이기 때문에, “연구자와 기업에서 지능형 트레이딩 시스템을 개발 및 배포할 수 있도록, 모듈화된 AI 기반 플랫폼, 프레임워크를 제공하는 것”이 타우릭 리서치의 미션이라고 밝히고 있습니다.
오픈소스로 풀린 TradingAgents와 논문으로 공개된 Trading-R1이 주목받고 있습니다. (GitHub 기준 103k 스타)
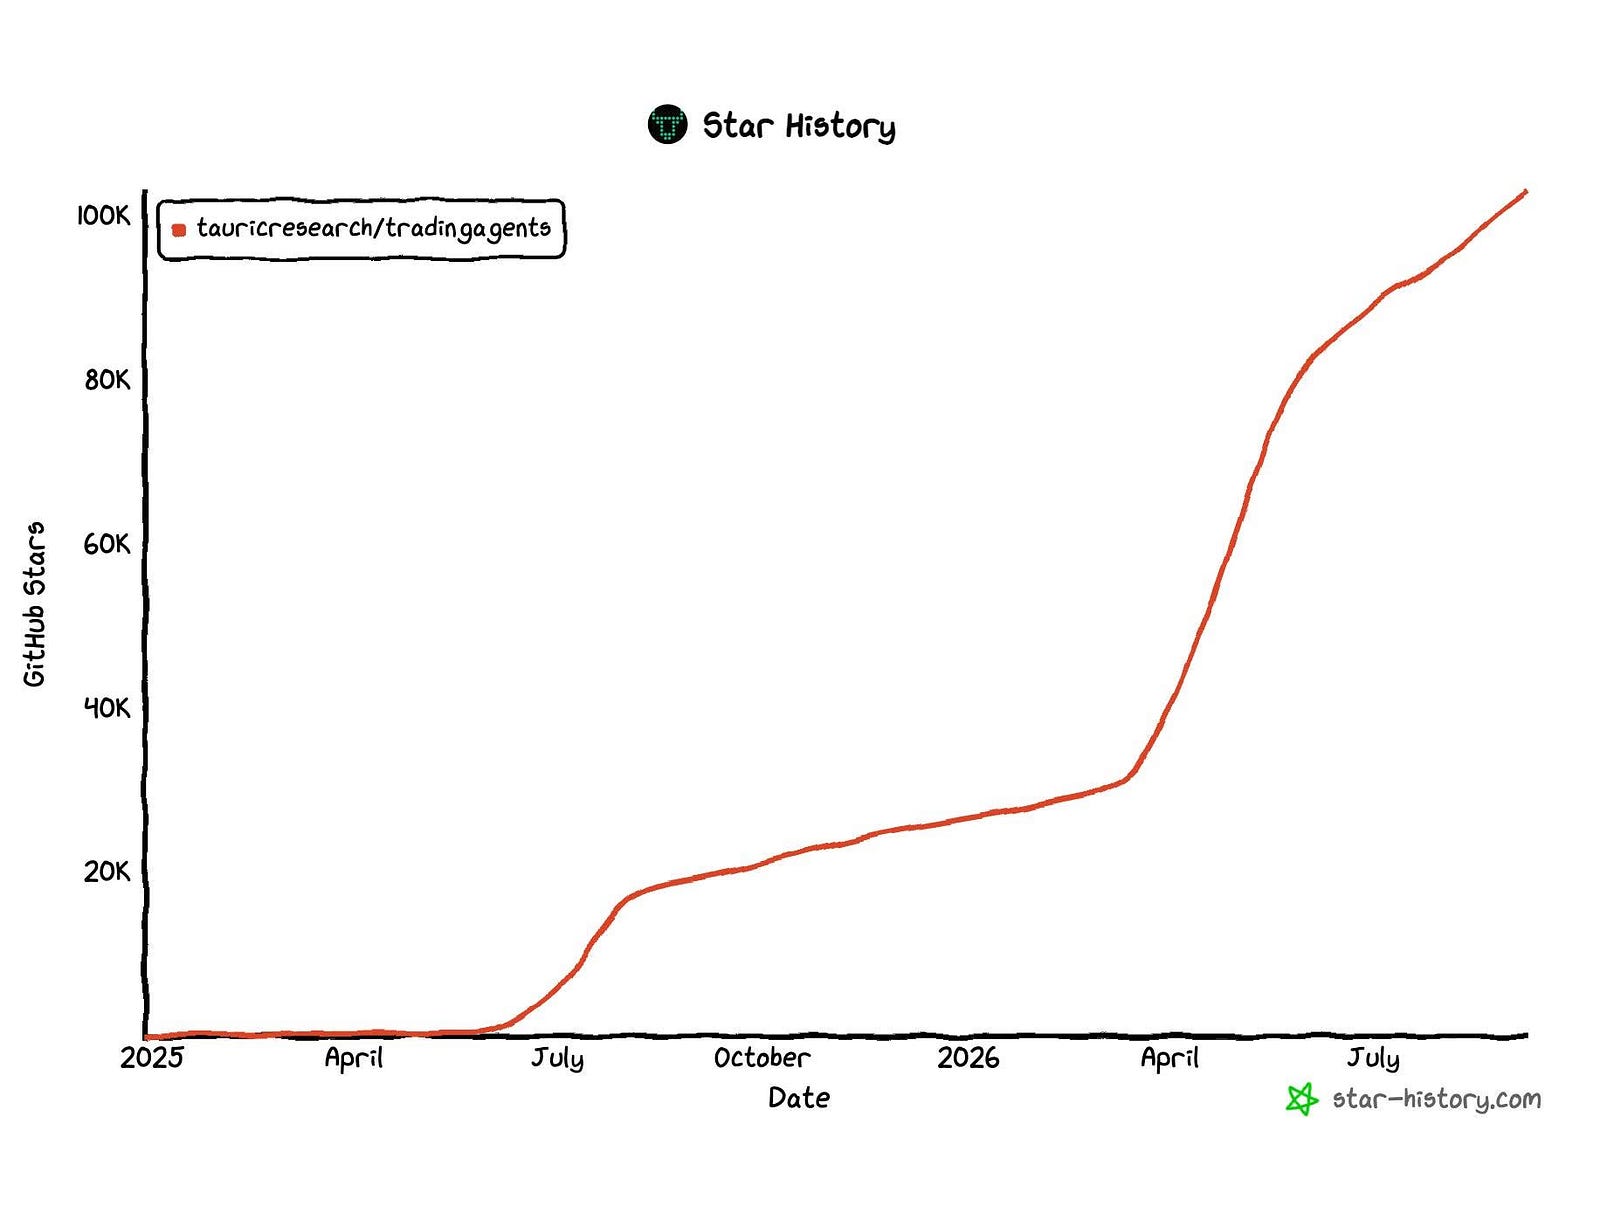
TradingAgents의 발상은 단순합니다. 일종의 자산운용사 회사 조직도를 그대로 옮긴 겁니다.
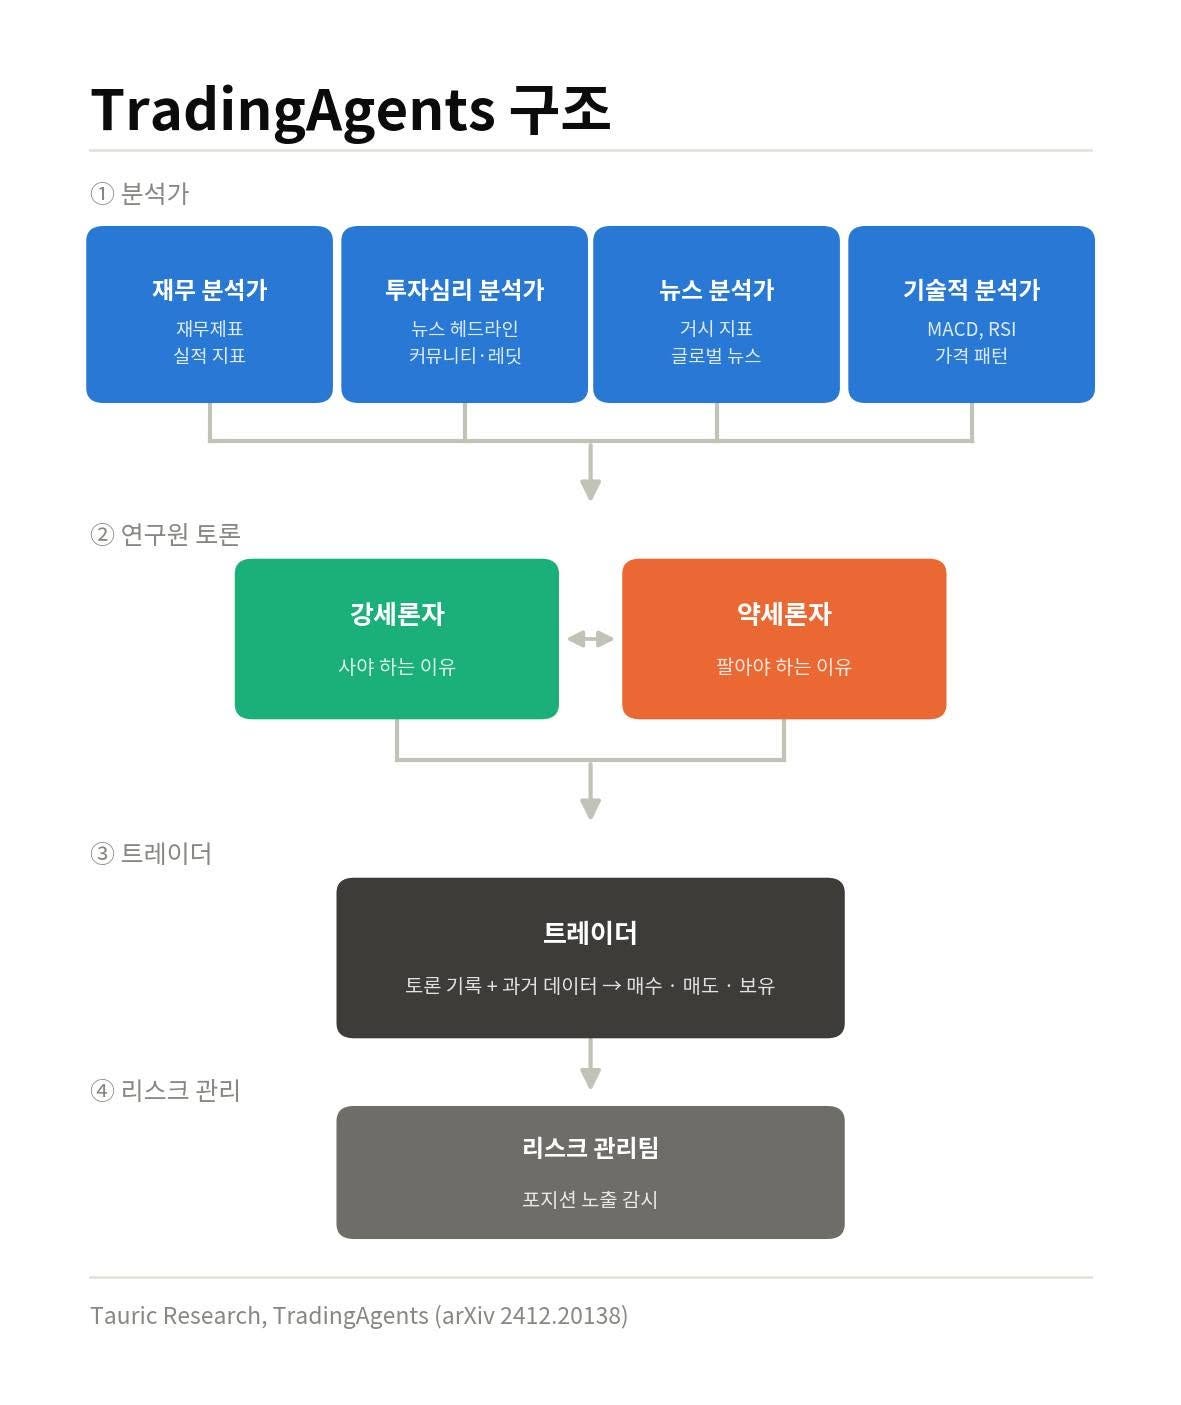
맨 앞에 분석가 넷이 섭니다. 재무 분석가는 재무제표와 실적 지표를 보고 내재가치와 위험 신호를 찾습니다. 투자심리 분석가는 뉴스 헤드라인과 StockTwits, 레딧 게시물을 모아 단기 시장 심리를 하나의 수치로 뽑습니다. 뉴스 분석가는 거시 지표와 글로벌 뉴스를 봅니다. 기술적 분석가는 MACD와 RSI 같은 지표로 패턴을 읽고요.
여기까지는 예상 가능한데, 그다음이 재밌습니다. 강세론자와 약세론자 연구원이 서로 토론합니다. 한쪽은 사야 하는 이유를, 다른 쪽은 팔아야 하는 이유를 대며 붙습니다. 트레이더가 그 토론 기록과 과거 데이터를 종합해 매수·매도·보유를 결정하고, 리스크 관리팀이 노출을 감시합니다.
설계상 영리한 점도 있습니다. GPU가 필요 없습니다. API 크레딧만 있으면 돌아가고, 역할마다 다른 모델을 붙일 수 있어요. 깊은 추론이 필요한 자리엔 비싼 모델을, 단순 작업엔 싼 모델을 씁니다.
그래서 성과는 어땠을까요.
논문은 좋은 숫자를 내놨습니다. 누적 수익률 23.21% 이상, 샤프지수 5.60 이상. 매수 후 보유, MACD, KDJ+RSI, ZMR, SMA 다섯 가지 기준 전략을 모두 이겼습니다. 회사 홈페이지에는 연 30.5% 수익률이라고 걸려 있고요.
그런데 실험 조건을 보면 얘기가 달라집니다.
2024년 1월 1일부터 3월 29일까지. 석 달입니다. 종목은 애플, 엔비디아, 마이크로소프트, 메타, 구글 다섯 개. 전부 대형 기술주고, 그 석 달은 엔비디아가 폭등하던 강세장이었습니다.
이걸 두고 올해 3월에 나온 서베이가 직설적으로 지적합니다. 석 달짜리 상승장 구간 하나로 샤프지수 5.60에서 8.21을 보고한 건 우월성의 증명이 아니라 시간적 견고함의 필요성(아무때나 해도 이런 일정함이 보장되는가)을 보여주는 사례라고요.
제가 지나가면서 봤던 극히 일부는 수익률을 보는 사람도 있었던 것 같은데요 (아마도 기존에도 투자를 하던?). 대다수는 수익률이 마이너스였다는 실험 보고가 많았습니다.
본 논문에서도, 다른 LLM 투자 연구에서도 말하길, 큰 한계점으로 시사되는 것은 “시간적 지식 유출”이라고 말합니다.
예를 들어 저희가 2024년 2월의 엔비디아 뉴스를 모델에게 주고, 이걸 어떻게 해석할지를 물어봅니다. 프롬프트에는 당연히 2월에 해당하는 뉴스가 들어갈 겁니다. 하지만, LLM의 특성상, 2024년 2월 이후에 학습된 모델이라면 해당 시점에 주가가 올랐는지, 내렸는지를 기억할 겁니다. 그런 식으로 과거의 데이터를 이미 학습해버려 편향성이 생기고, 일정한 분석을 보장받지 못하게 됩니다.
그래서 지금 이 분야는 방향을 틀고 있습니다. 과거를 되짚는 백테스트로는 증명이 안 되니, 학습 컷오프(사전학습) 이후 구간에서 실시간으로 굴려보자는 쪽으로요. 아직 안 일어난 일은 모델도 모르니까요. LiveTradeBench, Agent Market Arena 같은 것들이 그 흐름입니다.
다만 여기서도 새 문제가 나옵니다. 실시간 평가는 특정 시점에 묶여 있어서 남이 똑같이 재현할 수가 없고, LLM은 같은 조건으로 돌려도 매번 다른 매매 판단을 내놓습니다. 한 번의 실시간 결과도 못 믿는다는 지적이 나오는 이유고요.
정리하면 이렇습니다.
발상은 좋습니다. 자산운용사의 의사결정 구조를 옮기고, 강세론자와 약세론자를 붙여 토론시키고, 그 과정을 사람이 읽을 수 있게 남긴다는 것. 기존 퀀트 모델(수학적 예측 모델)에 없던 설명 가능성이고, 규제 산업에서는 그게 성능만큼 중요합니다.
다만 성능이 증명됐다고 말하기엔 아직 이릅니다. 논문은 실험 조건을 정직하게 밝혔습니다. 2024년 1월부터 3월까지, 석 달, 다섯 종목. 그런데 제품 페이지로 넘어가면 그 조건은 사라지고 “연 30.5%”만 있죠.
공식 깃허브에도 이런 문장이 있습니다. “이 프레임워크는 연구 목적으로 설계됐으며 금융, 투자, 거래 조언이 아니라는 것. 성과는 백본 모델, 온도 설정, 거래 기간, 데이터 품질에 따라 달라진다”고요.
이 문장이, 지금으로선 가장 정확한 요약인 것 같습니다.
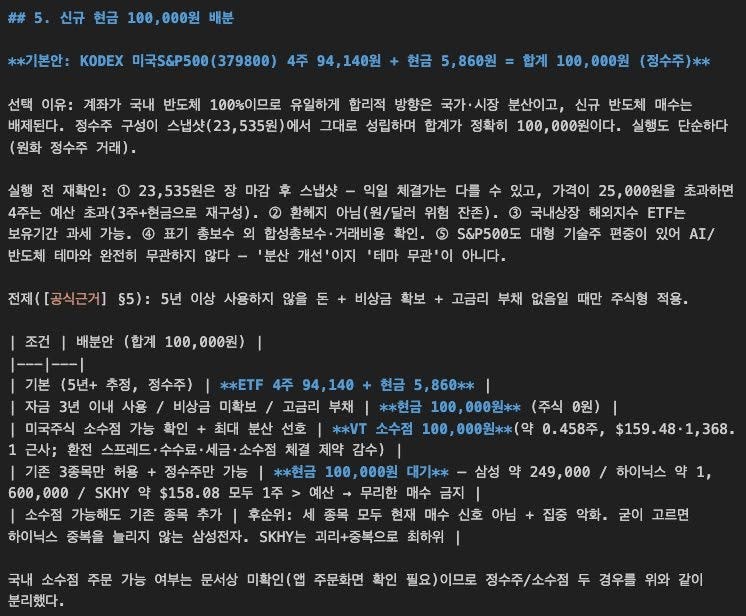
ps. TradingAgents에게 물어보니, S&P 500 주식을 투자하라고 하네요!