
OpenAI도 자체 Git 서버 Pando를 공개했습니다
송찬우 5분 분량
이 글은 한국어로만 제공돼요. English articles →

지난달 ‘Anthropic은 왜 Git을 버리고 Scion을 만들었을까?’에서 Anthropic이 모노레포를 Git에서 자체 버전 관리 시스템 Scion으로 옮긴 이야기를 소개했었죠. 이번에는 OpenAI가 자체 Git 서버를 공개했습니다. 두 회사 모두 에이전트가 쓰는 코드가 늘면서 기존 소스 관리 인프라가 한계에 부딪혔다고 밝혔어요.
11월 2일(미국 시간) OpenAI가 엔지니어링 블로그에 ‘Scaling Git at OpenAI’라는 글을 올렸습니다. OpenAI 모노레포(회사 코드 대부분을 담은 하나의 저장소)에 들어오는 커밋이 Codex 이후 감당하기 어려울 만큼 늘어서, Git과 호환되는 저장소 백엔드 Pando를 새로 만들었다는 내용이에요. 지금은 이 모노레포의 모든 개발이 Pando 위에서 돌아가고, push 지연의 중간값은 약 80% 줄었고, 하루에 1PB 가까운 Git 데이터를 내보낸다고 밝혔습니다.
OpenAI Developers 계정의 소개 글은 조회 48만, 좋아요 3,500을 넘겼어요. Greg Brockman은 Git을 그대로 쓰는 어려운 길을 택해서 개발자 경험을 바꾸지 않고 Pando를 붙일 수 있었다며, 다른 회사에 제공하는 것도 검토하고 있다고 적었습니다.
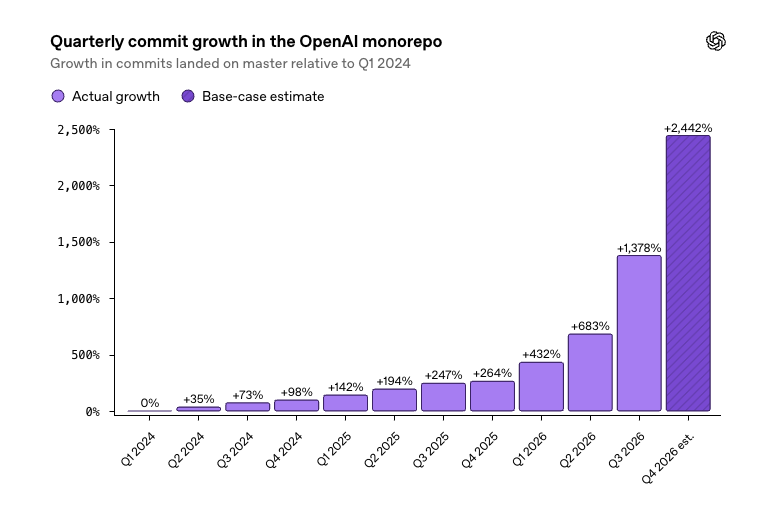
커밋은 2년 반 만에 약 15배가 됐습니다.
OpenAI가 공개한 차트는 master 브랜치에 들어간 커밋 수를 2024년 1분기와 비교한 값입니다. 2025년 4분기까지는 +264%로 완만했는데, 2026년 들어 1분기 +432%, 2분기 +683%, 3분기 +1,378%로 가팔라졌어요. 3분기에는 2024년 1분기의 약 15배가 들어간 셈입니다. 4분기 예상치는 +2,442%예요.
OpenAI는 원인으로 Codex를 들었습니다. 엔지니어 한 명이 여러 변경을 동시에 CI에 올리고, push 하나가 여러 작업을 띄워 같은 커밋을 또 받아 갑니다. 브랜치, push, 머지, 그리고 개발 환경과 연구 작업, CI에서 오는 fetch와 clone이 함께 늘어났어요. 2025년 말부터 fetch와 push가 느려지고 머지가 실패했고, 안정성이 90% 아래로 떨어진 때도 있었다고 적었습니다.
Git은 그대로 두고 서버만 바꿨습니다.
OpenAI는 Git을 버리지 않았습니다. 자체 클라이언트와 프로토콜을 쓰는 Scion으로 Git을 대신한 Anthropic과 가장 다른 점이에요. 엔지니어와 에이전트가 쓰는 Git 클라이언트와 작업 방식은 그대로 두고, 그 뒤의 서버 구조를 다시 짰어요. 바꾼 건 두 가지입니다.
- 저장소 전체의 순서를 맞추지 않고 브랜치마다 따로 순서를 맞춥니다. 서로 다른 브랜치에 들어오는 push는 서로 기다리지 않고, 같은 브랜치에 동시에 push할 때만 충돌합니다.
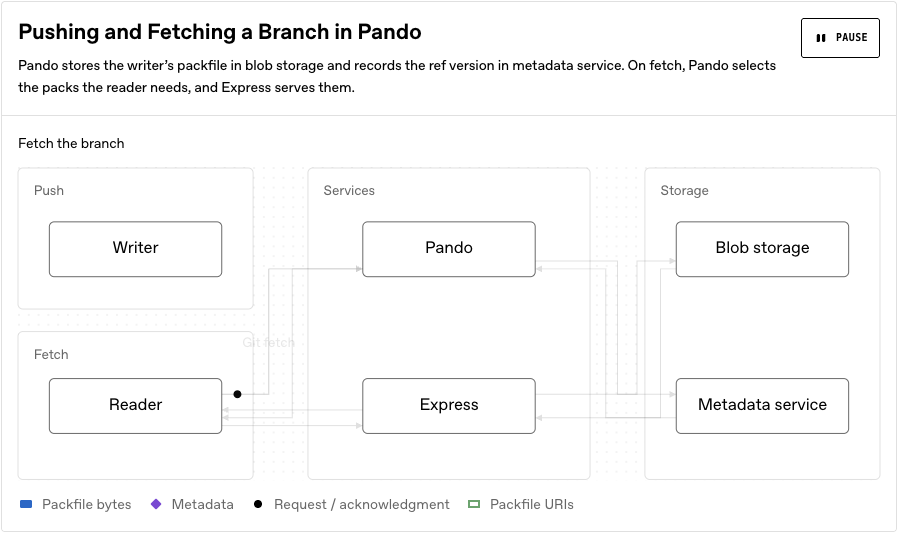
- push로 받은 묶음 파일(packfile)을 그대로 보관했다가, 다른 사람이 같은 브랜치를 받을 때 다시 내보냅니다. 받는 사람마다 묶음을 새로 계산하지 않으니 서버는 거의 계산을 하지 않고 캐시에서 내보내기만 해요.
대가도 있습니다. 여러 브랜치를 한꺼번에 보는 쪽에서는 브랜치마다 다른 시점의 상태가 보일 수 있어요. OpenAI는 사용자도 에이전트도 저장소 전체의 순서보다 자기 브랜치 하나의 순서에 기대어 일하기 때문에 문제가 되지 않는다고 설명했습니다. push할 때 서버가 보여 주는 브랜치도 trunk 하나로 줄였는데, 브랜치가 수백만 개면 그 목록만 100MiB를 넘을 수 있기 때문이에요. 이렇게 만든 push 묶음의 중간값은 20KiB 아래, 상위 1%도 3MiB 아래였다고 합니다.
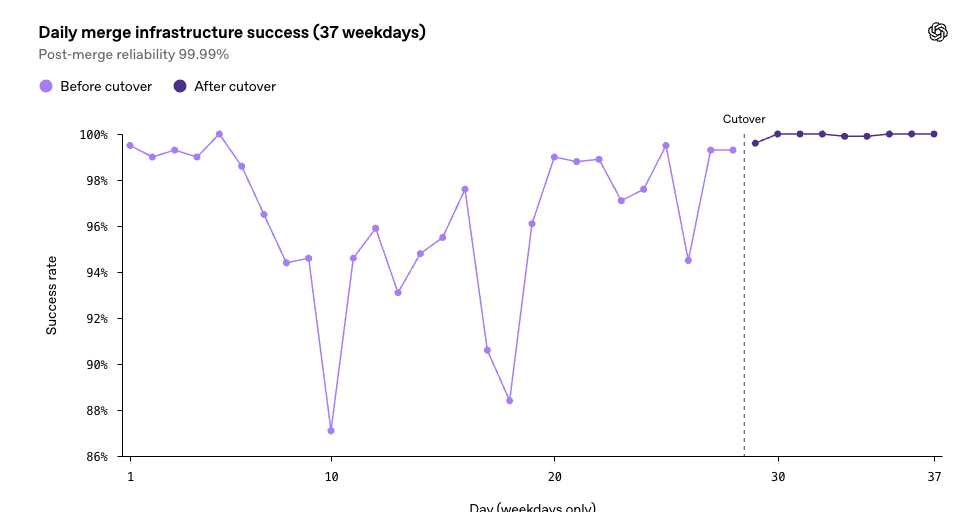
push 지연은 약 80% 줄었습니다.
Pando로 옮긴 뒤 push 지연의 중간값은 약 80% 줄었고, 머지 안정성도 좋아졌습니다. 공개한 그래프를 보면 전환 전 37일 가운데 머지 성공률이 87%대까지 떨어진 날이 있었는데, 전환 뒤에는 100% 가까이에서 움직였고 머지 후 안정성은 99.99%였어요. 한 시간에 57TB가 넘는 Git 데이터를 내보낸 적도 있고, 그 99% 이상이 로컬 디스크 캐시에서 나갔다고 합니다. 클라우드의 일반 가상 머신만으로 clone과 fetch가 10Gbps 회선을 꽉 채우는 것도 확인했다고 밝혔어요.
Pando도 에이전트가 만들었습니다.
이 글에서 가장 눈에 띄는 대목은 만든 방식입니다. OpenAI는 Codex로 Pando를 만들어 착수부터 실서비스까지 10주가 걸렸다고 밝혔어요. 핵심 설계는 엔지니어 한 명이 했고, 구현은 에이전트 팀이, 배포는 엔지니어 몇 명이 맡았습니다. 2026년 4월부터 실제 트래픽을 받기 시작했다고 합니다.
에이전트가 만든 코드를 믿기 위한 장치도 함께 적었습니다.
- 기존 의존성 없이 Rust로 새로 짰습니다.
- 표준 Git 동작과 비교하는 적합성 테스트를 만들어, 에이전트가 고친 코드를 바로 시험할 수 있게 했습니다.
- 같은 조건을 그대로 다시 돌릴 수 있는 시뮬레이션 테스트로 경쟁 상태나 회귀 같은 미묘한 버그를 찾았습니다.
- GPT-6 Astra를 쓰는 에이전트가 Lean과 TLA+로 Pando의 동작을 수학적으로 정리했고, 이걸로 구현의 버그를 찾아 고치고 시스템의 성질을 증명했습니다. 이런 세션이 수백 시간씩 이어졌어요.
- 지금도 에이전트가 하루 종일 Git과 Pando의 보안 약점을 찾고 있습니다.
옮기는 일도 Codex가 도왔습니다. 기존 저장소를 준비하고 새 시스템을 쓰는 방법을 스킬로 만들어 두었고, 개발자는 Codex에게 자기 개발 환경과 서비스를 옮겨 달라고 하면 됐다고 합니다. 처음에는 기존 시스템 앞에 Pando를 두고 읽기와 쓰기를 모두 넘겨주는 방식으로 붙여서, 중단 없이 트래픽을 옮겼어요. Git 자체에서 찾은 버그와 개선점은 Git 프로젝트에 다시 보냈고, 일부는 이미 반영됐다고 밝혔습니다.
버그를 찾는 쪽에서도 같은 일이 벌어지고 있습니다.
코드를 쓰는 속도가 빨라지자 저장소가 병목이 된 것처럼, 버그를 찾는 속도가 빨라지자 사람의 리뷰가 병목이 된 곳도 있습니다. PostgreSQL 커미터 Robert Haas는 10월 30일(미국 시간) 블로그에 PostgreSQL 19 출시가 늦어진 이유가 AI라고 적었어요. 지난 10년 동안 PostgreSQL 메이저 버전은 9월 중순에서 10월 중순 사이에 나왔는데, 이번에는 11월로 밀릴 가능성이 크다고 합니다. 8월 27일부터 9월 15일 사이에는 SQL/PGQ 같은 큰 기능 세 개가 빠졌어요.
Haas가 든 숫자는 커밋 수입니다. 기능 동결일인 4월 8일부터 9월 25일까지, 출시를 준비하는 버전 브랜치에 들어간 커밋은 2025년 724개에서 2026년 1,169개로 60% 넘게 늘었습니다. 이전 버전까지 고친 커밋도 248개에서 433개로 74% 넘게 늘었어요. 반대로 master에만 들어간 커밋은 오히려 조금 줄었습니다. 많은 사람이 LLM으로 PostgreSQL 버그를 찾아 신고하고 있고, 커미터들은 그걸 고치느라 바빴다는 설명이에요.
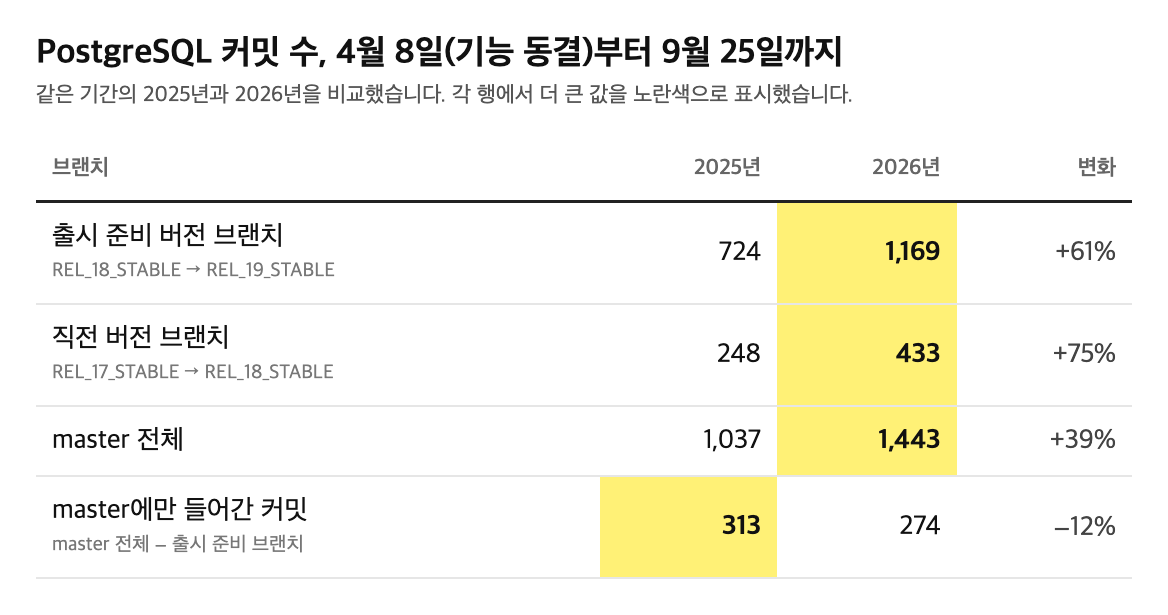
LLM이 수정안 초안을 써 주기는 하지만 늘 맞거나 프로젝트 기준에 맞는 건 아니어서, 결국 사람이 검토하고 커밋해야 합니다. Haas는 그 사람들이 2025년과 2026년 사이에 더 똑똑해지지는 않았다고 적었어요. 지난 9월 ‘AI 시대, 코드 리뷰는 어떻게 해야 할까’에서 다뤘던, 만드는 속도와 검토하는 속도가 벌어지는 문제가 오픈소스 데이터베이스의 출시 일정으로 나타난 경우입니다.
조심해서 읽어야 할 부분도 있습니다.
- 커밋 증가 차트는 2024년 1분기 대비 비율만 보여 줍니다. 실제 커밋 수와 엔지니어 수는 공개하지 않았고, 커밋이 늘어난 게 모두 Codex 때문인지도 따로 나눠 보여 주지 않았어요.
- 성능 숫자는 OpenAI가 자기 모노레포에서 잰 값입니다. 글에 들어 있는 세 방식 비교 시뮬레이션은 OpenAI 스스로 실서비스 벤치마크가 아니라 설명용 모델이라고 적었습니다.
- Pando는 아직 외부에서 쓸 수 없습니다. OpenAI는 기술을 사용자와 나누는 방법을 찾고 있다고만 밝혔어요.
- PostgreSQL 커밋이 늘어난 원인이 LLM이라는 건 Haas의 해석입니다. 커밋마다 버그를 누가 어떻게 찾았는지 집계한 숫자는 아니에요.
에이전트를 늘리면 병목은 다른 곳으로 옮겨 갑니다.
회사 현장에 에이전트를 붙이는 FDE 입장에서 이 두 글은 같은 이야기로 읽힙니다. 에이전트가 코드를 쓰는 속도는 금방 올라가지만, 그 코드가 지나가야 하는 저장소, CI, 리뷰, 출시 절차는 사람 속도에 맞춰 만들어져 있어요. OpenAI는 저장소를 다시 만들어 이 병목을 풀었고, PostgreSQL은 출시를 미루는 쪽을 택했습니다. 에이전트를 여러 개 돌리는 팀이라면 에이전트 수보다 그 뒤의 저장소와 검토 대기열이 버티는지를 먼저 봐야 합니다.
Haas는 앞으로 쓰는 모든 기능이 AI의 검토를 받게 될 것이고, 예전 같으면 영영 묻혔을 문제가 몇 시간 만에 드러날 것이라고 적었습니다. 코드를 만드는 비용이 내려간 만큼, 그 코드를 받아 내고 확인하는 쪽에 들어가는 비용과 설계가 더 중요해질 것 같습니다.