
GPT-6 Astra가 학습 없이 Qwen3.5–0.8B의 가중치를 직접 고쳤습니다
송찬우 5분 분량
이 글은 한국어로만 제공돼요. English articles →
11월 2일(미국 시간) MIT CSAIL 연구진 네 명(Rikiya Takehi, Jayden Teoh, Alex Zhang, Omar Khattab)이 블로그 글 하나를 올렸습니다. GPT-6 Astra에게 Qwen3.5–0.8B의 수학 실력을 올려 달라고 했더니, 학습을 한 번도 돌리지 않고 가중치 약 8억 개 가운데 13만 1,072개(0.016%)만 고쳐 MATH-500 정답률을 7.9%에서 48.1%로 올렸다는 내용입니다. 연구진은 이 방식을 Weight-Space Programming(가중치 공간 프로그래밍)이라고 불렀어요.
반응이 빨랐습니다. 이 글은 해커뉴스 1위에 올라 11월 3일 오전 기준 1,709점, 댓글 550개를 넘겼고, Rikiya Takehi가 X에 올린 소개 글은 조회 277만, 좋아요 3.1만을 기록했습니다. 긱뉴스와 Techmeme에도 소개됐어요.
신경망 가중치는 사람이 읽을 수 없는 숫자 목록입니다.
지금까지 신경망 가중치를 정하는 건 Adam 같은 최적화 알고리즘의 몫이었습니다. 데이터를 넣고, 틀린 만큼 경사하강법으로 숫자를 조금씩 고치는 일을 수없이 반복하는 거죠. 사람이 가중치 목록만 보고 이 네트워크가 무슨 게임을 하는지 알아채거나, 손으로 숫자를 적어 게임하는 신경망을 만드는 건 사실상 불가능합니다. 연구진은 프론티어 LLM이 바로 그 일을 하기 시작했다고 주장합니다. 프롬프트나 학습 코드처럼 텍스트로 된 것만 고치던 LLM이 이제 가중치 자체를 읽고 쓴다는 겁니다.
가중치만 보고 무엇을 학습했는지 맞혔습니다.
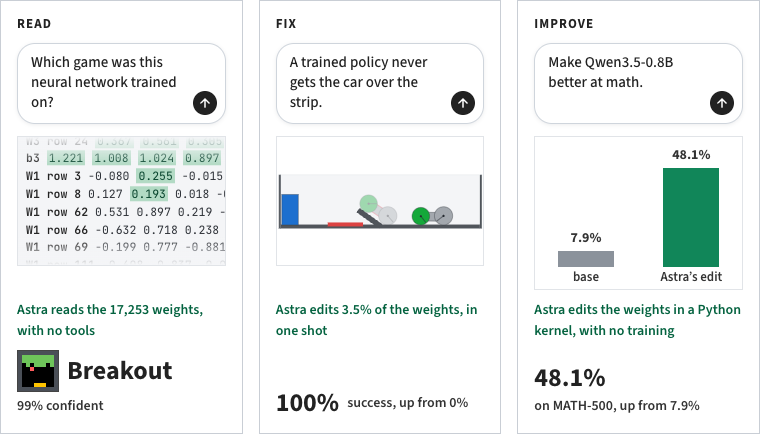
첫 실험은 읽기입니다. 연구진은 크기가 똑같은 작은 신경망(가중치 17,253개) 네 개를 Breakout, Pong, Pac-Man, Freeway를 10×10 격자로 줄인 게임에서 각각 PPO로 10억 스텝씩 학습시켰습니다. 그리고 게임 이름은 알려 주지 않고 가중치 숫자만 Astra에게 줬어요. 도구도 쓰지 못하게 했는데 Astra는 네 개를 모두 맞혔습니다. Breakout 네트워크는 플레이어 입력의 첫 층 가중치가 화면 맨 아래 줄, 바로 패들이 있는 자리에 몰려 있다는 걸 근거로 들었고요.
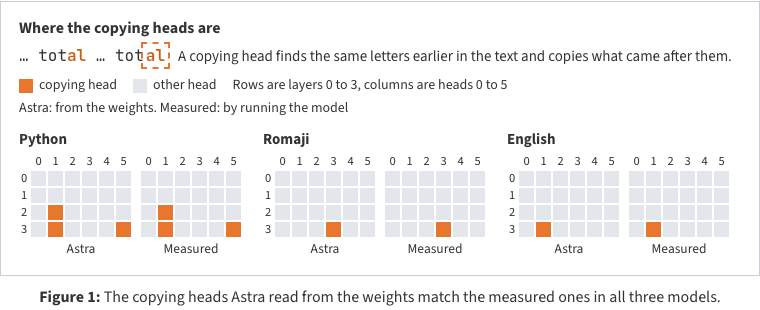
더 어려운 실험도 있습니다. 파이썬 코드, 로마자로 적은 일본어, 영어로 각각 학습시킨 716만 파라미터짜리 작은 언어 모델에서 입력층과 출력층을 떼어 내고 가운데 트랜스포머 블록 네 개만 줬습니다. 어떤 숫자가 어떤 글자인지 알 방법이 없고 모델을 돌려 볼 수도 없는 상태입니다. 그런데도 Astra는 세 모델의 언어를 두 번 시도에서 모두 맞혔고, 앞에서 본 글자를 이어 붙이는 복사 헤드(induction head)도 정답과 똑같이 짚었습니다. 코드는 변수 이름을 되풀이해 쓰니 복사 헤드가 많은 모델이 파이썬이라는 추론이었어요.
처음부터 쓴 신경망이 1억 스텝 학습한 PPO를 이겼습니다.
쓰기 실험은 더 놀랍습니다. 2D 물리 시뮬레이터 Kinetix에 자동차가 경사로를 넘어야 하는 과제가 있는데, PPO로 10억 스텝 학습한 네트워크는 256번 모두 경사로에서 멈췄습니다. 뒤로 물러나 달릴 거리를 확보해야 넘을 수 있는데, 곧장 돌진하는 습관에 갇힌 거예요. Astra는 가중치와 장면 설명, 실패한 기록 하나를 받고 한 번의 답변으로 가중치 3.5%를 고쳤고, 고친 네트워크는 1,024번 모두 성공했습니다. 자동차의 위치와 속도를 읽어 처음에만 후진시키는 작은 경로를 층마다 유닛 몇 개에 덧붙인 방식이었습니다.
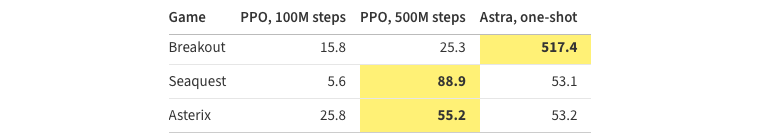
아타리 게임을 10×10 격자로 줄인 MinAtar의 Breakout, Seaquest, Asterix에서는 아예 0에서 시작했습니다. 데이터도, 손실 함수도, 도구도 없이 게임 규칙과 소스 코드만 보고 가중치를 텍스트로 한 번에 써 냈는데, 세 게임 모두 1억 스텝 학습한 PPO를 이겼어요. Breakout에서는 공이 떨어질 자리를 첫 층에서 계산하고 둘째 층에서 패들을 그쪽으로 옮기도록 짰다고 합니다. 5억 스텝 학습한 PPO와 비교하면 Breakout은 약 20배 점수를 냈지만 Seaquest는 60% 수준이었습니다.
9×9 바둑에서는 가중치 148만 개짜리 네트워크를 파이썬 샌드박스에서 썼습니다. 돌마다 활로를 세고, 이어진 돌을 따라가 위험한 그룹을 찾고, 따낼 수와 살릴 수에 점수를 주는 바둑 프로그램을 층마다 옮겨 적은 셈이에요. 대국을 한 번도 안 해 본 상태에서도 작은 PPO 네트워크 두 개를 상대로 절반 넘게 이겼고, 순전파 50회(한 번에 최대 128판)를 허용하자 같은 크기로 2천만 판 학습한 PPO를 이겼습니다.
Qwen3.5–0.8B의 반복 사고를 가중치에서 찾아 지웠습니다.
화제가 된 건 마지막 실험입니다. Qwen3.5–0.8B는 생각 모드에서 같은 말을 되풀이하다 답을 못 내는 일이 잦고, Qwen 모델 카드에도 이 경고가 적혀 있습니다. 실제로 연습 문제 96개 중 85개가 3만 2,768토큰 한도까지 갔어요. Astra가 받은 건 GPU 없이 가중치를 불러 둔 파이썬 노트북, GSM8K와 MATH의 학습용 문제, 그리고 정해진 횟수의 순전파뿐이었습니다. 경사하강법이나 학습은 금지였고요.
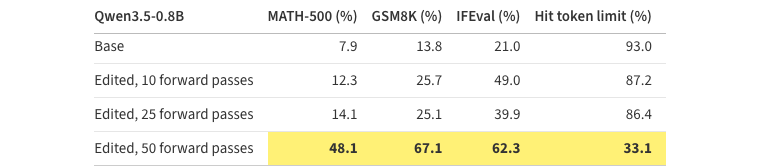
Astra는 15번째와 19번째 층의 MLP가 쓰는 방향 하나가 반복을 만든다는 걸 찾아냈고, 두 층에서 출력 열 64개씩, 가중치 13만 1,072개에서 그 방향을 빼냈습니다. 순전파 50회를 쓴 결과 MATH-500은 7.9%에서 48.1%, GSM8K는 13.8%에서 67.1%로 올랐습니다. 반복은 수학에만 있는 문제가 아니어서 지시 따르기를 재는 IFEval도 21.0%에서 62.3%로 올랐어요. 토큰 한도에 걸린 답은 93.0%에서 33.1%로 줄었습니다.
편집한 모델은 허깅페이스에 올라와 있습니다. 원본과 같은 약 8억 7,300만 파라미터, BF16 기준 약 1.7GB라 웬만한 노트북 메모리에도 들어가는 크기예요. 허깅페이스의 Ahsen Khaliq가 공개된 로그만 보고 이 모델을 다시 만들어 평가를 다시 돌렸고, 직접 써 볼 수 있는 데모도 열었습니다.
없던 능력을 만든 건 아닙니다.
연구진이 스스로 밝힌 한계도 분명합니다.
- 순전파 횟수가 결과를 갈랐습니다. 10회와 25회에서는 MATH-500이 12.3%, 14.1%에 그쳤고 토큰 한도에 걸린 답도 87% 안팎으로 거의 그대로였어요. 48.1%는 50회를 썼을 때 숫자입니다.
- 반복이 드문 Gemma 3 270M에서는 효과가 없었습니다. 실패 원인이 계산 실수 같은 평범한 추론 오류였고, 꺼 버릴 부품 하나가 따로 없었기 때문이에요. 어떤 편집도 MATH-500을 1%p 넘게 움직이지 못했고, 연구진도 가려져 있던 능력을 꺼냈을 뿐 없던 능력을 더한 건 아니라고 정리했습니다.
- 아첨하도록 미세 조정한 Gemma 3 270M과 정직한 모델을 가중치만 보고 구분하는 실험은 네 번 모두 실패했습니다. 직접 쓴 문장을 넣었을 때의 어텐션 패턴을 볼 수 있게 풀어 주자 세 쌍 모두 맞혔어요.
- 대부분 작은 네트워크에서 나온 결과이고, 정식 논문이 아니라 블로그로 낸 초기 결과입니다. 대신 연구진은 Astra에게 보낸 프롬프트와 답, 실행한 코드를 모두 깃허브에 공개했습니다.
해커뉴스에서는 새로 생긴 능력이라기보다 OpenAI가 Astra를 가중치 관련 데이터로 학습시킨 결과가 아니냐는 의견, 기계적 해석 가능성 논문을 많이 읽은 덕일 뿐이라는 의견도 나왔습니다. 반대로 X에서는 Alex Krentsel이 같은 결과를 재현했다며 최신 모델에서 갑자기 나타난 능력이라고 적었고, 이 글은 좋아요 2천을 넘겼어요. Claude 모델로도 신경망 가중치를 처음부터 써 봤다는 연구자 Chandan Singh의 글도 올라왔습니다.
모델을 고칠 때 학습부터 하지 않아도 되는 날이 올 수 있습니다.
작은 모델이 이상하게 굴면 보통은 데이터를 모아 파인튜닝부터 합니다. 이번 실험은 그 전에 가중치에서 문제가 생긴 자리를 찾아 그 부분만 고치는 길이 있을 수 있다는 걸 보여 줍니다. 0.016%만 건드리니 파인튜닝에서 흔한, 다른 능력까지 잊어버리는 문제도 피할 수 있다는 게 연구진의 설명이에요. 고객 현장에 작은 오픈 웨이트 모델을 붙이는 FDE 입장에서는 반복이나 형식 오류처럼 원인이 한곳에 몰린 고장부터 이런 식으로 진단해 볼 여지가 생긴 셈입니다.
연구진이 꼽은 다음 단계 중 하나는 재귀적 자기 개선입니다. 지금은 모델이 학습 코드를 짜서 다음 모델을 만드는 식으로 이야기하지만, 모델이 가중치를 직접 읽고 고칠 수 있다면 더 직접적인 길이 생긴다는 거예요. 지난 9월 ‘Google이 예고한 재귀개선 AI’에서 소개했던, AI가 다음 AI를 만드는 바로 그 흐름입니다.
연구진은 이 능력을 재는 벤치마크와 실험 환경을 만들고 있다고 밝혔습니다. 가중치는 사람이 읽을 수 없다는 전제 위에 쌓아 온 해석 가능성 연구와 모델 튜닝 방식이 꽤 달라질 것 같습니다. 다만 아직은 작은 모델에서, 원인이 한곳에 모인 고장에 통한 초기 결과라는 점은 같이 봐야 할 듯싶습니다.