
Amazon이 티켓 분류에서 Claude Sonnet 4.6을 빼고 비용을 98% 줄였습니다
송찬우 5분 분량
이 글은 한국어로만 제공돼요. English articles →
11월 9일(미국 시간) AWS의 오픈소스 에이전트 프로젝트 Strands Agents 블로그에 Amazon 엔지니어 두 명이 글을 올렸습니다. Amazon과 AWS 팀이 함께 쓰는 사내 티켓 시스템에서 티켓에 라벨을 붙이던 Claude Sonnet 4.6을 빼고, 결정 모델 Strands Decider E4B로 바꿨다는 내용이에요. 비용은 98% 줄었고, 1년이면 토큰 비용 수백만 달러를 아낀다고 밝혔습니다.
이 글은 11월 10일 해커뉴스 1면에 올라 220점, 댓글 72개를 받았습니다. 큰 모델을 쓰던 자리를 작은 모델로 바꾼 사례는 많지만, 이번에는 글을 아예 쓰지 못하는 모델이 티켓을 분류해요.
하는 일은 라벨 20개 중 하나를 고르는 것이었습니다.
이 티켓 시스템에는 고객 에스컬레이션, 용량 증설 요청, 자동 알람, 보안 점검 결과까지 회사 곳곳의 일이 티켓으로 들어옵니다. 들어온 티켓마다 정해진 20개 유형 가운데 하나를 붙이는 게 Sonnet 4.6의 일이었어요. 티켓마다 긴 시스템 프롬프트를 붙여 보내고, Sonnet 4.6이 라벨 목록을 따져 본 뒤 JSON으로 답을 냈습니다.
두 엔지니어는 Sonnet 4.6이 지능과 비용 사이에서 적당한 선택이었고, 나온 지 9개월 된 모델치고 일을 잘했다고 썼습니다. 다만 세계에서 손꼽히게 큰 사내 티켓 시스템이라 호출 수가 어마무시했어요.
결정 모델은 글을 쓰지 않습니다.
결정 모델은 상태와 질문, 선택지를 받아 선택지마다 확률을 매기고 확신도를 붙여 돌려줍니다. 문장을 만들어 내는 부분을 떼어 냈기 때문에 답은 언제나 주어진 선택지 안에서 나와요. 티켓 분류에서는 티켓이 상태가 되고, 라벨 목록이 선택지가 됩니다.
Strands Decider는 AWS가 10월 1일 공개한 오픈소스 결정 모델입니다. 처음 나온 2B는 Qwen3.5–2B에서 글을 만드는 부분을 떼어 내고 선택지 점수를 매기는 작은 헤드를 붙였어요. 공개 글에는 TypeSafe AI가 Jev를 내놓은 뒤로 이런 모델이 주목받고 있다고 적혀 있습니다. 지난 9월 ‘말을 안 하는 AI 모델, Jev 출시’에서 소개했던, 문장 대신 값을 내놓는 바로 그 방식입니다.
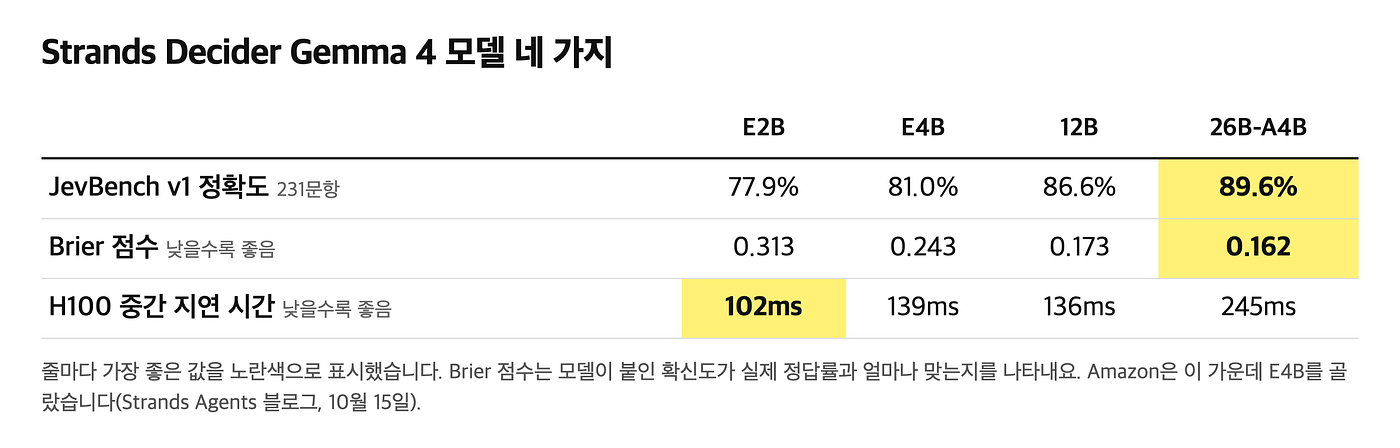
10월 15일에는 구글의 Gemma 4를 바탕으로 한 E2B, E4B, 12B, 26B-A4B 네 가지가 추가됐습니다. Amazon 팀은 2B로 시작했다가 자기 티켓으로 시험해 보고 E4B가 확실히 낫다는 걸 확인해 옮겼어요. 그다음 라벨을 붙일 확신도 기준을 조정했고, 따로 떼어 둔 티켓에서 E4B가 운영 중이던 Sonnet 4.6을 앞섰다고 밝혔습니다.
비용은 약 44분의 1입니다.
같은 티켓에서 잰 숫자는 이렇습니다. 호출 한 번에 Sonnet 4.6은 평균 4,215ms, Strands Decider E4B는 897ms가 걸렸어요. 티켓당 토큰은 6,724개에서 2,010개로 70% 줄었습니다. 출력 토큰은 170개에서 1개가 됐어요. JSON 답 대신 고른 선택지 하나만 내놓기 때문입니다.
입력도 줄었습니다. Strands Decider가 한 번에 읽을 수 있는 길이는 4,096토큰인데, 운영 중이던 라벨 설명만으로도 이보다 길었어요. 그래서 라벨 20개를 각각 한두 문장짜리 기준으로 다시 쓰고, 해당 없음 선택지를 하나 더해 선택지로 넘겼습니다. 티켓 내용은 Sonnet 4.6이 받던 것과 같고, 긴 티켓만 오래된 댓글부터 잘라 길이를 맞췄어요.
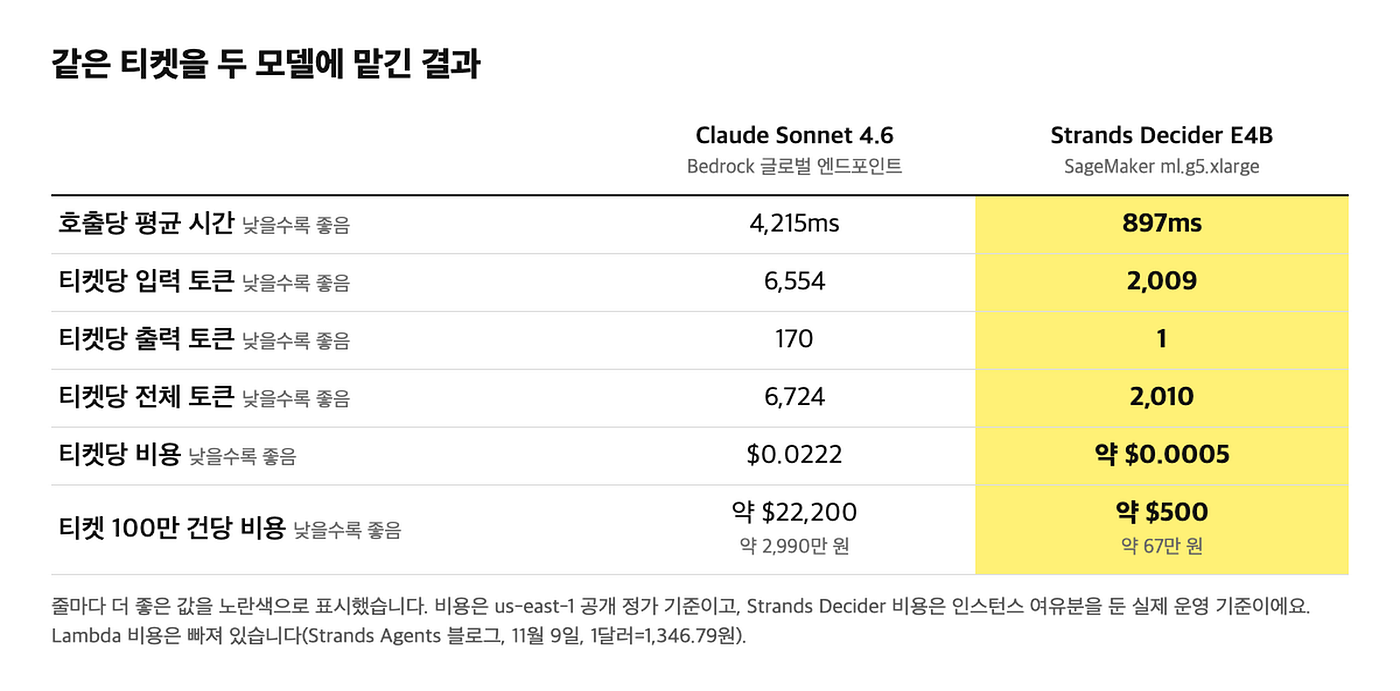
비용은 us-east-1 공개 정가로 계산했습니다. Sonnet 4.6은 100만 토큰당 입력 3달러(약 4,000원), 출력 15달러(약 2만 원)라 티켓 하나에 0.0222달러(약 30원)가 들었어요. Strands Decider E4B는 SageMaker의 ml.g5.xlarge 인스턴스에서 시간당 1.408달러(약 1,900원)를 냅니다. 요청 하나에 약 640ms가 걸리니 인스턴스 한 대가 시간당 약 5,600건을 처리해요.
인스턴스를 꽉 채우면 티켓 100만 건에 250달러(약 34만 원)지만, 갑자기 몰리는 요청에 대비해 여유를 두니 실제로는 약 500달러(약 67만 원)가 든다고 했습니다. Sonnet 4.6의 약 22,200달러(약 2,990만 원)와 비교하면 약 44배 싸요. 이 계산에는 Lambda 비용이 빠져 있는데, Lambda도 티켓마다 도는 시간이 짧아졌습니다.
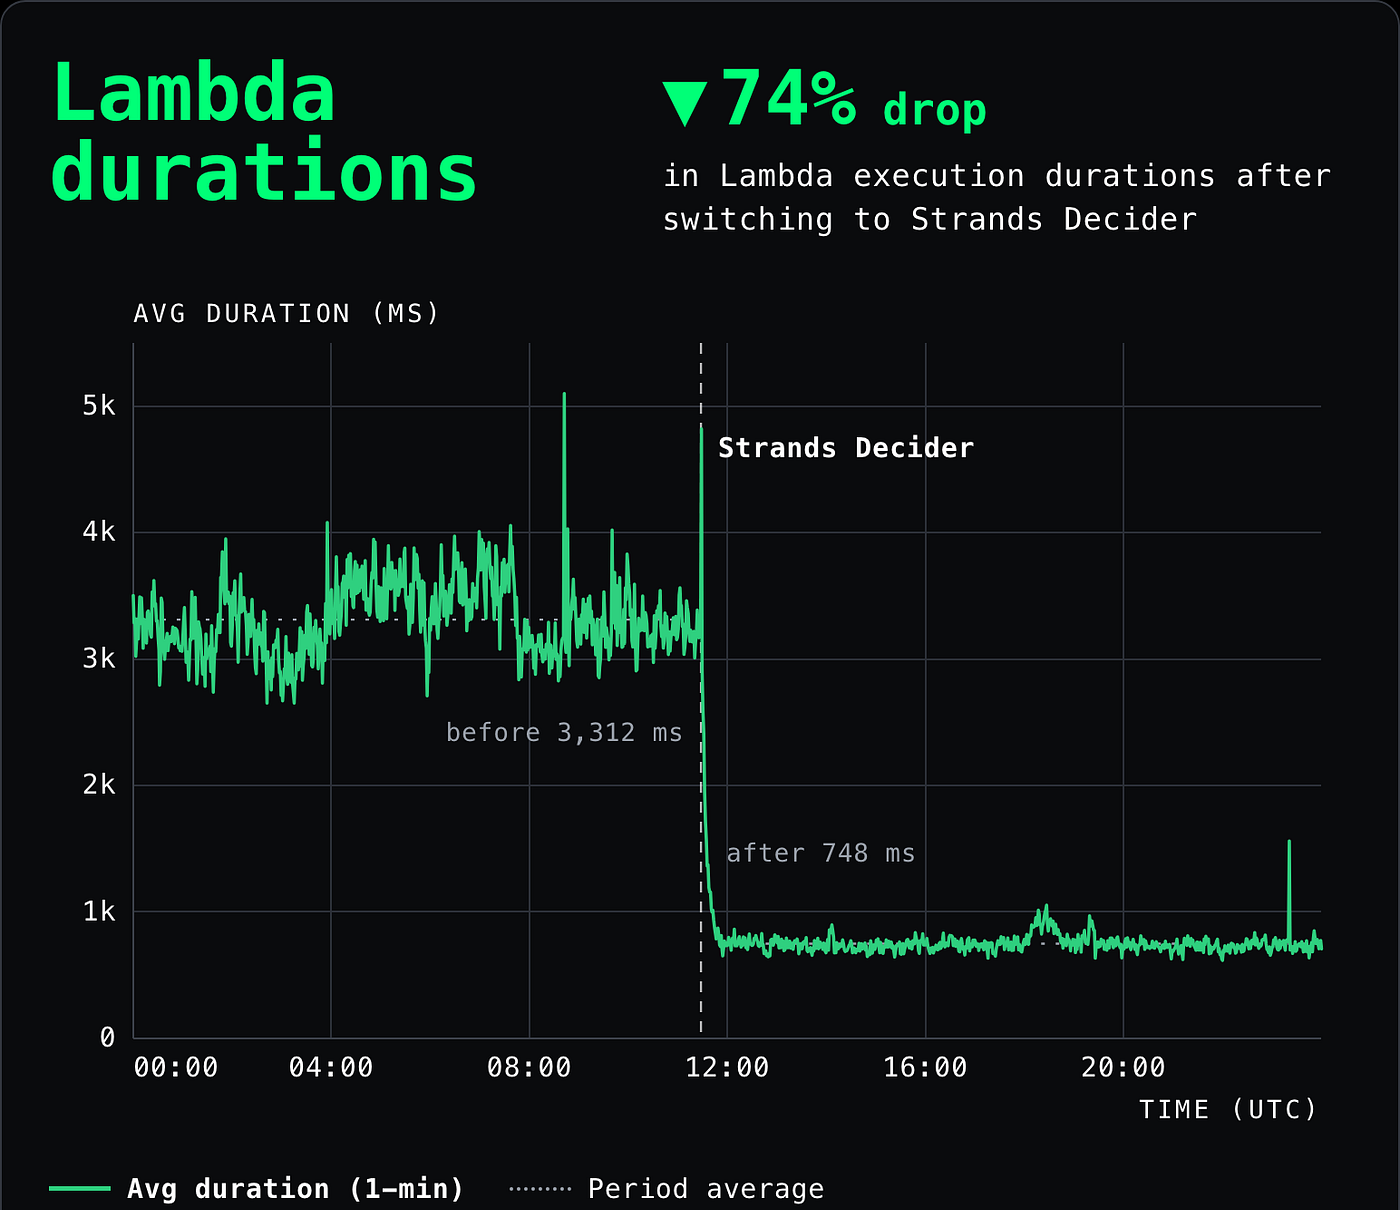
Sonnet 4.6을 끈 날의 그래프를 보면 Lambda 평균 실행 시간이 3,312ms에서 748ms로 74% 떨어졌습니다. 티켓이 들어오면 SQS 대기열이 Lambda를 깨우고, Lambda가 SageMaker 엔드포인트의 Strands Decider를 부르는 구조예요. 티켓 API를 빼면 전부 AWS 기본 서비스라 다른 회사도 같은 구조로 만들 수 있다고 밝혔습니다.
바로 바꾸지 않고 둘을 나란히 돌렸습니다.
이번 글에서 가장 쓸모 있는 대목은 모델보다 바꾼 방식입니다. 라벨을 붙이는 Lambda는 메시지를 처리할 때마다 AWS AppConfig에서 세 가지 설정 가운데 하나를 읽었어요.
- BEDROCK: Sonnet 4.6만 라벨을 붙이고 Strands Decider는 부르지 않습니다.
- DUAL: 두 모델을 동시에 부릅니다. 티켓에는 Sonnet 4.6의 답을 붙이고, Strands Decider의 답은 비교용으로만 남깁니다.
- DECIDER: Strands Decider만 라벨을 붙이고 Bedrock은 부르지 않습니다.
두 엔지니어는 실제 트래픽에서 두 모델을 함께 돌리고 답이 갈린 티켓을 하나하나 따져 본 것이 어떤 오프라인 평가보다 많은 걸 알려 줬다고 썼습니다. 모델과 상관없이 따라 할 부분으로도 이 스위치를 꼽았어요. 문제가 생기면 설정 하나로 45초 만에 Sonnet 4.6으로 돌아갈 수 있었습니다.
고객사 업무에 AI를 붙이는 FDE 입장에서도 이 순서가 현실적입니다. 처음에는 큰 모델로 빨리 띄워 일이 돌아가게 만들고, 쌓인 실제 요청으로 작은 모델을 검증한 뒤, 언제든 되돌릴 수 있는 상태에서 넘기는 거예요.
JSON 키 순서만 바꿔도 답이 흔들렸습니다.
예상하지 못한 문제도 하나 적었습니다. 내용은 같은데 JSON의 키 순서만 바꿔 보내도 선택지별 확률이 최대 0.19까지 움직였어요. 지금은 모든 요청을 키 순서대로 정렬해서 보낸다고 합니다. 결정 모델을 API 뒤에 두고 실험 결과를 비교할 때는 입력 순서부터 고정해야 한다는 얘기입니다.
돌리는 데는 GPU 한 장이면 됩니다.
Strands Decider는 코드와 어댑터, 판단 헤드가 Apache 2.0으로 공개돼 있고, 학습 데이터 목록도 함께 올라와 있습니다. Gemma 4 모델은 어댑터와 판단 헤드만 받고, 바탕이 되는 Gemma 4 가중치는 따로 내려받는 방식이에요.
Amazon 팀은 E4B를 24GB짜리 NVIDIA A10G 한 장이 달린 ml.g5.xlarge에서 돌렸고, 모델이 약 19GiB를 썼습니다. 한 대를 한 달 내내 켜 두면 약 1,014달러(약 137만 원)예요. 처음 나온 2B는 RTX 3090에서 중간값 약 115ms, M3 맥북에서 작은 과제 기준 약 153ms에 답을 냈습니다. 개인 PC에서도 충분히 시험해 볼 수 있는 크기입니다.
정확도 숫자는 공개하지 않았습니다.
아쉬운 점도 있습니다. 글에는 E4B가 Sonnet 4.6만큼 잘했고 따로 떼어 둔 티켓에서는 앞섰다고만 적혀 있고, 정확도가 몇 퍼센트였는지, 시험한 티켓이 몇 건인지는 나오지 않습니다. 수백만 달러라는 절감액도 티켓 처리량을 밝히지 않아 직접 확인할 수 없어요. 해커뉴스의 한 댓글은 티켓 100만 건당 약 21,700달러를 아끼니 200만 달러(약 27억 원)를 아끼려면 1년에 9,200만 건 넘게 처리해야 한다고 계산했습니다.
비교 대상이 9개월 된 Sonnet 4.6이라는 점도 짚어야 합니다. 더 새로운 모델과는 비교하지 않았어요. 두 엔지니어도 이 방법이 통한 조건을 분명히 적었습니다. 정해진 목록에서 하나를 고르는 일이고, 양이 많고, 응답 속도가 중요했기 때문이라고요. 라벨마다 설명 글이 필요하거나, 라벨 목록이 매주 바뀌거나, 필요한 내용을 수천 토큰 안에 담을 수 없다면 결정 모델로는 대신하기 어렵다고 했습니다.
분류기로 한 바퀴 돌아왔다는 반응이 많았습니다.
해커뉴스에서는 6년 전 SVM으로 티켓 분류기를 만들었다는 개발자가 분류기에서 LLM으로 갔다가 다시 빠르고 싼 분류기로 돌아오는 흐름이 흥미롭다고 썼습니다. 반대로 예전에는 분류 프로젝트 대부분이 학습 데이터와 문제 정의 단계에서 멈췄지만, 이제는 LLM으로 먼저 운영해 보고 검증된 뒤에 작은 모델로 옮길 수 있다는 댓글도 달렸어요.
이번 사례가 보여 주는 것도 두 번째 쪽에 가깝습니다. 큰 모델로 먼저 일을 돌려 보고, 일이 정해진 선택으로 굳으면 그 자리를 작은 결정 모델에 넘기는 방식이 에이전트 운영의 기본 순서가 될 것 같습니다. 그때 필요한 건 더 똑똑한 모델보다 두 모델을 나란히 돌려 볼 수 있는 스위치일 듯싶습니다.
https://strandsagents.com/blog/amazon-saves-millions-replacing-sonnet-with-strands-decider/