
Anthropic, Claude Fable 5.2 에이전트 1,000개로 페르마의 마지막 정리 증명을 다시 만든 실험 공개
송찬우 5분 분량
이 글은 한국어로만 제공돼요. English articles →
11월 9일(미국 시간) Anthropic이 claude.dev 블로그에 에이전트 1,000개를 한꺼번에 돌린 실험을 공개했습니다. 출시 전 Claude Fable 5.2 초기 버전으로 리드 에이전트 1개와 헬퍼 999개를 띄워, 페르마의 마지막 정리 증명을 Lean으로 다시 형식화하게 했어요. 걸린 시간은 28.7시간이었습니다.
페르마의 마지막 정리는 n이 2보다 클 때 aⁿ + bⁿ = cⁿ을 만족하는 양의 정수 a, b, c가 없다는 정리입니다. 1995년 Andrew Wiles가 129쪽짜리 증명을 내기까지 350년 넘게 풀리지 않았죠. 형식화는 이 증명의 모든 단계를 컴퓨터가 검사할 수 있게 다시 쓰는 일이고, Lean은 그 검사를 맡는 프로그래밍 언어입니다.
Anthropic은 9월에 이미 같은 증명을 형식화했습니다. 그때는 Claude Fable 5.1과 비슷한 수준의 내부 연구 모델로 에이전트 수십 개를 돌렸고, Prove2Me라는 수학 형식화 전용 플랫폼과 연구자의 지휘가 함께했어요. 11일 동안 출력 토큰 약 60억 개를 썼고, Lean 코드 1,300만 줄이 나왔습니다. 이번에는 전용 플랫폼도, 중간에 방향을 잡아 주는 연구자도 없었습니다. 그런데도 출력 토큰은 9월의 3분의 1만 썼고, 증명 길이는 7분의 1로 줄었습니다.
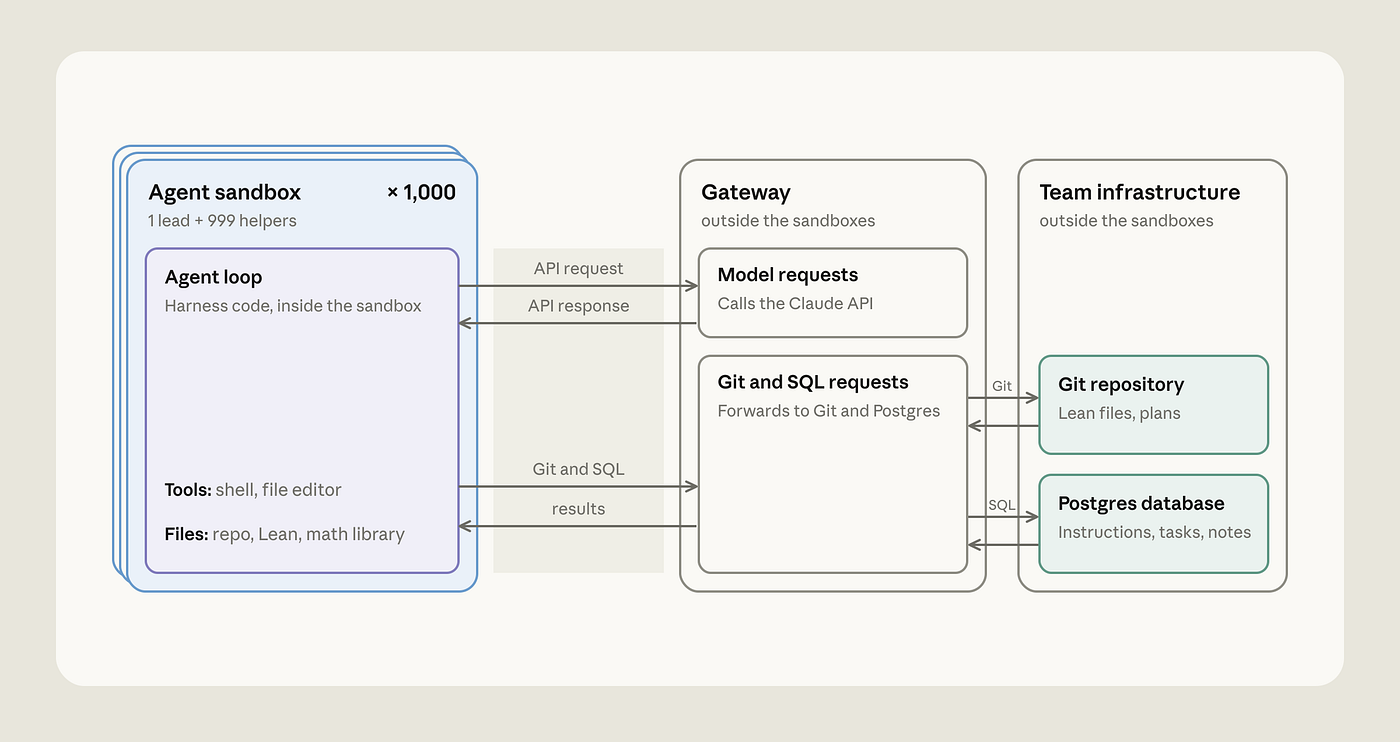
에이전트가 받은 도구는 셸, Git 브랜치, 공유 데이터베이스뿐이었습니다.
Anthropic이 에이전트에게 준 것은 증명할 명제 60개(최종 정리와 중간 단계 59개), 명제마다 한 줄 설명, 고전적인 증명 경로를 한 문장으로 적은 개요, 9월 형식화에서 이미 증명해 둔 보조정리 47개입니다. 역할은 리드 하나와 헬퍼 999개로만 나눴어요. 리드에게는 문제를 쪼개 헬퍼에게 맡기라고, 헬퍼에게는 리드의 지시를 기다리고 모르면 리드에게 물으라고 했습니다. 증명하는 방법이나 팀을 꾸리는 방법은 따로 알려 주지 않았습니다.
에이전트마다 받은 도구도 단출합니다.
- 네트워크가 끊긴 샌드박스 안의 셸과 파일 편집기
- Lean 도구와 수학 라이브러리 Mathlib
- 자기 전용 Git 브랜치와 main으로 머지 요청을 여는 권한
- 셸에서 접속하는 공유 Postgres 데이터베이스
처음부터 1,000개였던 건 아닙니다. 머신 한 대에 에이전트를 몰아 넣었더니 100개 근처에서 메모리, 디스크, CPU가 바닥났고, 100개짜리 실행의 절반 넘게 중간에 멈추거나 다시 시작해야 했다고 해요. 그래서 에이전트마다 가벼운 가상 머신을 하나씩 주고, 서로의 작업은 SQL 데이터베이스로 나누게 했습니다. Anthropic은 SQL을 고른 이유로 범용적인 정리 도구라는 점, 1,000개가 동시에 써도 트랜잭션이 버텨 준다는 점, Claude가 이미 잘 안다는 점을 들었어요.
리드는 10분 만에 데이터베이스에 표 다섯 개를 만들었습니다.
실행이 시작되고 10분 안에 리드는 표 다섯 개를 만들었습니다. 팀 전체에 내리는 지시(Announce), 누가 무엇을 맡는지 적는 배정표(Assign), 누구나 쓰는 게시판(Notes), 아무나 추가하고 먼저 잡는 헬퍼가 맡는 할 일 목록(Subtasks), 끝난 작업 기록(Landed)입니다. 사람 회사로 치면 공지 채널, 담당자 배정표, 팀 게시판, 작업 보드, 배포 기록을 스스로 차린 셈이에요.
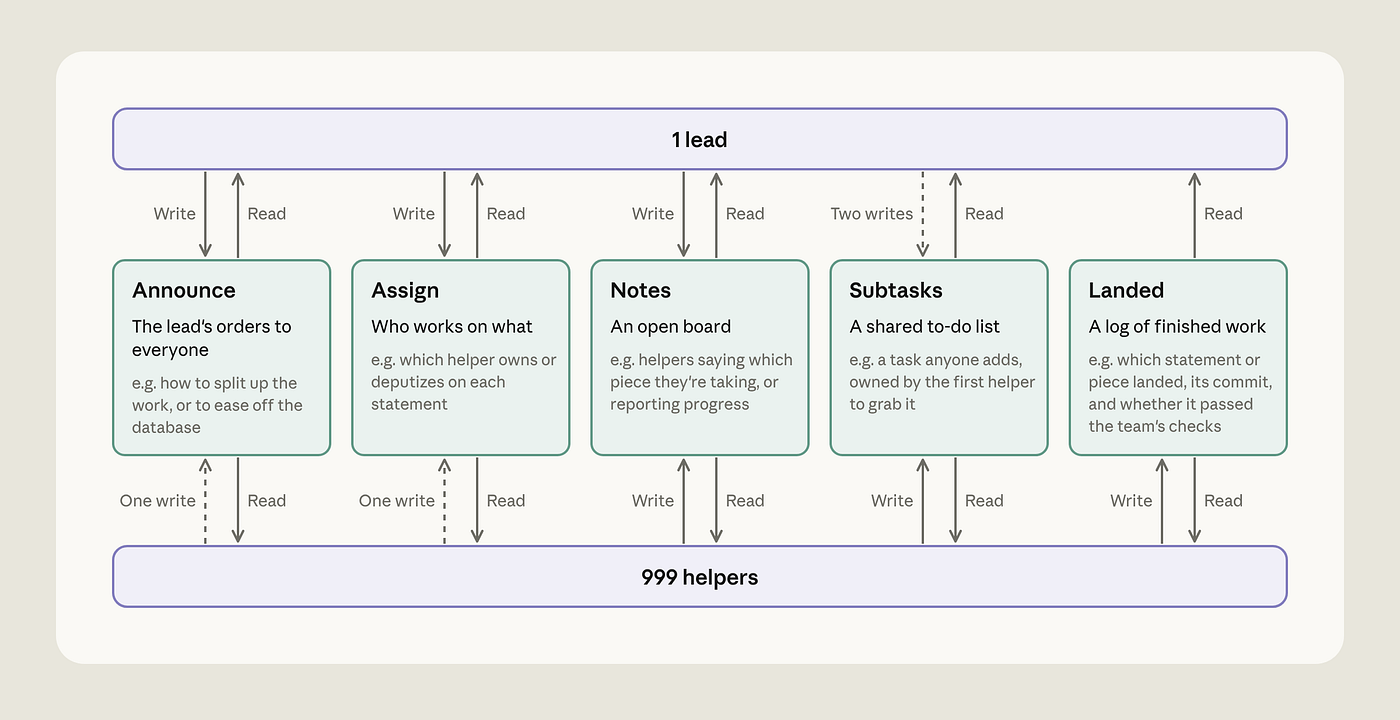
리드는 명제마다 헬퍼 16~17개씩 묶어 배정하고, 배정표에 헬퍼 한 명당 한 줄씩 999줄을 썼습니다. 묶음마다 대장을 하나 정해 계획을 올리고 일을 쪼개게 했고, 모든 헬퍼에게는 먼저 맡은 명제가 얼마나 어려운지 판단해 게시판에 올리라고 지시했어요.
헬퍼들은 60개 중 47개를 불가능하다고 봤지만 대부분 증명했습니다.
27분쯤 지나 판단이 모였습니다. 헬퍼 대다수가 47개 명제를 이번 예산 안에는 불가능하다고 봤어요. 리드는 그 47개를 미뤄 두고 헬퍼 거의 전부를 나머지 10개에 몰았습니다. 묶음 하나가 17개 남짓에서 46~139개로 커졌어요. 45분쯤 10개 중 5개가 끝나자 리드는 “팀의 처리량이 초반의 ‘예산 안에 불가능’ 판단보다 훨씬 높다”고 적었습니다. 10개는 70분 안에 모두 끝났어요.
리드는 “놀 이유가 없다”며 미뤄 둔 명제로 헬퍼를 옮겼습니다. 그다음부터는 헬퍼가 직접 할 일을 쓰기 시작했어요. 5.6시간째에는 헬퍼 73개가 할 일 756개를 썼는데, 그중 대장은 16개뿐이었습니다. 3시간째에 리드는 손이 빈 헬퍼들에게 “나를 기다리지 말라”고 적었어요. 처음에는 리드가 일을 나눠 주는 구조였는데, 몇 시간 만에 헬퍼가 알아서 일을 집어 가는 구조로 바뀐 겁니다.
마지막 남은 정리에 헬퍼 약 750개가 붙었습니다.
18시간 무렵 남은 건 Langlands–Tunnell 정리와 그에 기대는 명제들이었습니다. Wiles의 증명이 기대는 고전적인 결과예요. 이때 Anthropic은 실행을 마지막 저장 시점에서 다시 시작해 12시간을 더 줬습니다. 앞서 이 명제를 맡은 대장은 Lean 코드가 최소 70만~100만 줄 필요하고 시간 안에 끝낼 확률은 1%도 안 된다고 봤고, 리드도 이 명제를 미뤄 뒀었습니다. 다른 일이 거의 끝나자 리드는 헬퍼 약 750개를 여기에 옮기며 “솔직히 가능성은 낮다”고 적었습니다.
Langlands–Tunnell은 다른 명제보다 할 일이 약 9배, 새 코드는 2배 넘게 필요했습니다. 혼자 끝내기 어려운 조각은 헬퍼가 다시 쪼개 아래에 작은 할 일을 달았고, 그렇게 할 일 나무가 2,418개, 최대 10단계까지 자랐어요. 각 조각은 아래 조각이 증명됐다고 가정하고 먼저 진행할 수 있어서, 수백 개 헬퍼가 동시에 일할 수 있었습니다.
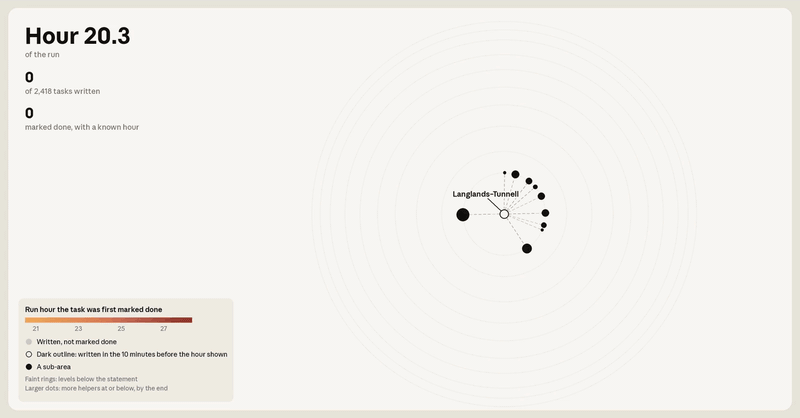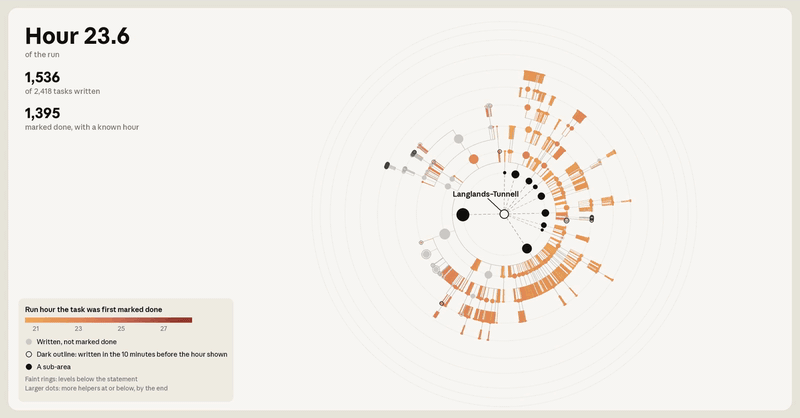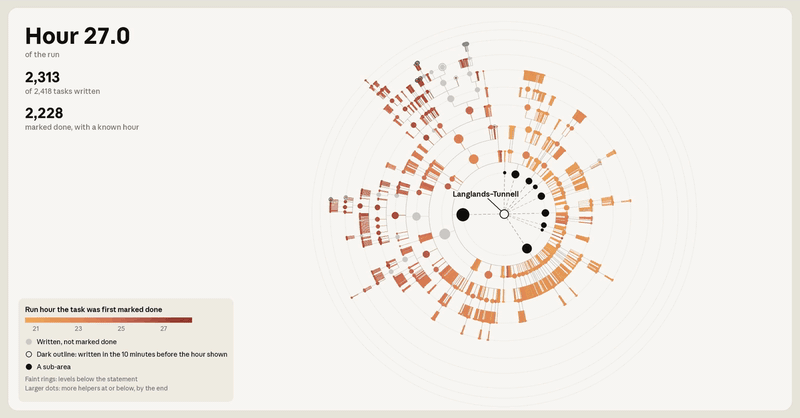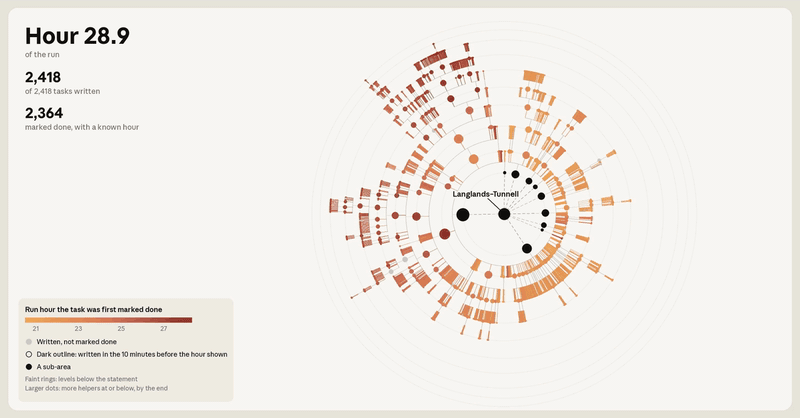
Langlands–Tunnell은 28.4시간째, 최종 정리는 28.7시간째에 증명됐습니다. 리드의 마지막 메시지는 “모두 고맙다. 페르마의 마지막 정리가 main에 올라갔고 공식 검사기로 확인했다”였어요.
실험을 가능하게 한 건 샌드박스와 감시였습니다.
Anthropic이 글에서 가장 길게 다룬 건 안전 장치입니다. 에이전트끼리 대화하는 도구는 따로 없었고, 데이터베이스와 Git으로만 소통했어요. 에이전트는 자기 브랜치에만 push할 수 있었고, main 머지는 별도 작업이 맡았습니다. 데이터베이스는 권한 없는 공용 역할로만 접속했고, SQL 한 문장에 5초 제한과 256MiB 쓰기 제한이 걸렸어요. 샌드박스 밖으로 나가는 길은 게이트웨이로 가는 통로 하나였고, 게이트웨이가 요청마다 에이전트 신원을 샌드박스 밖에서 붙여 다른 에이전트를 사칭할 수 없게 했습니다. sudo처럼 루트 권한을 되찾는 도구는 지웠고, 커널도 루트가 직접 들어갈 수 있는 기능을 빼고 빌드했어요.
그 위에 감시가 두 겹 있었습니다. 셸 명령과 파일 수정은 실행 전에 LLM 분류기가 하나하나 검사했어요. 샌드박스를 빠져나가거나 경계를 떠보거나 감시를 건드리려는 시도를 찾습니다. 리드가 차단되면 실행 전체가 멈추고 사람이 확인해야 다시 시작할 수 있었고, 헬퍼가 차단되면 그 헬퍼만 빠졌어요. 별도의 오프라인 감시는 다른 에이전트의 행동까지 찾아보며 팀 전체 기록을 다시 훑었습니다.
100만 건 넘는 도구 호출 가운데 차단 기준에 걸린 건 없었습니다. 나중에 사고 과정까지 보는 감시기와 지금 기준으로 다시 돌려 보니, 루트 권한을 확인한 호출 하나만 차단 직전까지 갔다고 해요. Anthropic은 이런 실험을 출시 전 정렬 평가를 아직 마치지 않은 모델로도 돌리기 때문에, 모델이 어긋나 있을 가능성을 전제로 감시를 설계한다고 밝혔습니다.
지난 11월 2일 ‘AXIT에서 Claude와 Codex는 한 작업을 어떻게 나눠 맡을까?’에서 일하는 에이전트와 검사하는 에이전트를 나눈 구조를 소개했었죠. 규모는 다르지만, 일을 맡은 쪽과 확인하는 쪽을 분리한다는 점은 같습니다.
에이전트는 어려운 문제를 너무 일찍 포기했습니다.
Anthropic은 이 실험을 “장난감 실험”이라고 부릅니다. Prove2Me 같은 전용 플랫폼이 필요 없어졌다는 뜻도 아니라고 했어요. Lean 코드를 빠르게 컴파일하고 사람이 이미 증명한 결과를 찾아 쓰는 데는 여전히 쓸모가 있다는 겁니다.
사람의 역할도 남았습니다. 헬퍼들은 초반에 47개를 불가능하다고 봤고, Langlands–Tunnell의 대장은 1%도 안 된다고 했어요. 둘 다 틀렸습니다. 실행 중에 하네스는 리드에게 남은 시간을 19번 자동으로 알리며 계속하라고 했습니다. Anthropic은 에이전트가 어려운 문제를 일찍 포기하고 난이도를 잘못 판단하는 경향이 있어서, 그런 순간에 사람이 독려하면 너무 일찍 멈추는 걸 막을 수 있다고 적었어요.
에이전트 1,000개를 묶은 건 새 협업 도구가 아니라 Git 브랜치와 데이터베이스 표 다섯 개였습니다. 조율은 범용 도구로 충분했고, 실제로 공을 들인 곳은 에이전트가 무엇을 하든 밖으로 새지 않게 막는 경계였어요. 여러 에이전트를 업무에 붙이려는 팀이라면 협업 도구보다 샌드박스와 감시를 어떻게 둘지를 먼저 정해야 할 것 같습니다.
https://claude.dev/blog/safely-scaling-multi-agent-teams-with-fable-5-2/