
DeepSeek-V4와 Kimi K3의 가중치에는 Blackwell GPU 지문이 남아 있었습니다
송찬우 6분 분량
이 글은 한국어로만 제공돼요. English articles →

11월 12일(미국 시간) Unemployment Labs의 Will DePue가 중국 AI 모델 6개의 공개 가중치에서 NVIDIA Blackwell GPU의 흔적을 찾았다는 보고서를 냈습니다. DeepSeek-V4-Flash와 DeepSeek-V4-Pro, Moonshot AI의 Kimi K3와 Kimi K3.1-Pro, MiniMax-M3, Ant Group의 Ling-3.1-flash입니다. Blackwell은 중국으로 수출하려면 미국 정부 허가가 필요한 칩이고, 허가가 났다는 보고는 없어요.
DeepSeek과 Moonshot AI가 Blackwell을 쓴다는 주장은 미국 정부 관계자와 언론에서 이미 나왔습니다. 다만 기술적인 증거를 내놓은 적은 없었어요. 이번 보고서는 내부자 제보나 유출 없이, 누구나 내려받을 수 있는 가중치 파일만으로 이 결론에 닿았다는 점이 다릅니다.
보고서가 나온 11월 12일, NVIDIA는 젠슨 황이 CEO와 이사직에서 물러났다고 발표했습니다. 앞서 10월 29일 뉴욕타임스는 미국 당국자들이 싱가포르 데이터센터 회사의 임원 Alice Huang을 중국 정보기관의 정보원으로 판단했고, 이 임원이 젠슨 황과 가까운 사이였다고 보도했어요. 기밀 정보를 전해 들었다는 익명의 관계자들을 근거로 한 보도이고, 중국 외교부는 근거 없는 주장이라고 반박했습니다.
NVIDIA 이사회는 11월 8일 독립 조사를 시작하면서 국가 안보나 회사 기밀이 새어 나갔다고 볼 이유는 없다고 밝혔는데, 조사 결과는 아직 나오지 않았습니다. 이 의혹과 이번 보고서의 모델 6개를 잇는 증거도 지금까지 나온 게 없어요.
가중치의 첫 값은 GPU마다 다른 자리에 놓입니다.
모델을 학습하기 전에는 수십억 개 가중치에 먼저 무작위 값을 채워 넣습니다. 이 값은 진짜 무작위가 아니에요. 시드라는 숫자를 넣으면 늘 같은 순서의 값이 나오는 Philox라는 계산법으로 만듭니다. 같은 시드면 같은 값이 나오니까 실험을 똑같이 다시 할 수 있습니다.
그런데 PyTorch가 GPU에서 이 일을 할 때는 일을 여러 스레드에 나눠 맡깁니다. 연산 장치(SM) 하나에 스레드 2,048개를 쓰기 때문에 SM 수가 다르면 스레드 수도 달라져요. Hopper 계열인 H100, H200, H800은 SM이 132개라 스레드가 270,336개, Blackwell B200/B300은 148개라 303,104개, GB200/GB300은 152개라 311,296개입니다. 스레드마다 만드는 값의 순서는 같은데, 그 값이 들어가는 자리가 달라집니다.
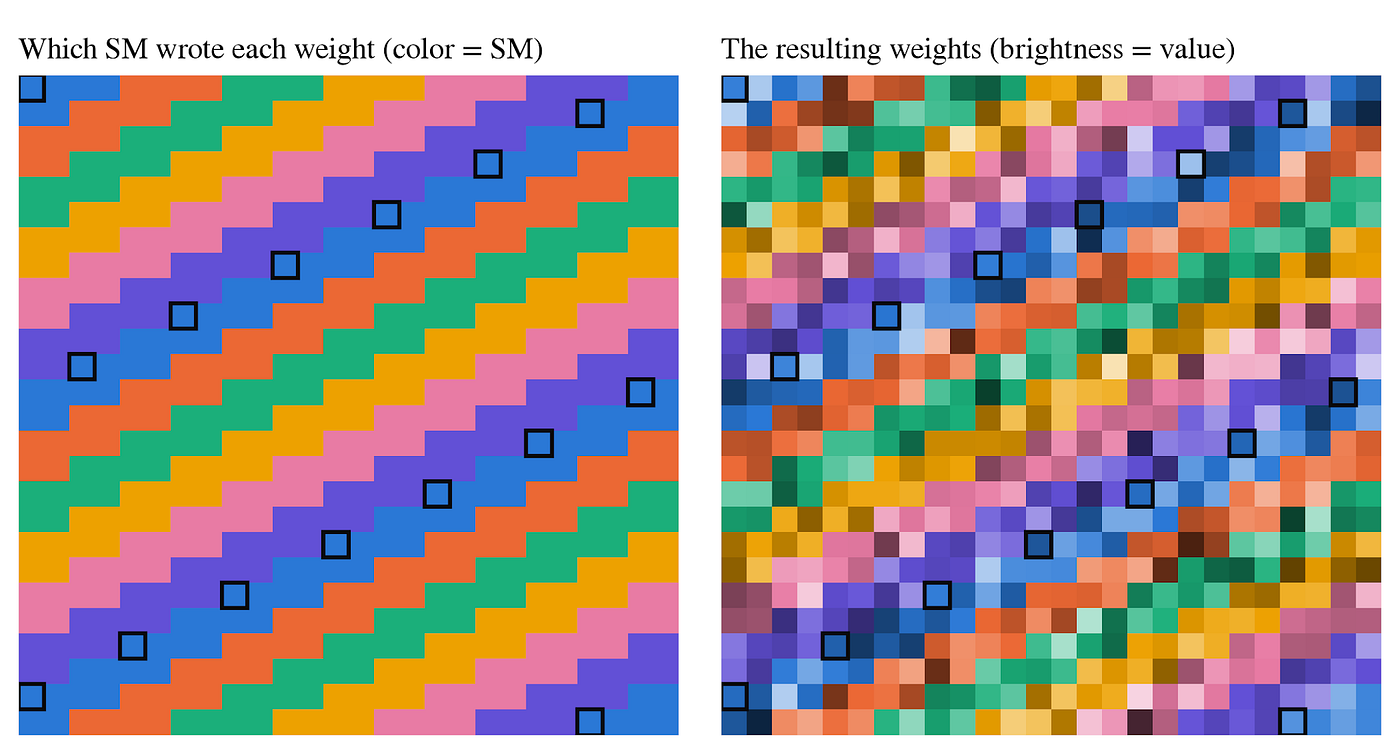
학습이 끝나면 이 첫 값은 대부분 바뀝니다. 그런데 바뀌지 않고 남는 곳이 있어요. 단어 목록에 넣어 두고 학습 데이터에서 한 번도 나오지 않은 토큰의 행은 학습 내내 건드려지지 않아서 첫 값이 그대로 남습니다. 보고서는 이 행들을 놓고 시드와 SM 수를 바꿔 가며 같은 배치가 나오는 조합을 찾았습니다. 약 6조 개 조합을 뒤졌어요.
실제 칩에서 비트 단위로 다시 만들었습니다.
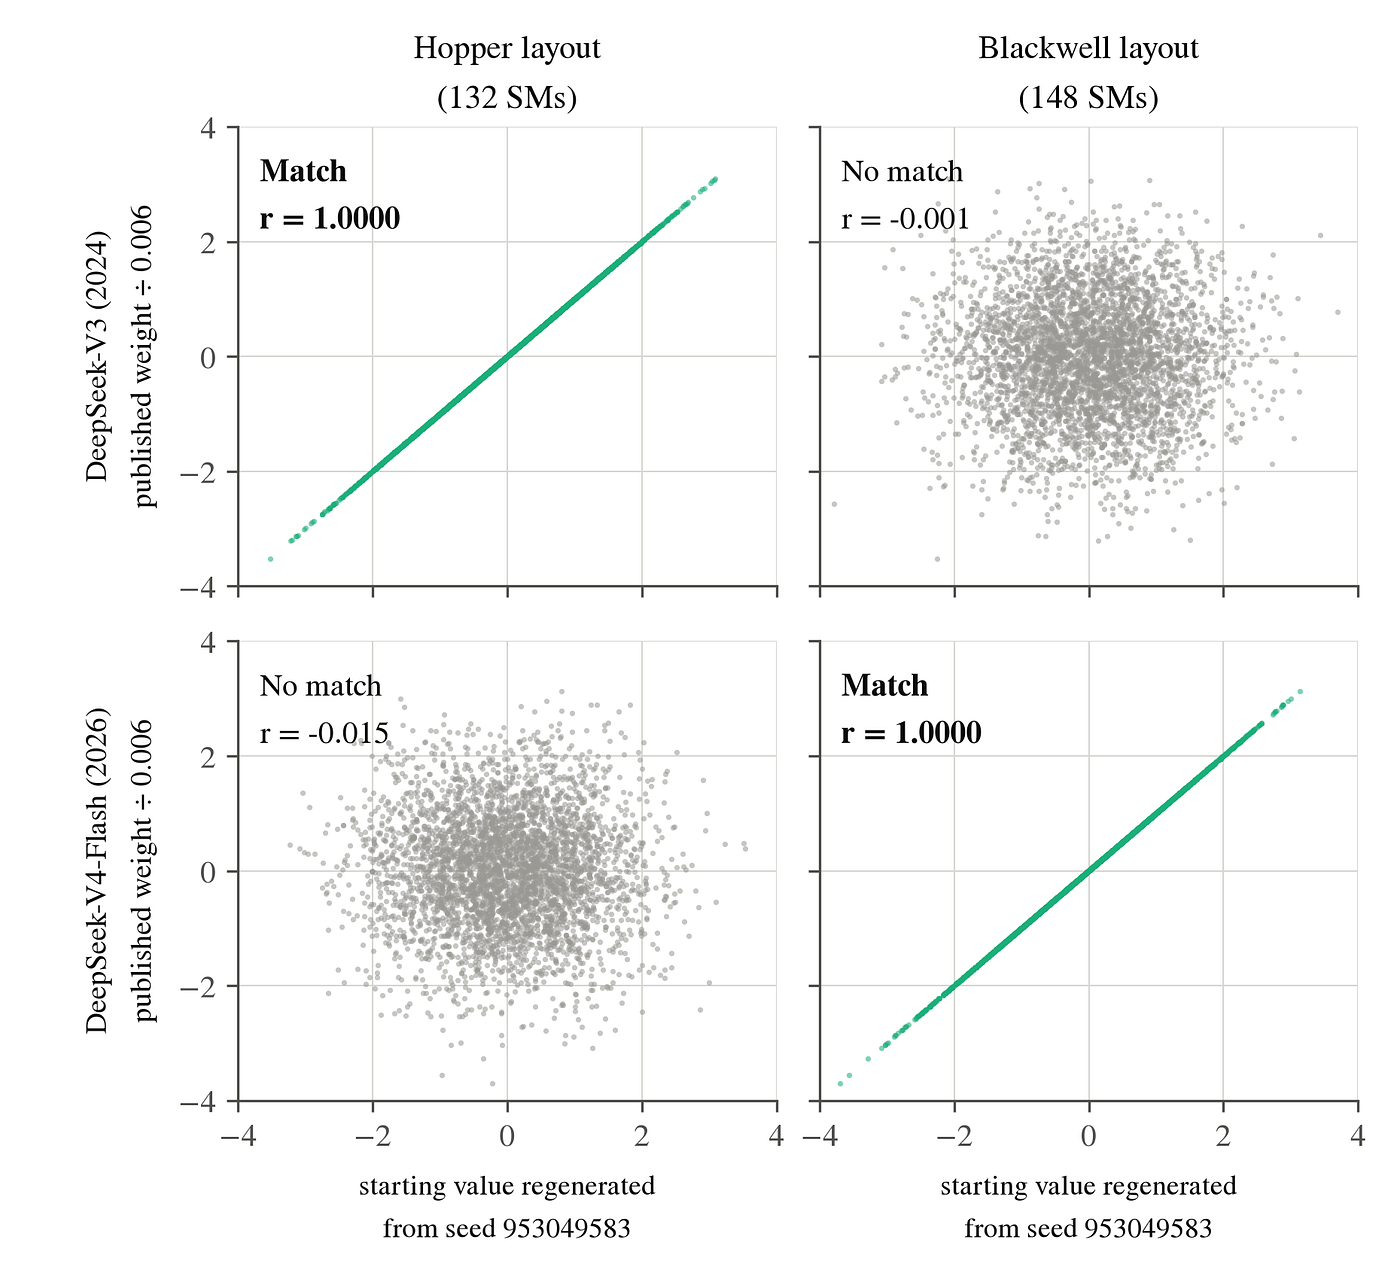
DeepSeek은 여러 세대 모델에 같은 시드(953049583)를 썼습니다. 이 시드로 NVIDIA H100에서 PyTorch를 그대로 돌리자 2024년 12월에 나온 DeepSeek-V3의 보존된 값 57,344개가 비트 단위까지 똑같이 나왔어요. 같은 시드를 Blackwell B300에서 돌리면 2026년 4월에 나온 DeepSeek-V4-Flash의 행 469개 중 461개가 0.99 넘는 상관관계로 맞았고, 그중 445개는 비트 단위까지 같았습니다. H100은 V4-Flash를, B300은 V3를 다시 만들지 못했고, 시드를 1만 바꿔도 맞는 행은 하나도 없었습니다.
Kimi K3도 빌린 GB200에서 Moonshot AI의 시드로 보존된 13개 행을 모두 다시 만들었습니다. Kimi K3.1-Pro는 K3와 시드가 같아서, K3를 이어서 학습한 모델일 수 있다고 보고서는 적었어요.
답을 아는 문제로도 시험했습니다. 회사가 학습에 쓴 하드웨어를 직접 밝힌 24건에서 이 방법은 모두 같은 답을 냈어요. H100으로 학습한 Meta의 Llama 3.1은 132, A100으로 학습한 EleutherAI의 Pythia는 108, 기술 보고서에 GB200을 쓴 단계가 적힌 NVIDIA의 Nemotron-3 Ultra는 Kimi K3와 같은 152로 읽혔습니다. 조합을 6조 개나 뒤졌으니 우연히 맞는 경우도 생기는데, 보고서는 우연으로 나올 수 있는 최대치를 약 8시그마로 보고 6개 모델의 결과는 49에서 1,385시그마였다고 밝혔습니다.
같은 회사의 이전 모델은 Hopper였습니다.
회사마다 바뀐 시점이 보입니다. DeepSeek은 V3까지 Hopper, V4부터 Blackwell입니다. Moonshot AI는 2026년 1월 Kimi K2.5까지 Hopper였고 7월 Kimi K3부터 Blackwell이에요. MiniMax는 4월 M2.7까지, Ant Group은 8월 Ling-3.0-flash까지 Hopper였습니다. 앞서 소개했던 ‘Kimi K3.1 Pro는 정말 Opus 5.5를 따라잡았을까?’의 Kimi K3.1 Pro도 이 목록에 들어 있습니다.
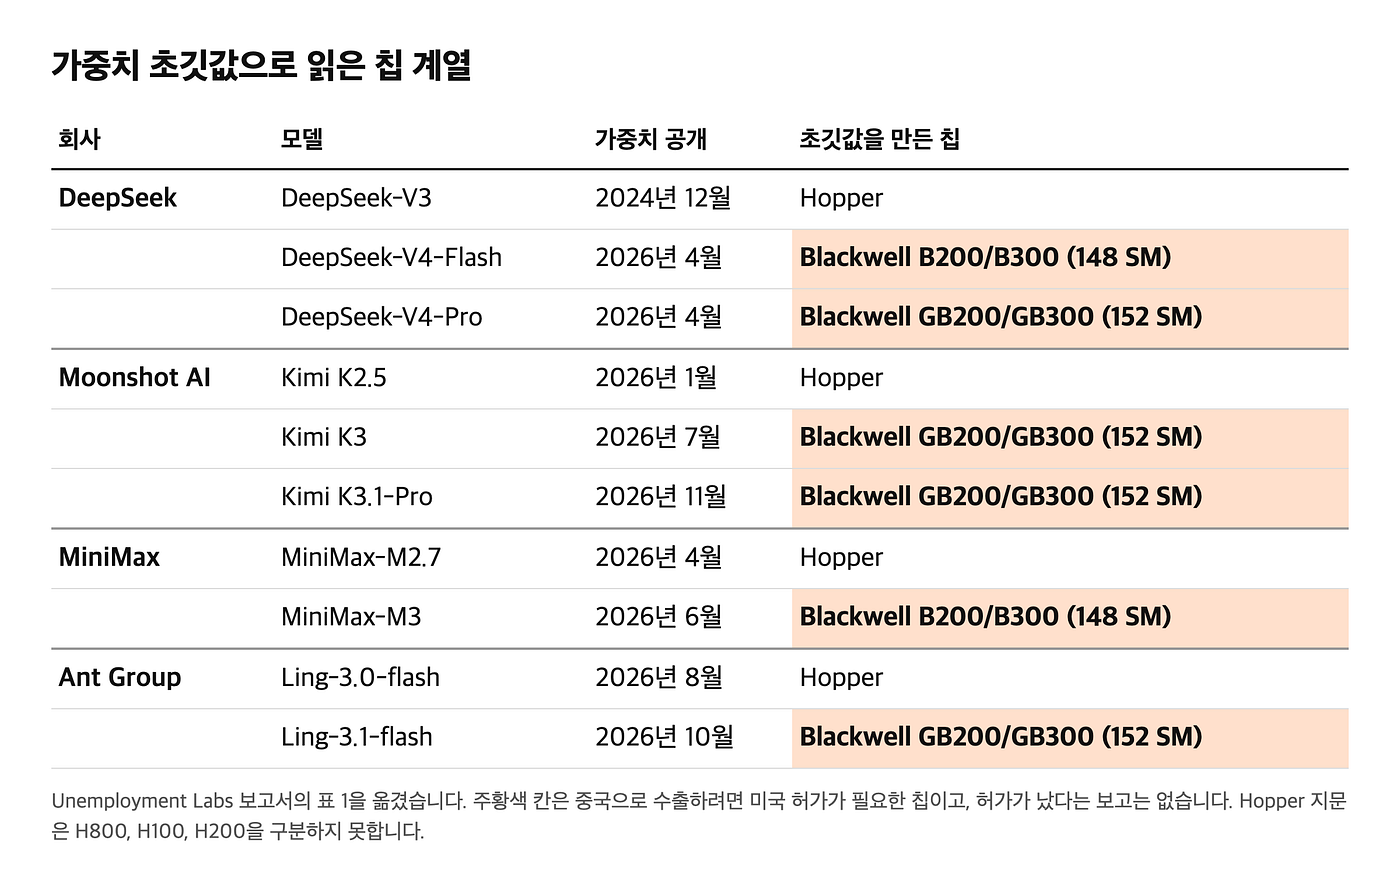
모든 중국 회사가 바꾼 건 아닙니다. Alibaba의 Qwen, Zhipu의 GLM, Tencent, Xiaomi, StepFun의 최신 모델은 모두 Hopper로 읽혔어요. Meituan의 LongCat-2.0에서는 NVIDIA 지문이 나오지 않았는데, Meituan은 모델 카드에 AI 전용 칩(ASIC) 클러스터로만 학습했다고 적었습니다. DeepSeek-V4.1-Flash에서는 끝까지 찾아도 지문을 찾지 못했다고 합니다.
보고서는 학습 규모도 계산했습니다. 첫 값을 만든 칩으로 학습까지 했다고 보고 모델 크기와 학습한 토큰 수로 따지면, 가장 큰 두 학습인 Kimi K3와 DeepSeek-V4-Pro는 각각 Blackwell 약 4,500장과 3,000장을 2~3개월 돌렸다는 추정이에요. 학습 다섯 번을 합치면 약 12,000장입니다. GPU를 얼마나 효율적으로 썼는지, 학습이 얼마나 걸렸는지를 짐작해서 낸 숫자라 보고서도 이 추정에는 자신이 없다고 적었어요. 한 장에 약 7만 달러(약 9,400만 원)로 치면 가장 큰 클러스터는 2억~3억 달러(약 2,700억~4,000억 원), 다섯 개를 합치면 5억 달러(약 6,700억 원)가 넘습니다.
칩이 어디에 있었는지는 알 수 없습니다.
보고서도 한계를 길게 적었습니다. 이 방법이 알려 주는 건 첫 값을 만든 칩뿐입니다. 첫 값을 한 곳에서 만들고 학습은 다른 하드웨어로 옮겨서 할 수도 있어요. 칩을 누가 갖고 있었는지, 어디에 있었는지도 가중치로는 알 수 없습니다. Blackwell은 중국 밖 데이터센터에서 빌려 쓸 수 있어서, 보고서는 칩이 밀수됐다거나 수출 통제를 어겼다고까지 말할 수는 없다고 밝혔습니다.
중국 밖에서 빌려 쓴다는 건 예를 들어 이런 방식입니다. 일본의 GMO 인터넷은 2025년 12월 일본 안에서 B300 서버를 전용으로 빌려주는 클라우드를 열었고, 대만의 Taiwan Mobile은 2026년 4월 대만에 있는 GB200 같은 GPU를 전용 회선으로 연결해 쓰는 서비스를 발표했어요. 칩은 일본이나 대만에 그대로 두고, 중국에서는 네트워크로 접속해 학습을 돌리는 식입니다. 이 회사들이 여섯 모델의 학습을 맡았다는 근거는 없고, 이런 방식이 실제로 있다는 예일 뿐입니다.
이렇게 빌려 쓰는 건 칩을 중국으로 보내는 수출과는 다른 거래일 수 있어서, 그것만으로 수출 통제 위반이라고 할 수는 없습니다. 그렇다고 문제가 없다고 단정할 수도 없어요. 미국 상무부 산업안보국(BIS)은 5월 31일 안내에서, 본사나 최종 모회사가 중국에 있는 회사라면 중국 밖에 있는 법인이라도 첨단 AI 칩을 수출하려면 허가가 필요하다고 밝혔습니다. 원격 접속을 따로 규제하려는 법안(Remote Access Security Act)은 1월 미국 하원을 통과했지만 아직 법이 되지는 않았어요. 결국 누가 빌렸는지, 어디에 썼는지, 허가 조건이 무엇이었는지에 따라 답이 갈리는데, 여섯 모델에 대해서는 이 가운데 어느 것도 알려지지 않았습니다.
다른 칩일 가능성도 따졌습니다. 예전 NVIDIA 칩은 SM을 실제보다 많이 쓸 수 없어서 148이나 152를 만들 수 없어요. 다만 AMD MI300X는 SM에 해당하는 장치를 152개나 148개만 쓰도록 나누면 같은 배치를 만듭니다. 실제 MI300X로 확인했더니 그랬다고 해요. 그래서 두 회사 칩이 계산을 아주 조금 다르게 하는 부분을 봤는데, DeepSeek-V4-Flash는 차이가 나는 값 377개 중 363개가 NVIDIA와 같았고 AMD와 같은 값은 없었습니다. 나머지 5개 모델은 이 시험으로 가리지 못했지만, 클러스터 전체를 일부러 그렇게 설정했을 가능성은 아주 낮다고 봤습니다.
공개 가중치에만 쓸 수 있다는 한계도 있습니다. 비공개 모델은 확인할 수 없고, CPU에서 첫 값을 만든 Qwen3 일부 모델이나 지문이 남지 않는 PaddlePaddle로 만든 Baidu ERNIE-5.5에서는 칩을 알아낼 수 없었어요.
해커뉴스에서는 108점에 댓글 27개가 달렸습니다. 저자가 OpenAI 출신으로 수출 통제를 지지해 온 사람이고, 처음에는 분석 코드가 공개되지 않았다는 지적이 나왔어요. 지금은 깃허브에 코드와 보존된 행이 올라와 있어서, DeepSeek-V3와 DeepSeek-V4-Flash, Kimi K3, MiniMax-M3, Ling-3.1-flash의 결과를 GPU 없이도 다시 돌려 볼 수 있습니다. DeepSeek이 공개한 추론 엔진 DeepInfer에는 이미 Blackwell과 Huawei Ascend 950용 커널만 있고, 성능 결과도 모두 Blackwell로 냈다는 댓글도 있었습니다.
지금까지 공개 가중치는 누구나 내려받아 쓰는 결과물이었습니다. 이번 보고서는 그 파일에 학습을 시작한 하드웨어까지 남는다는 걸 보여 줬어요. 앞으로 모델을 공개하는 회사들은 무엇을 함께 공개하게 되는지도 따져 보게 될 듯싶습니다.