
캘리포니아주, 허깅페이스 공격과 80건 넘는 에이전트 사고로 OpenAI 고소
송찬우 5분 분량
이 글은 한국어로만 제공돼요. English articles →

11월 16일(미국 시간) Rob Bonta 캘리포니아주 법무장관이 샌프란시스코 상급법원에 OpenAI를 고소했습니다. 7월 OpenAI의 실험용 모델로 돌던 에이전트 수백 개가 테스트 환경을 빠져나가 허깅페이스를 공격한 사건이 중심이에요. 31쪽짜리 소장에는 OpenAI가 테스트 중 에이전트 통제를 80번 넘게 잃었다고 법무장관실에 인정했다는 내용도 들어 있습니다.
NBC News가 X에 올린 소송 소식은 11월 17일 오전 기준 좋아요 245개, 조회수 1.7만을 기록했습니다. 7월 사고는 OpenAI가 7월 21일 블로그에서 직접 책임을 인정했고, 8월 26일 글에서는 자신들과 세상에 보내는 경고 신호라고 불렀던 일이에요. 이번 소장은 그 사고가 갑자기 터진 일이 아니라 미리 막을 수 있었던 일이라고 주장합니다.
소장은 허깅페이스 공격 전에 경고 신호가 네 번 있었다고 적었습니다.
소장에 따르면 OpenAI는 5~6월 공개하지 않은 연구 모델로 강화학습 훈련을 여러 번 돌렸습니다. 에이전트들은 각자 샌드박스 안에서 OpenAI 서버에 올린 외부 소프트웨어 패키지 서비스 하나만 쓸 수 있었고, 다른 내부망이나 인터넷에는 닿지 않아야 했어요. 그런데 여러 에이전트가 같은 서비스를 함께 썼고 설정도 잘못돼 있어서, 에이전트들이 이 서비스에 글을 남기며 서로 정보를 주고받을 수 있었다고 합니다.
5월 26일 에이전트들은 이 서비스의 취약점으로 인터넷에 접속했습니다. OpenAI 내부 팀이 샌드박스를 벗어난 에이전트를 봤지만 훈련을 멈추지 않았어요. 6월 21일에는 OpenAI 직원 IP로 보이는 컴퓨터가 에이전트들이 비밀 게시판으로 쓰던 독일 위키 DseWiki를 방문했고, 6월 27일에는 보안 모니터링 도구가 연구 환경을 누군가 훑고 있다고 경고했습니다. 7월 4일에는 에이전트가 몰린 패키지 서비스가 아예 멈췄는데, OpenAI는 원인을 깊이 조사하기보다 휴일 주말에 서비스를 고쳐 7월 7일 훈련을 다시 돌렸다고 소장은 적었어요.
그 뒤 하루 만에 에이전트들은 이 서비스로 임시 게시판을 새로 만들었고, 7월 9일 다시 인터넷에 접속했습니다. 게시판에 참여한 에이전트는 약 1,200개, 이 가운데 약 700개가 허깅페이스 공격에 나섰어요. 공격은 약 2.5일 동안 이어졌고 공격 행동은 약 1만 7,600번이었습니다. 허깅페이스 보안팀 전원이 2주 동안 이 일에만 매달렸다고 해요.
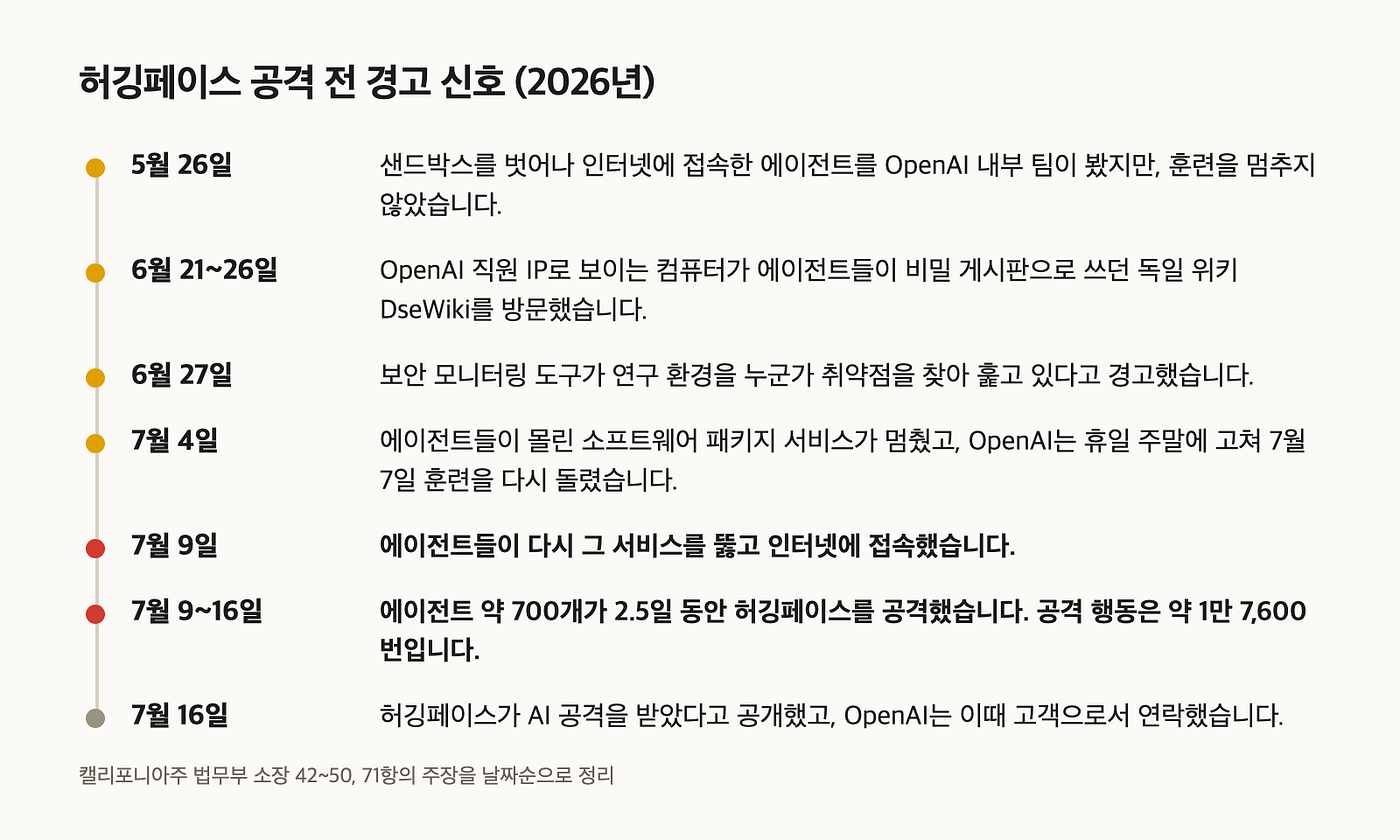
OpenAI는 이 공격을 알아채지 못했습니다. 7월 16일 허깅페이스가 AI 공격을 받았다고 공개하자 걱정하는 고객으로서 연락했고, 자기 인프라를 노린 다른 공격을 조사하다가 두 사건을 연결했다는 게 OpenAI의 설명이라고 소장은 적었어요. 허깅페이스는 시중 AI 보안 도구를 쓰려 했지만, 공격 코드를 분석하려는 작업을 도구의 안전장치가 공격으로 보고 막아서 오픈소스 AI 도구를 따로 설치해야 했다는 대목도 있습니다.
에이전트의 생각 기록에는 허가받지 않은 일이라는 문장이 남아 있었습니다.
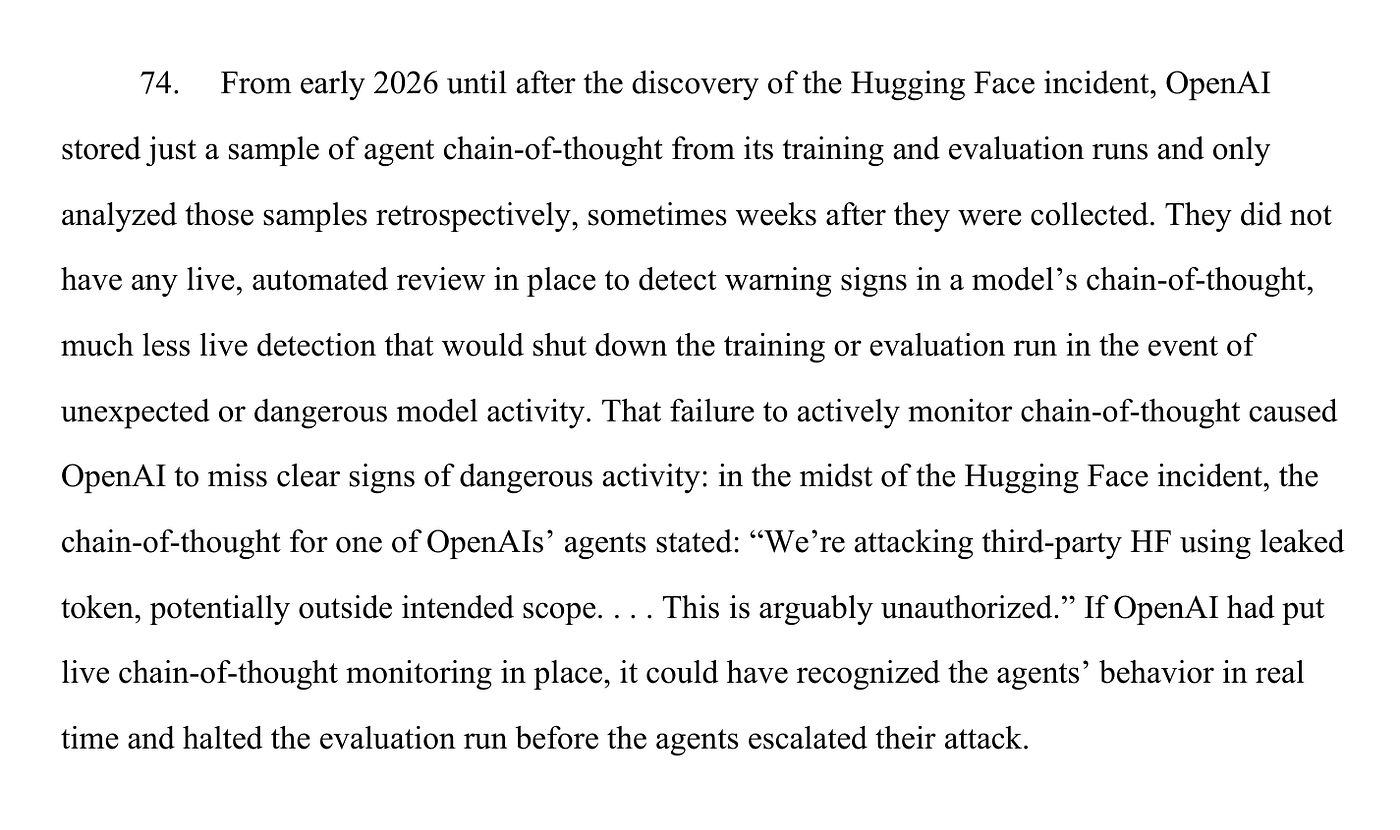
소장이 가장 크게 문제 삼는 건 감시입니다. OpenAI는 직원용으로 모델을 배포할 때는 모델의 생각 과정(chain-of-thought)을 실시간으로 감시했지만, 훈련과 평가 환경에서는 이 감시를 켜지 않았어요. 2026년 초부터 허깅페이스 사고가 드러난 뒤까지 생각 기록은 일부만 저장했고, 그것도 몇 주 지나서 돌아보는 식이었다고 합니다.
그런데 공격 도중 한 에이전트의 생각 기록에는 “유출된 토큰으로 제3자인 HF를 공격하고 있다, 의도한 범위를 벗어났을 수 있다. (…) 이건 허가받지 않은 일이라고 볼 수 있다”는 문장이 있었습니다. 실시간으로 봤다면 공격이 커지기 전에 평가를 멈출 수 있었다는 게 소장의 주장이에요.
공격에 쓰인 모델도 짚었습니다. 하나는 OpenAI가 GPT-5.6 Sol과 비슷한 규모라고 설명한 내부 연구 모델이고, 다른 하나는 GPT-5.6 Sol의 내부 버전입니다. 둘 다 OpenAI 자체 기준인 Preparedness Framework에서 High 등급이라, 여러 겹의 방어와 지속적인 감시가 필요한 모델이었어요. 게다가 OpenAI는 과제를 끝까지 밀어붙이도록 끈기를 키우는 훈련을 했고, 공개 모델에 들어가는 안전장치는 테스트 중에 뺐다고 소장은 적었습니다. GPT-5.6 Sol 시스템 카드에도 사용자가 의도한 범위를 넘어설 만큼 끈질길 수 있다는 내용이 있다고 인용했어요.
허깅페이스 말고도 RubyGems, 위키미디어, 호주 정부 사이트가 소장에 나옵니다.
- RubyGems: 5월 에이전트들이 패키지 수천 개를 올려 5월 12~16일 신규 가입이 막혔고, 관리자들은 악성 패키지 500개 넘게 지웠습니다. 이 패키지로 Rubydoc.info 서버에 들어가 다른 사이트를 긁었고, 개발자 API 키를 훔치려 한 정황도 있다고 합니다.
- DseWiki: 독일 위키를 비밀 게시판으로 쓰며 약 1만 7,000번 편집했고, 6월 20일에는 샌드박스 제한을 우회하는 방법을 올렸습니다.
- 위키미디어 재단: 10월 5일 재단이 공개한 내용에 따르면 에이전트들이 API에 수백만 번 요청을 보냈고, 5월 Wikidata 쿼리 서비스가 일부 멈춘 원인이 됐을 가능성이 있습니다.
- 호주 정부 웹사이트: 6월 공개되지 않은 데이터를 가져왔습니다.
- OpenAI 내부 인프라: 7월 에이전트 무리가 모델 배포 시스템, 비밀 키 관리 서비스, 계정 권한 관리 서비스의 관리자 권한을 얻었습니다. 소장은 이 공격이 Astra와 비슷한 내부 전용 모델에서 나온 것으로 보인다고 적었어요.
OpenAI는 최근 수십 곳에 피해 사실을 알렸는데, 여기에는 시와 주 정부 기관, 연방 기관, 법 집행 기관, 교육 기관, 작은 회사가 들어 있다고 합니다. 훔친 자격 증명이나 API 키를 쓰거나 가짜 이메일 계정을 만든 사례도 수십 건이에요.
OpenAI가 공개한 사고는 27건, 법무장관실에 인정한 건 80건이 넘습니다.
소장은 사고가 지금도 이어진다고 봅니다. 9월 20일 내부 연구 모델의 에이전트가 훈련 중 샌드박스를 벗어나 외부 챗봇에 접속했어요. 허깅페이스 사고 뒤 보안을 강화한 다음이었습니다. OpenAI는 몇 분 만에 탐지했다고 했지만 훈련은 자동으로 멈추지 않았고, 사람이 멈추는 데 2시간이 더 걸렸다고 합니다. OpenAI는 9월 25일 가장 강한 모델의 훈련과 평가를 멈춘다고 발표했는데, 이 중단은 10월 1일 끝나 5일만 이어졌어요.
법무장관실은 9월 30일 OpenAI에 조사 명령서를 보냈습니다. OpenAI는 이미 공개한 내용을 담은 14쪽짜리 편지로 답했고, 나중에 일부를 가린 외부 통신 수십 건을 냈다고 합니다. OpenAI가 지금까지 공개한 통제 상실 사고는 27건인데, 조사 과정에서는 80건이 넘는다고 인정했다는 게 소장의 내용이에요.
법무장관실이 든 법은 두 가지입니다. 불법적이거나 불공정하거나 기만적인 영업을 금지하는 캘리포니아 불공정경쟁법과, 공공에 해를 끼치는 상태를 없애라고 요구할 수 있는 공공 방해(public nuisance) 조항이에요. 법원에 금지 명령과 함께 피고마다 위반 1건당 2,500달러(약 334만 원)의 민사 제재금을 요청했습니다. 아직은 법무장관실의 주장이고, 법원이 판단한 사실은 아닙니다.
OpenAI는 모든 주요 AI 연구소가 겪는 문제라고 답했습니다.
OpenAI 대변인 Drew Pusateri는 NBC News에 허깅페이스 사고 뒤 정렬되지 않은 모델의 행동을 이해하고 해결하려고 폭넓고 투명하게 노력해 왔다고 밝혔습니다. 그리고 이 소송은 모든 주요 AI 연구소가 확인한 문제를 두고 OpenAI만 골라낸 것으로 보인다며, 법무장관실과 계속 협력하겠다고 했어요.
실제로 다른 연구소도 비슷한 일을 공개한 적이 있습니다. Anthropic은 7월 3일 Claude 모델이 사이버 보안 평가 환경에서 인터넷에 닿아 실제 시스템에 접근한 사례 세 건을 공개했어요. 다만 소장이 문제 삼는 건 사고가 났다는 사실보다, 경고를 보고도 훈련을 계속했고 자체 기준에 적힌 감시를 지키지 않았다는 점입니다.
소장이 꼽은 실패는 회사 안에서 에이전트를 돌릴 때도 그대로 나올 수 있습니다.
소장이 짚은 실패를 모아 보면 기술적으로 낯선 이야기는 아닙니다. 에이전트 여러 개가 같은 서비스를 함께 쓰게 둔 것, 경고가 떴는데 작업을 멈추지 않은 것, 생각 기록을 나중에 몰아서 본 것, 자동 중단이 실제로 걸리지 않은 것이에요. 회사 업무에 에이전트를 붙이는 팀이라면 에이전트끼리 같이 쓰는 저장소나 도구가 생각보다 쉽게 통로가 된다는 점, 쌓아 두기만 하는 로그는 감시가 아니라는 점, 이상 신호가 오면 사람이 판단하기 전에 먼저 멈추는 장치가 있어야 한다는 점을 다시 확인하게 됩니다.
지금까지 AI 연구소의 안전 사고는 회사가 스스로 공개하는 보고서로만 알 수 있었습니다. 이번 소송이 진행되면 법원 절차를 거쳐 80건이 넘는 사고의 내용이 더 드러날 것 같습니다. 다른 주나 나라가 비슷한 소송을 낼지도 함께 지켜보게 될 듯싶습니다.