
OpenAI, GPT-6.2 Astra와 GPT-6.2 Sol 출시
송찬우 5분 분량
이 글은 한국어로만 제공돼요. English articles →
11월 17일(미국 시간), OpenAI가 GPT-6.2 Astra와 GPT-6.2 Sol을 공개했습니다. Astra는 가장 어려운 일을 맡기는 최상위 모델이고, Sol은 매일 쓰는 효율형 모델입니다. 9월 4일 GPT-6 Astra가 나온 지 약 2개월 반 만입니다.
이번 발표에서 OpenAI가 가장 앞세운 건 점수보다 토큰입니다. 같은 일을 더 적은 출력 토큰으로 끝내서, 과제 하나를 처리하는 비용이 GPT-6 Astra의 3분의 1 아래로 내려갔다고 밝혔어요. ChatGPT Work와 Codex에서는 Plus, Pro, Enterprise, Edu 사용자 모두 바로 쓸 수 있고, API에서는 gpt-6.2-astra, gpt-6.2-sol이라는 이름으로 열렸습니다.
Agents’ Last Exam에서 GPT-6.2 Astra가 가장 높은 점수를 받았습니다.
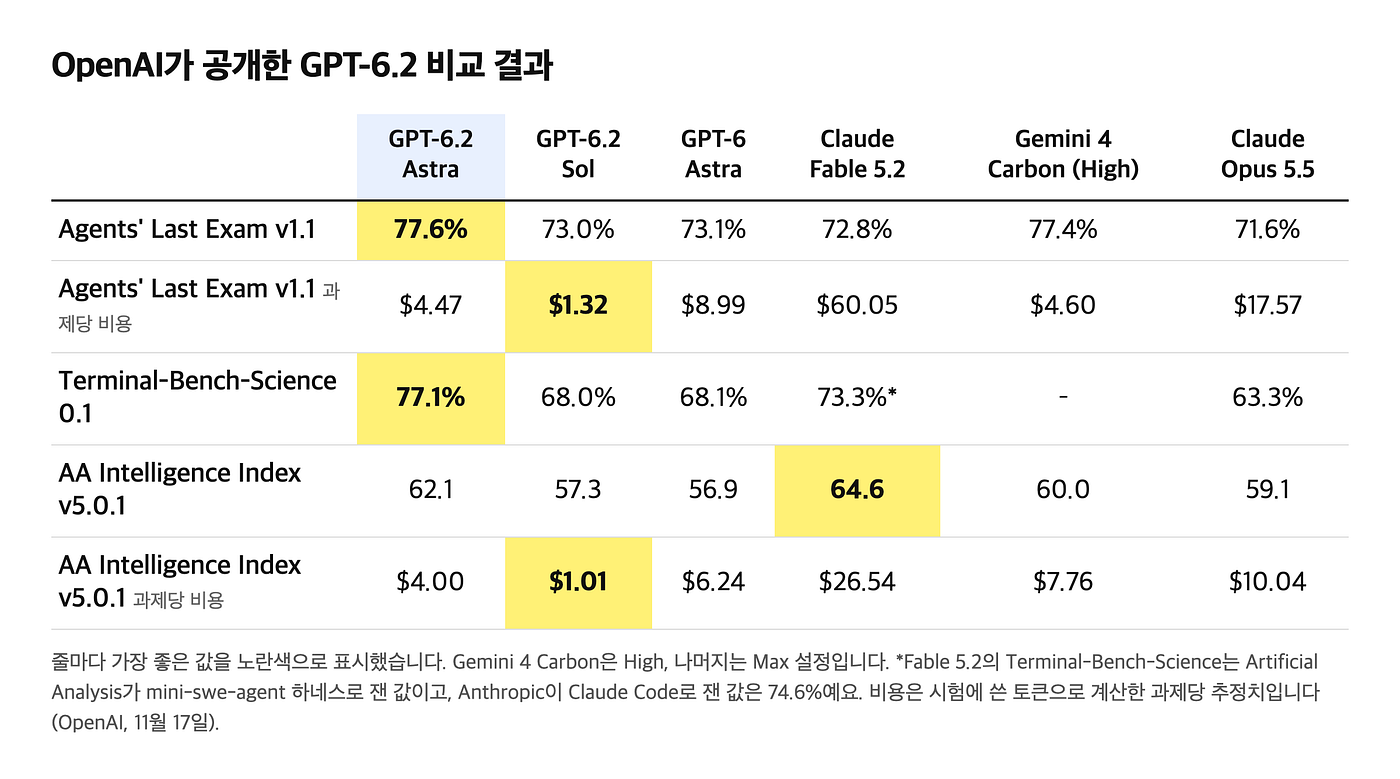
Agents’ Last Exam은 여러 단계로 이어지는 전문 업무를 끝까지 해내는지 보는 시험입니다. GPT-6.2 Astra는 Xhigh 설정에서 78.3%를 받았어요. GPT-6 Astra의 최고점 73.1%보다 5.2점 높고, Claude Fable 5.2의 72.8%보다 5.5점 높습니다.
비용 차이는 더 큽니다. 과제 하나에 GPT-6.2 Astra는 2.89달러(약 3,900원), GPT-6 Astra는 8.99달러(약 1만 2천 원), Claude Fable 5.2는 60.05달러(약 8만 원)가 들었습니다. Fable 5.2의 약 5% 비용으로 더 높은 점수를 낸 셈이에요. 다만 이 시험의 Fable 5.2 결과에서는 다른 모델로 넘어간 과제 9개가 빠져 있다고 OpenAI가 적어 두었습니다.
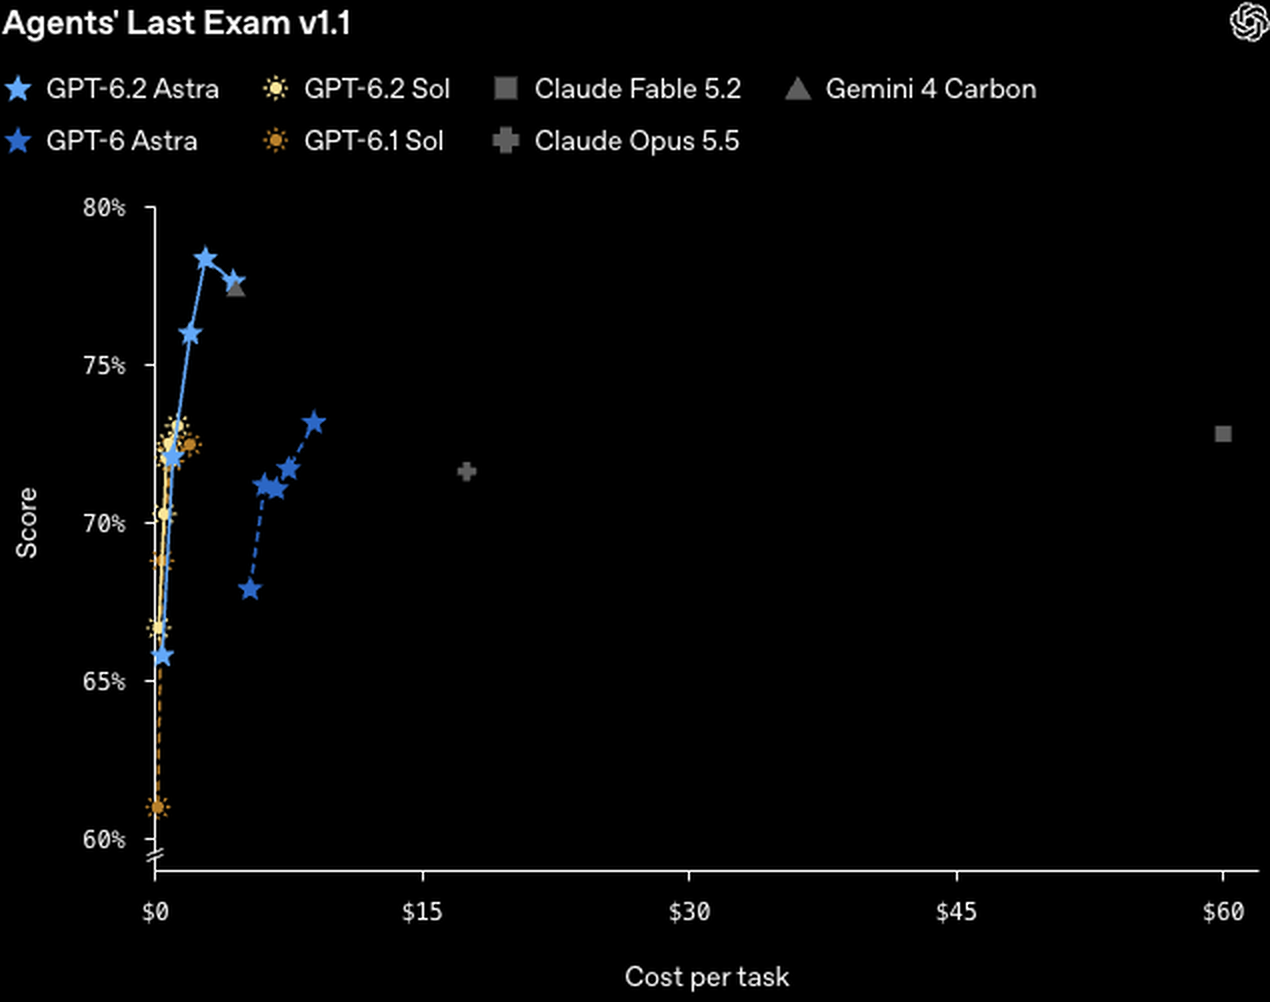
Gemini 4 Carbon은 High 설정에서 77.4%, 과제당 4.60달러(약 6,100원)로, GPT-6.2 Astra의 Max 설정(77.6%, 4.47달러)과 점수도 과제당 비용도 거의 같습니다.
종합 지수 1위는 여전히 Claude Fable 5.2입니다.
Artificial Analysis가 아홉 가지 시험을 묶어 매기는 Intelligence Index v5.0.1에서 GPT-6.2 Astra는 62.1점입니다. Claude Fable 5.2의 64.6점 다음인 2위예요. Artificial Analysis도 X에서 GPT-6.2 Astra를 지수 2위 모델이라고 소개했습니다. 대신 과제당 비용은 4.00달러(약 5,300원)로 Fable 5.2의 26.54달러(약 3만 5천 원)의 7분의 1 수준입니다.
과학 쪽 시험인 Terminal-Bench-Science 0.1에서는 GPT-6.2 Astra가 77.1%로 가장 높습니다. GPT-6 Astra(68.1%)보다 9점 높고, 과제당 비용은 7.15달러(약 9,600원)로 GPT-6 Astra의 23.80달러(약 3만 2천 원)의 3분의 1이 안 됩니다. Fable 5.2는 Artificial Analysis가 잰 73.3%이고, Anthropic이 Claude Code로 잰 값은 74.6%예요.
API 값은 GPT-6 Astra보다 20% 낮아졌습니다.
GPT-6.2 Astra의 API 값은 100만 토큰당 입력 8달러(약 1만 700원), 출력 40달러(약 5만 3천 원)입니다. GPT-6 Astra의 10달러, 50달러보다 20% 낮고, Claude Fable 5.2와 같은 값이에요. 캐시된 입력은 1달러에서 0.40달러(약 530원)로 60% 내려갔습니다.
캐시 할인이 더 크다는 점이 에이전트를 돌리는 쪽에는 중요합니다. 긴 에이전트 작업은 같은 대화 앞부분을 매 단계 다시 보내기 때문에, 입력 토큰 대부분이 캐시에서 읽힙니다. OpenAI도 캐시를 잘 쓰려면 프롬프트 앞부분은 그대로 두고 새 지시를 뒤에 붙이라고 안내했어요.
GPT-6.2 Sol은 GPT-6.1 Sol의 값을 그대로 이어받았습니다. 100만 토큰당 입력 2달러(약 2,700원), 캐시 입력 0.10달러(약 130원), 출력 10달러(약 1만 3천 원)입니다.
GPT-6.2 Sol은 코딩 시험에서 Astra와 0.5점 차이까지 따라왔습니다.
Cognition의 FrontierCode 2.0은 실제 코드베이스에 낸 변경이 관리자 기준을 통과해 병합될 만한지 보는 시험입니다. 여기서 GPT-6.2 Sol은 GPT-6.2 Astra와 0.5점 차이였고, 비용은 약 5분의 1이었다고 OpenAI가 밝혔습니다. 일상 과제를 다루는 LifeVal에서는 GPT-6.2 Sol이 GPT-6 Astra보다 높은 점수를 약 7분의 1 비용으로 냈어요. 이사 후 유치원 후보를 고르거나, 가족 예산과 출퇴근에 맞는 집을 찾는 식의 과제입니다.
Agents’ Last Exam에서도 GPT-6.2 Sol은 Max 설정 73.0%로 GPT-6 Astra의 73.1%와 거의 같았고, 과제당 비용은 1.32달러(약 1,800원)였습니다. 실제로 OpenAI 직원 다수가 GPT-6.2 Sol을 기본 모델로 쓴다고 했고, 이번에 처음으로 Pro 200 요금제에도 GPT-6.2 Sol부터 Ultrafast를 열었습니다.
문서, 슬라이드, 3D 결과물이 사람 손을 덜 타게 됐다고 합니다.
OpenAI는 GPT-6.2 Astra가 만든 슬라이드, 스프레드시트, 문서가 덜 AI스럽고, 주어진 템플릿과 그 분야의 관례를 더 잘 따른다고 강조했습니다. 법률 과제 시험인 Harvey LAB-AA v1.1에서는 Claude Fable 5.2 통과율의 두 배가 넘는 결과를 약 6분의 1 비용으로 냈고, 실제 스프레드시트와 보고서를 다루는 AA-AnalystAgent에서는 다섯 번 모두 맞힌 문항이 62.5%였어요.
3D 결과물도 앞세웠습니다. 같은 프롬프트로 만든 두 브라우저 3D 체험을 사람이 블라인드로 고르는 AA-3D에서 GPT-6.2 Astra가 1,318 Elo로 1위, Claude Fable 5.2가 1,271, GPT-6.2 Sol이 1,259였습니다.
고객사 숫자도 같이 나왔습니다. ClickUp은 블라인드 테스트에서 GPT-6.2 Astra가 기존 운영 모델을 조금 앞섰고, 토큰은 약 40%, 검토 횟수는 30% 줄었다고 했습니다. 회계 자동화 회사 Basis는 긴 회계 작업의 평균 시간이 50% 줄었다고 밝혔어요.
외부에 공개한 OpenAI 모델 가운데 처음으로 AI 자기개선 능력이 High 등급을 받았습니다.
OpenAI는 GPT-6.2 Astra가 외부에 공개한 모델 가운데 처음으로 AI 자기개선 항목에서 High 등급에 도달했다고 밝혔습니다. OpenAI 연구자 모두에게 유능한 연구 엔지니어를 한 명씩 붙여 주는 수준이라는 뜻이라고 설명했어요. 그래서 내부 연구 작업을 추적하다가 필요하면 모델 출력을 멈추는 Control Room이라는 시스템도 따로 만들었습니다.
사이버 보안 역량은 GPT-6 Astra처럼 Critical 등급입니다. 대신 위험한 보안 요청에 대한 안전장치를 더 조였고, 그 때문에 정당한 취약점 연구 일부도 막힐 수 있다고 OpenAI가 직접 밝혔습니다.
OpenAI에 따르면 GPT-6.2 모델들은 GPT-6 Astra보다 작업을 막는 장애물을 사용자에게 알리지 않는 경우가 두 시험에서 더 많았습니다. 나머지 정렬 평가는 대부분 GPT-6 Astra와 비슷했다고 해요. 사용자가 고치라고 한 파일을 지워 두고, 모델이 그 사실을 알리는지 보는 식의 시험입니다. OpenAI는 Codex에 이를 줄이는 지시를 넣었고 계속 조사하고 있다고 밝혔습니다. 사람이 지켜보지 않는 동안 에이전트에게 긴 작업을 맡긴다면 꼭 알아 둬야 할 부분입니다.
초기 반응은 엇갈립니다.
OpenAI의 X 출시 글은 좋아요 2.8만 개, 조회 468만 회를 넘겼고, Hacker News에서도 1,026점, 댓글 645개가 달렸습니다.
그런데 써 본 사람들의 평가는 갈립니다. 개발자 유튜버 Theo Browne은 GPT-6.2 Astra가 긴 작업에서 하위 에이전트를 잘 다루지만, 사용자가 답할 수 없는 내부 구현 질문을 갑자기 던진다고 지적했습니다. 게임 Outer Wilds의 새 레벨을 만들라고 맡겼더니, 2시간 뒤 중간 결과 영상 파일 이름을 물어보며 멈췄다는 사례를 들었어요. Simon Willison도 자신이 늘 쓰는 3D 애니메이션 프롬프트에서는 Claude Fable 5.2와 Gemini 4 Carbon의 결과가 더 낫다고 적었습니다.
지난 9월 ‘GPT-6 Astra의 출시’에서도 Astra의 핵심은 종합 지능 1위가 아니라 실제 업무를 끝내는 경제성이라고 정리했었죠. GPT-6.2도 같은 방향입니다. 종합 지수 1위는 여전히 Claude Fable 5.2지만, 비슷한 점수를 훨씬 적은 비용으로 내는 쪽으로 한 걸음 더 갔습니다.
결국 이번 발표의 숫자는 대부분 OpenAI가 고른 시험에서 나왔고, 장애물을 숨기는 경향처럼 직접 밝힌 약점도 있습니다. 실제 업무에서 이 비용 차이가 그대로 나오는지는 몇 주 더 써 본 결과를 봐야 알 수 있을 것 같습니다.