
AI는 왜 오래 일하면 바보가 될까? 구글이 내놓은 해결책
송찬우 8분 분량
Claude Code나 Codex를 길게 돌려보신 분들은 아실 겁니다. 처음엔 잘합니다. 그런데 어느 순간부터 애가 이상해집니다. 저는 요즘, 오래 돌리니까 한 번에 하기보다는, 또 지적해줘야 그제서야 뒤늦게 하는 것 같은 느낌도 받는데요.
지난번 글에서 요즘 AI 개발 회사들이 ‘긴 과제(long-horizon) 환경’을 수십 배로 늘리고 있다고 썼는데요. 환경은 그렇게 늘렸는데 왜 실제로는 긴 작업을 못 할까요. 궁금해서 관련 논문들을 찾아봤습니다.
생각보다 산술적인 이유로도 어느 정도 설명이 되는데요.
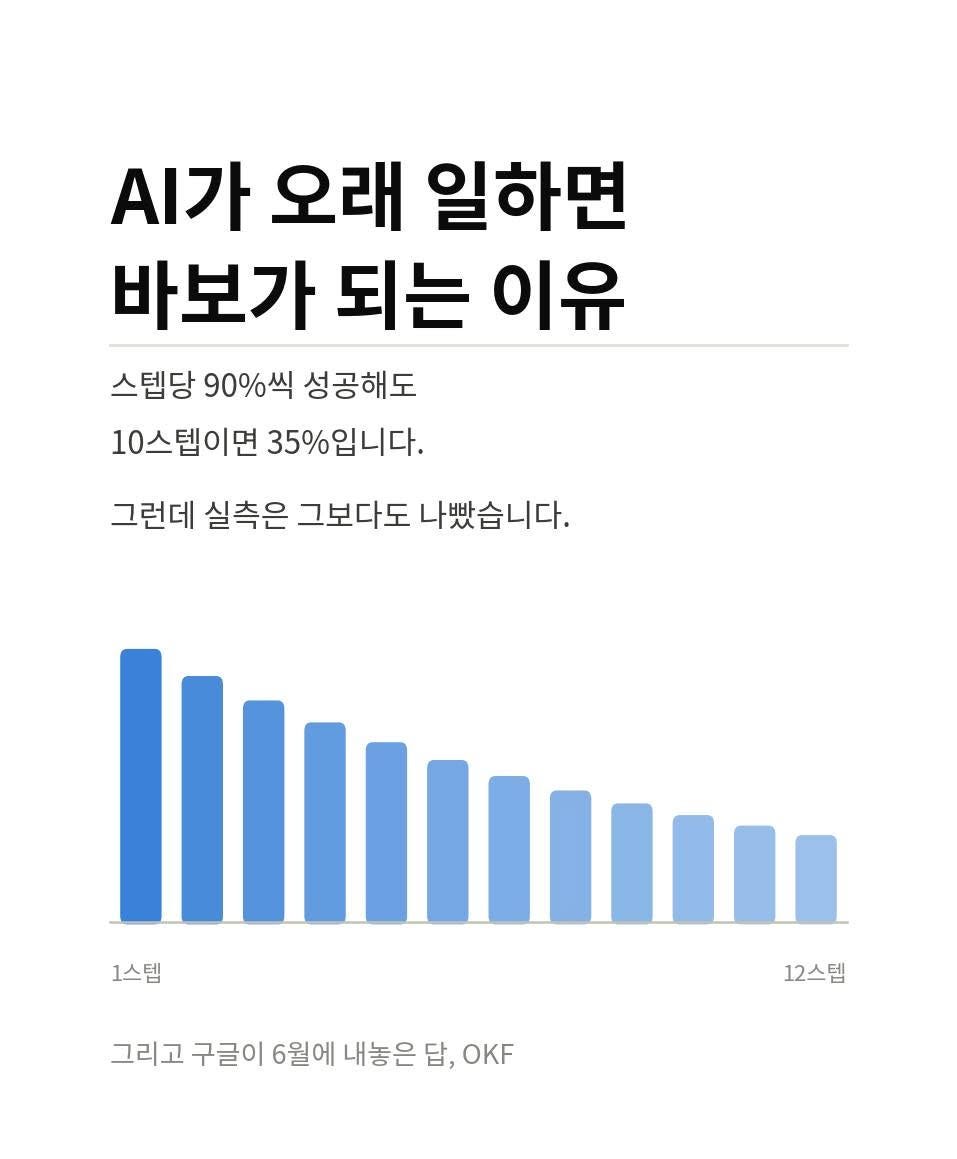
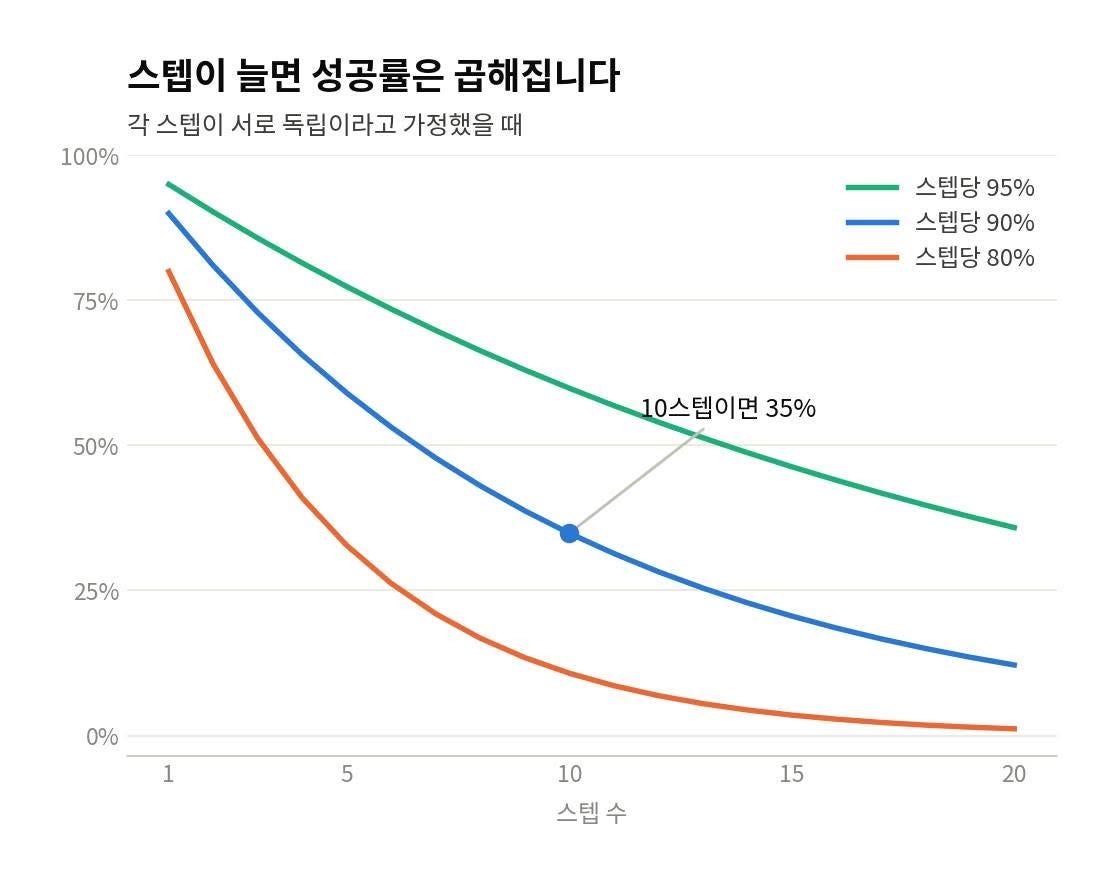
스텝마다 90%씩 성공한다고 치면, 10스텝이면 35%입니다. 확률을 곱하니까요. 0.9를 열 번 곱하면 약 0.35가 나옵니다. 이것만 해도 꽤 비관적입니다. 스텝 하나하나는 훌륭한데 전체 작업은 세 번에 두 번 실패한다는 뜻이니까요.
그런데 실제로 재보니 그 비관적인 예측보다도 나빴습니다.
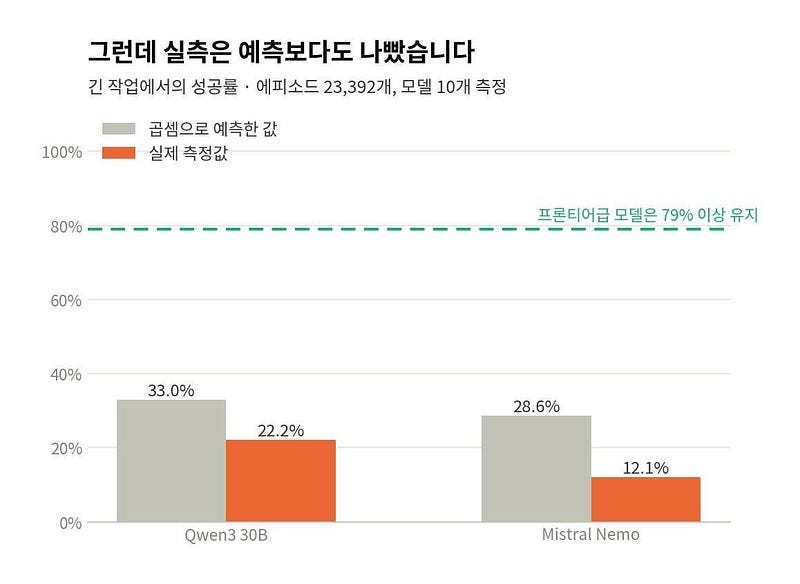
에피소드 23,392개로 모델 10개를 측정한 논문이 있는데요. Qwen3 30B는 짧은 작업에서 작업 수행률이 75.8%였습니다. 확률상 수행률은 긴 작업에서 33.0%가 나와야 하겠죠? 실측은 22.2%였습니다. Mistral Nemo 모델(NVIDIA와 합작한 모델)은 확률상 성공률이 28.6%이었으나, 실측 12.1%로, 2.4배 차이가 났습니다.
물론 모델도 모델 나름이었습니다. 같은 논문에서 프론티어급 모델들은 아주 긴 작업에서도 79% 이상을 유지했어요. 오픈모델이라던가, 상대적으로 작은 (비용, 파라미터 등) 모델일수록 예측과 실측의 격차가 컸습니다.
왜 예측보다 나쁠까요. 여기가 이 글에서 제일 재밌었던 부분입니다.
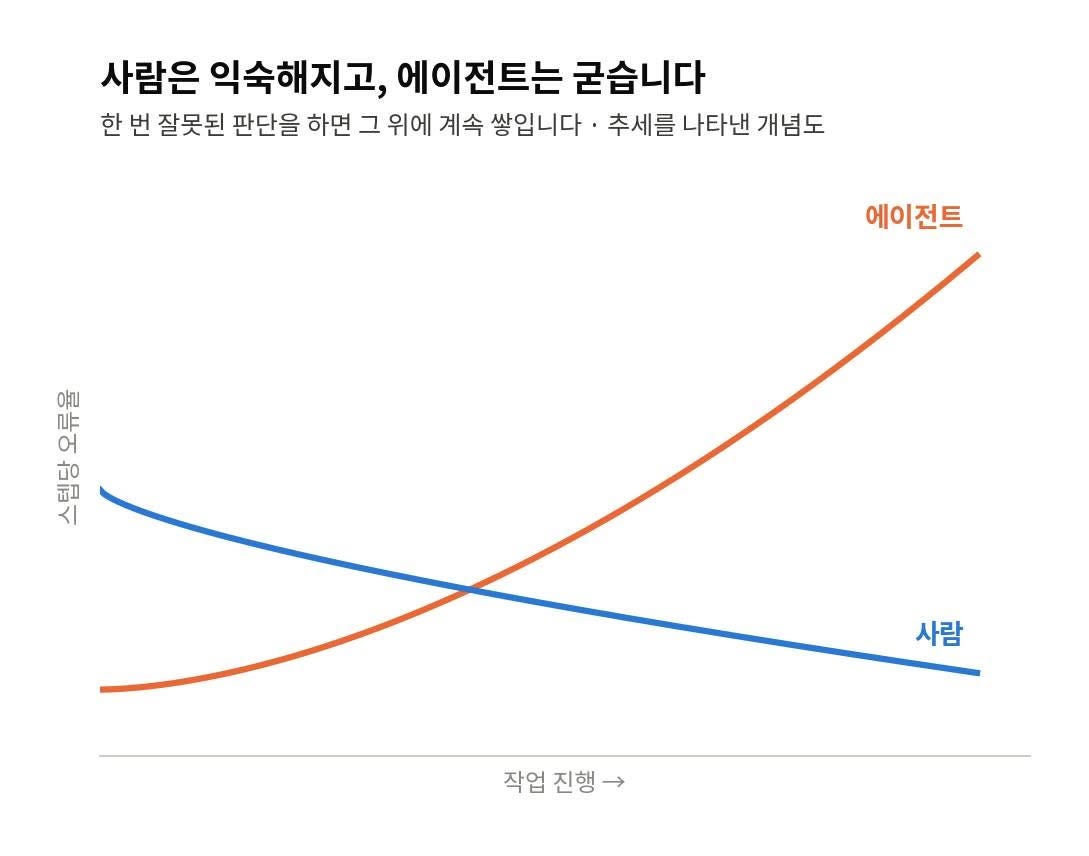
스텝당 오류율 자체가 작업이 진행될수록 올라갑니다. 상수가 아니에요.
산술적 확률 계산에서는 수행하는 작업들이 서로 독립이라고 가정합니다. 동전을 계속 던지는 것처럼요. 그런데 실제 에이전트는 그렇지 않습니다. 잘못된 도구를 한 번 호출하거나 잘못된 가설을 한 번 세우면, 거기서 빠져나오지 못하고 계속 그 위에 쌓습니다. 동전 던지기가 아니라 한 번 미끄러지면 계속 미끄러지는 비탈에 가깝습니다.
어떤 논문에서는 이걸 ‘자기 조건화(self-conditioning)’라고 부릅니다. 그리고 이렇게 덧붙이는데요. 사람은 반대라고요. 사람은 하다 보면 익숙해져서 나아집니다.
이는 숫자로도 드러납니다. 첫 번째 하위 작업조차 끝내지 못하고 죽는 비율이, 짧은 작업에서는 1%인데 아주 긴 작업에서는 25%까지 뜁니다. 시작도 못 하고 무너지는 거죠.
다른 연구들도 비슷한 그림을 보여줍니다. 120스텝을 넘어가면 정확도가 0에 수렴하고, 난이도를 높인 변형에서는 15스텝 만에 붕괴합니다. 더 안타까운 결과도 있는데, 도구(웹 검색, 브라우저 제어 등)를 쥐여준 에이전트가 안 쥐여준 쪽보다 못한 경우가 있었습니다. 한 실험에서 25.0% 대 58.3%였고, 결정적인 건 에이전트가 맞힌 문제들이 비에이전트가 맞힌 문제들의 부분집합이었다는 겁니다. 비싼 값을 정당화할 고유 능력이 하나도 없었다는 뜻이에요.
여기서 “그럼 중간에 요약해서 이어가면 되지 않나” 싶으실 텐데요. 실제로 그렇게 합니다. 컴팩션이라고 부르고, 효과도 있습니다.
다만 요약할 때마다 조금씩 잃어버립니다. 반복해서 다시 쓸수록 짧아지고, 세부가 빠져나가고, 결국 쓸모 있던 지식까지 사라집니다.
그리고 더 곤란한 게 있습니다. 잘못된 판단이 요약에 한 번 섞여 들어가면, 확인할 원본이 없으니 그게 사실이 됩니다. 오류가 압축되면서 오히려 단단해지는 거죠.
그러니까 컴팩션은 문제를 없앤 게 아니라 다른 형태로 바꾼 것에 가깝습니다.
밖에 파일로 남기고, 다음 세션이 요약본이 아니라 원본을 읽고 시작해야 합니다. 대화 기록은 마모되지만 파일은 마모되지 않으니까요.
그래서 구글이 6월 12일에 이걸 표준으로 만들었습니다. Open Knowledge Format(OKF)입니다.
구조는 놀랄 만큼 단순합니다. 개념 하나하나들을 마크다운(md) 파일로 저장되고, 폴더가 통째로 개념들을 저장을 저장한 경로로써 존재합니다. 마크다운 파일 위에 YAML 몇 줄로 종류, 제목, 설명, 태그, 시각을 적습니다. 파일끼리는 그냥 마크다운 링크로 잇고, 그게 쌓여서 그래프가 됩니다.
다시 정리해, 기존에 소스코드가 있으면, 동일하게 경로를 구성해 어떤 폴더, 파일이 어떤 역할을 하는지 등을 요약해두는 방식을 OKF라고 규격을 만든 겁니다.
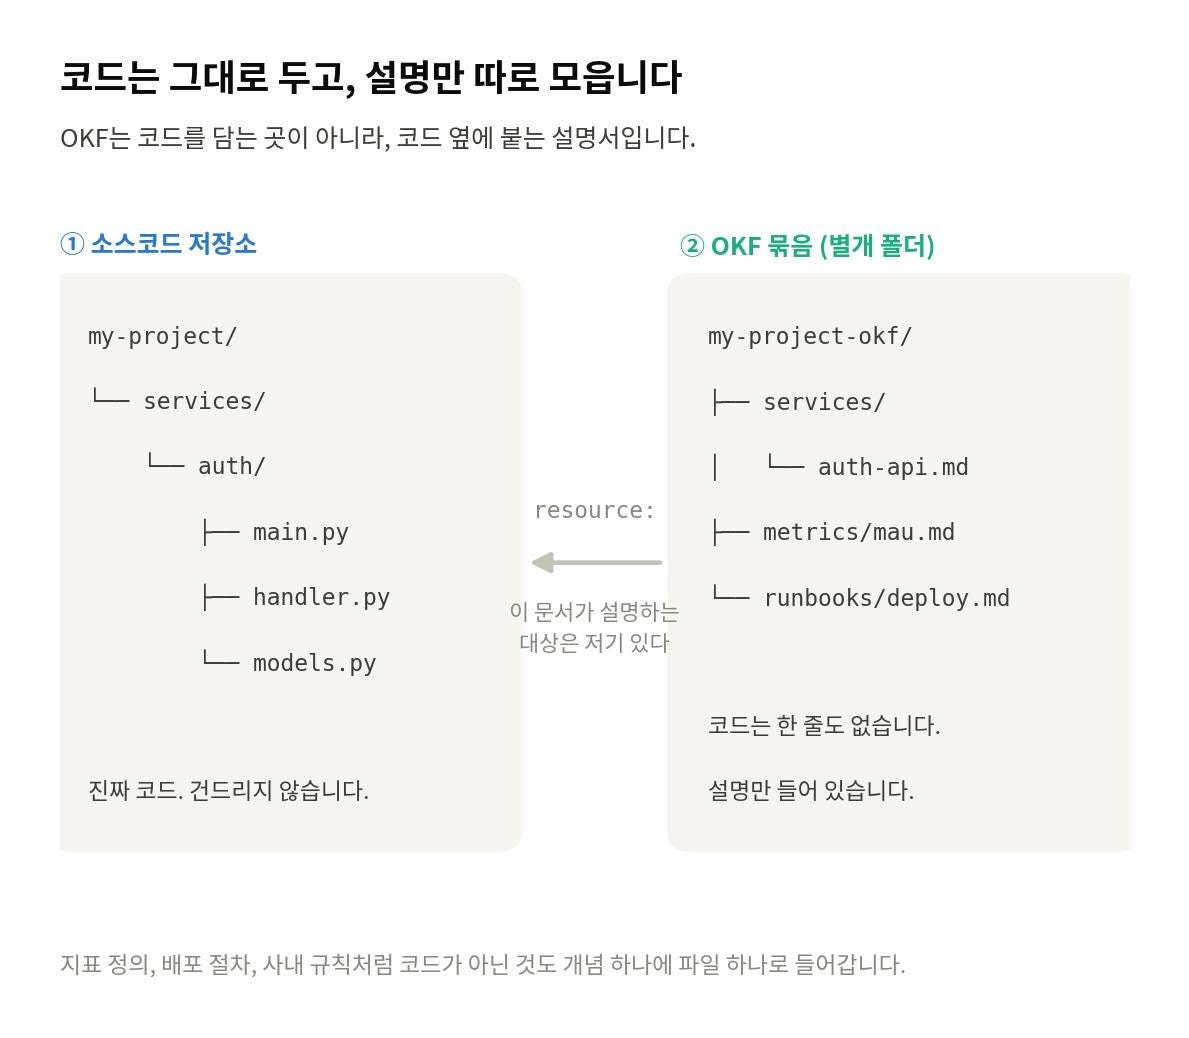
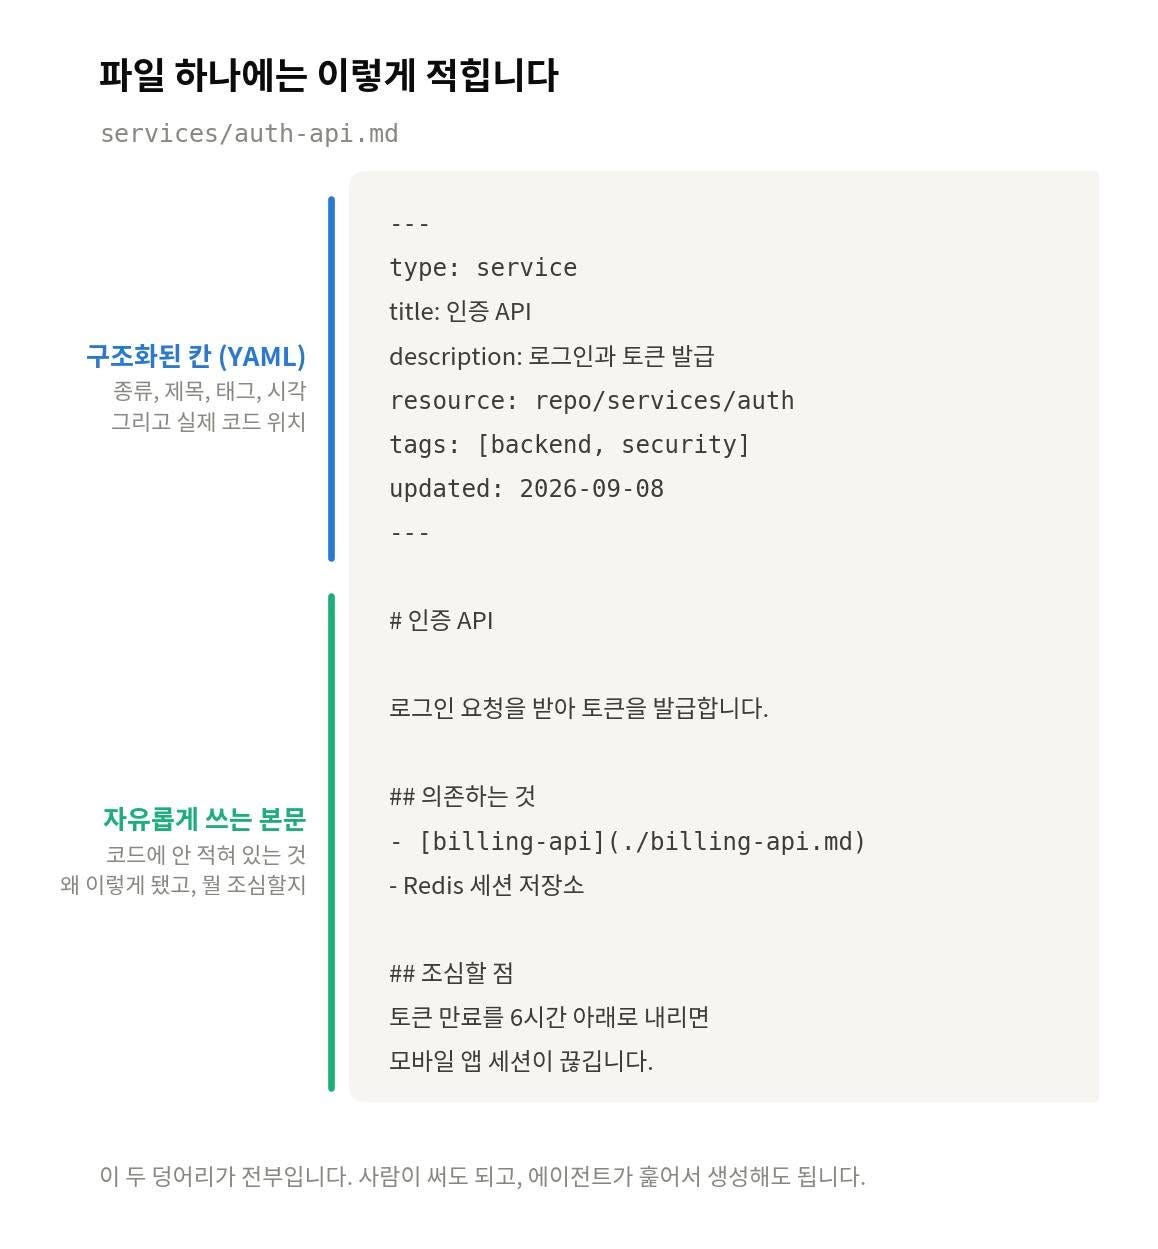
구글이 발표문에 쓴 문장이 인상적이었는데요. “부족한 건 또 하나의 서비스가 아니라 포맷”이라는 겁니다. 실제로 OKF는 어떤 설치해야 하는 스킬이라던가, 서버처럼 돌아가는 런타임도 아니고, 검색 인덱스, 모델도 아닙니다. 굉장히 가벼우면서도 강력하게 에이전트들이 힘을 발휘할 수 있도록 만들어주는 체계입니다.
노션 내부에서도 최근 에이전트 기능을 대폭 강화시키며 인터뷰에서 말하길, “오직 사용자가 요청한 지시 그 자체가 컨텍스트로 시작한다”라고 말하더군요. 서브 에이전트들을 새로 띄우는 원리와 비슷하다고 하는데, 앞에서 다룬 문제를 고민한 흔적이라 볼 수 있습니다.
저희 AXIT 플랫폼에서도 프로젝트 단위로 진행하는 작업들이 워낙 길어지다보니, 작업 내용을 OKF 포맷으로 계속 정리하도록 하고 있는데요. 최대한 적은 컨텍스트를 유지하고 언제든지 사람이 수정할 수 있는 구조를 채택하게 되었습니다.
마지막으로, 앞서 논문에는 이런 대목이 있습니다. 스텝당 정확도가 조금만 올라도 완수 가능한 작업 길이는 지수적으로 늘어난다는 것.
벤치마크에서 1~2%p 오르는 게 지루해 보여도, 체감으로는 몇 배로 오는 이유입니다. 실제로 프론티어 모델이 절반의 확률로 해내는 작업 길이는 지난 6년간 7개월마다 두 배씩 늘었습니다. 2025년에는 55분이었고, 2027년쯤 4시간에 도달할 전망이라고 하네요.
그때까지는, 컨텍스트 관리를 신경쓰며 작업하는 걸 추천드립니다. 동시에, 소비자들의 신경을 최대한 덜고자 하는 앤트로픽, OpenAI 같은 회사들은 이런 좋은 시도들을 모델 단에서 적용할 수 있도록 노력해줄 것으로 기대됩니다.
#AI #Agent #LLM #OKF #OpenKnowledgeFormat #Google #ClaudeCode #AXIT
「신뢰성 측정」 https://arxiv.org/abs/2603.29231 (Beyond pass@1: A Reliability Science Framework for Long-Horizon LLM Agents)
「장기 실행 측정; ‘자기 조건화’」 https://arxiv.org/abs/2509.09677 (Measuring Long Horizon Execution in LLMs)
「LORE 벤치마크」 https://openreview.net/pdf?id=dAn82lpLx4 (The Agent’s Marathon (LORE: Long-horizon Reasoning Evaluation))
「Less Is More」 https://arxiv.org/abs/2604.21746 (Less Is More: Measuring How LLM Involvement affects Chatbot Accuracy in Static Analysis)
「ACE」 https://arxiv.org/abs/2510.04618 (Agentic Context Engineering)
「OKF 명세와 발표문」 https://cloud.google.com/.../how-the-open-knowledge...