
에이전트를 여러 개 띄우면 정말 더 좋을까
송찬우 5분 분량
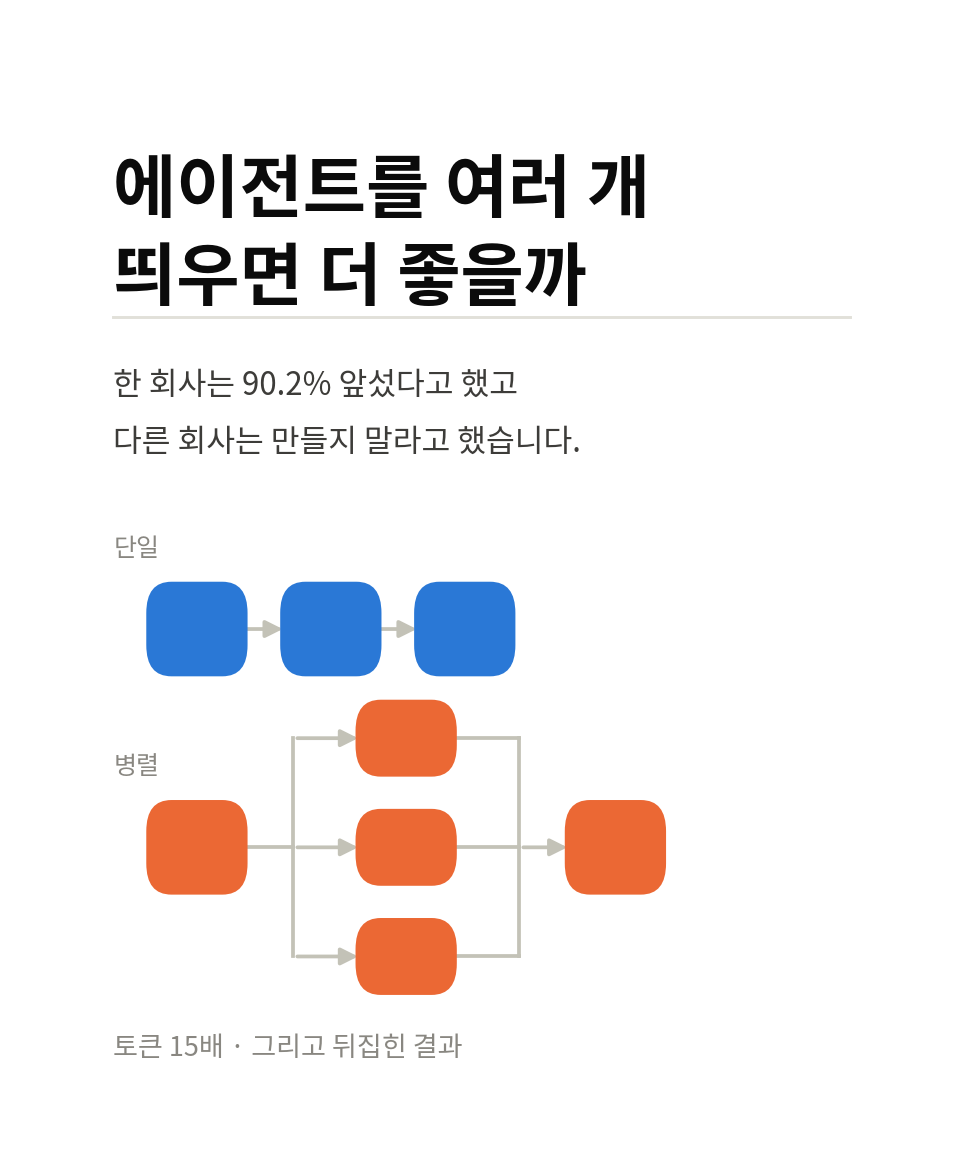
요즘 Claude Code나 Codex를 쓰다 보면, ‘Ultra’ 또는 ‘Ultracode’ 라는 effort(추론 수준)로 작업할 경우, 에이전트가 능동적으로 서브 에이전트들을 띄워 작업을 병렬적으로 진행합니다. 그런데 문득 궁금해졌습니다. 이거 진짜 더 좋은 걸까, 아니면 그냥 여러 개 띄우니까 뭐라도 되는 것처럼 보이는 걸까.
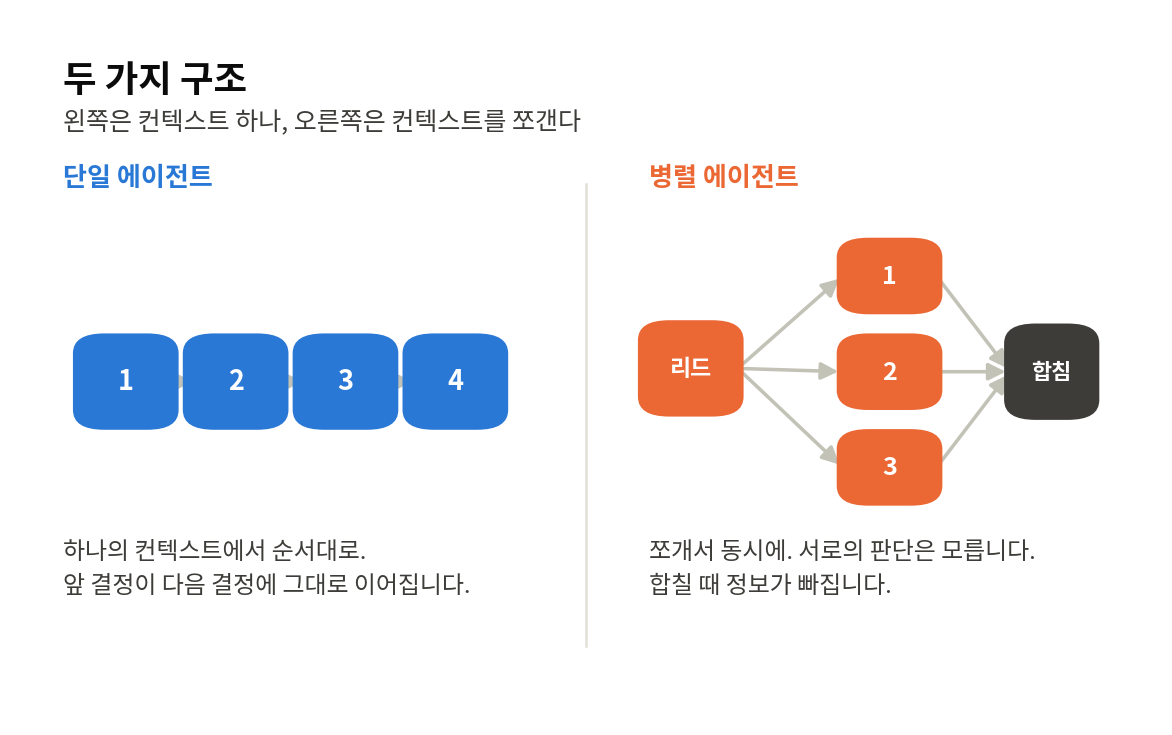
입장에 따라 업계에서는 의견이 나뉘는 것 같더라구요.
작년에 Anthropic이 멀티 에이전트 리서치 시스템을 공개했습니다. Lead 에이전트가 하위 에이전트 서너 개를 병렬로 띄우고 결과를 합치는 구조인데, 자체 평가에서 단일 에이전트보다 90.2% 앞섰다고 밝혔습니다.
같은 해 6월, Cognition (Devin이라는 에이전트 모델 개발사)은 정반대 제목의 글을 냈습니다. “멀티 에이전트를 만들지 마라.” 단일 스레드로만 가고 컨텍스트 압축은 별도 모델에 맡기라는 입장이었어요.
여기까지는 그냥 의견 차이로 보였는데, 두 가지생각에 집중해야 합니다.
첫째, Anthropic의 글 안에서도 단점이 같이 언급되어 있었습니다.
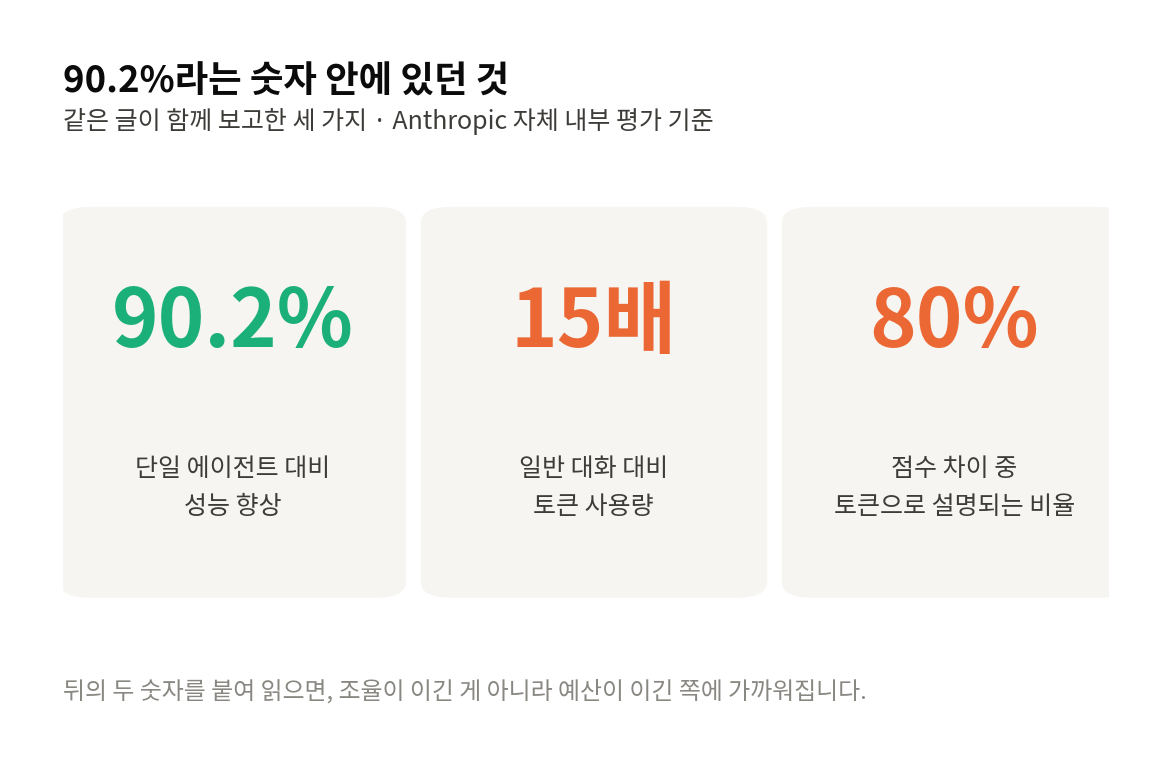
같은 글에서 두 가지 단점을 더 언급하는데요. 그 시스템이 일반 대화의 약 15배 토큰을 썼다는 것. 그리고 토큰 사용량만으로 점수 차이의 약 80%가 설명된다는 것.
이 이야기를 듣고 나면, 단순히 AI 모델의 성능이 뛰어나 조율이 똑똑해서 이긴 게 아니라, 돈을 다섯 배 더 쓴 쪽이 이긴 것에 가까워집니다.. 에이전트 다섯 개로 펼친다는 건 곧 추론 예산을 다섯 배 쓴다는 뜻이기도 하니까요.
올해 4월에 이걸 검증한 논문이 나왔습니다. 지적이 단순합니다. 그동안의 비교가 공정하지 않았다는 거예요.
멀티 에이전트가 이겼다는 실험들을 보면, 멀티 쪽이 생각하는 데 쓴 양이 단일 쪽보다 훨씬 많았습니다. 당연히 각자 컨텍스트가 적은 채로 유지되고, 단순히 에이전트 수만 보더라도 더 좋은 결과물이 나올 가능성이 훨씬 높죠.
그래서 양쪽에 똑같은 양의 생각만 허락하고 다시 재봤습니다. Qwen3, DeepSeek-R1, Gemini 2.5로요. 결과는 단일 에이전트가 따라잡거나 이겼습니다.
왜 그런지도 설명이 있는데, 복사기를 떠올리면 쉽습니다. 원본을 복사하고, 그 복사본을 또 복사하면 어떻게 될까요. 아무리 좋은 복사기를 써도 원본보다 선명해지지는 않습니다. 조금씩 흐려질 뿐이죠.
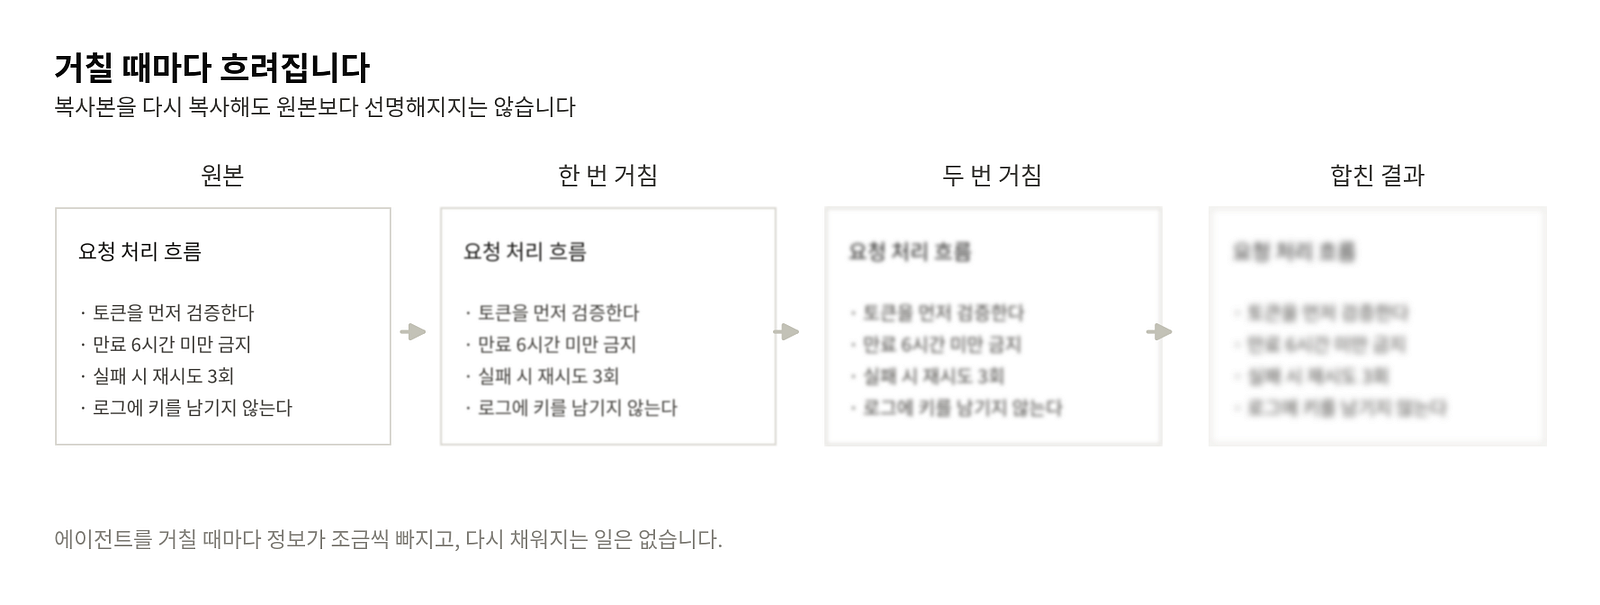
정보도 똑같습니다. 에이전트 A가 읽고 정리해서 B에게 넘기면, B가 받는 건 원본이 아니라 A의 정리본입니다. 거칠 때마다 조금씩 빠져나가고, 다시 채워지는 일은 없습니다.
병렬화를 “여러 눈으로 넓게 본다”고 생각했는데, 실은 하나를 여러 조각으로 나눠 각자 흐리게 보는 것에 가까웠습니다.
둘째, 1년 지나고 보니 양쪽이 같은 자리로 왔습니다.
그런데 4월에 후속 글을 직접 냈습니다. 입장을 뒤집은 게 아니라 조건을 더 좁힌 글이었습니다. 여러 에이전트가 동시에 코드를 쓰는 구조는 여전히 안 된다고 했으나, 쓰는 주체는 하나고 판단만 나눈 좁은 경우뿐이라고요.
Anthropic도 같은 기간 반대 방향으로 움직였습니다. 넓게 펼치는 병렬에서 역할이 좁게 정해진 하위 에이전트 쪽으로요. OpenAI는 4월에 에이전트끼리 대화 기록을 넘기는 걸 아예 기본으로 꺼버렸습니다. 서로 컨텍스트가 새어 들어가는 걸 줄이려고요.
그래서 지금 남은 패턴은 하나입니다. 에이전트 하나가 전체 맥락을 쥐고, 독립적인 곁가지 작업만 떼어 던지고, 요약만 돌려받는 것. 하위 에이전트끼리 직접 얘기하게 두지 않고, 공유하는 상태도 만들지 않습니다.
Claude Code의 Task 도구도, OpenAI의 방식도, Cognition의 새 기능도 전부 이 모양입니다. 1년 전의 그 시끄러웠던 논쟁이 사실상 정리된 셈이죠.
Latent Space 팟캐스트에서 나온 얘기가 인상적이었습니다. Devin에게 다른 Devin을 마음대로 만들고 서로 메시지를 보낼 수 있게 해봤답니다. 결과는 “정말 혼돈스러운 세상”이었고, 결국 일상적으로 제일 쓸모 있는 건 Devin 하나였다고 하네요.
Microsoft의 Azure SRE 팀 사례도 같은 방향입니다. 멀티 에이전트 전문화 쪽으로 가다가 인수인계 자체가 신뢰성을 떨어뜨린다는 걸 발견하고 되돌렸습니다.
그래서 판단 기준이 이렇게 정리됐습니다.
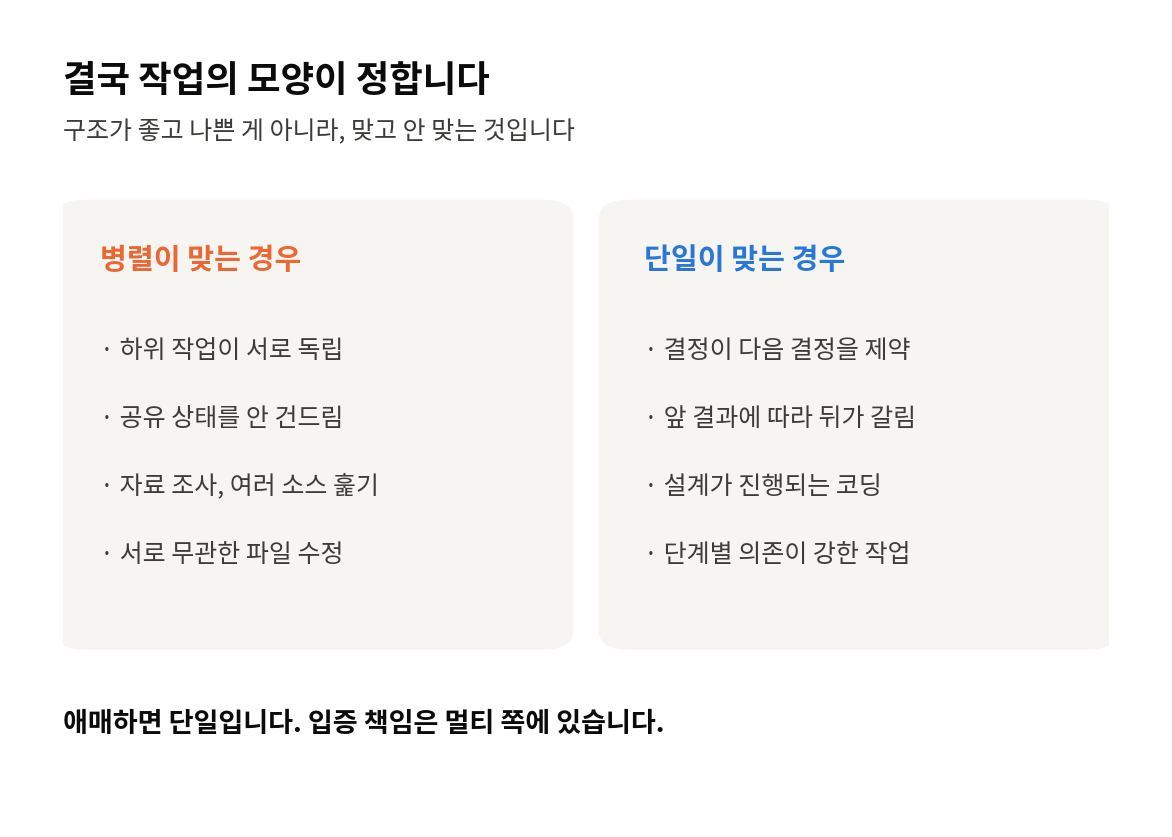
하위 작업이 서로 독립이고 공유 상태를 안 건드리면 병렬이 맞습니다. 자료 조사, 여러 소스 훑기, 서로 무관한 파일 여러 개 고치기 같은 것들이요.
결정이 서로를 제약하면 단일이 맞습니다. 설계가 진행되면서 계속 갈리는 작업, 앞 단계 결과에 따라 다음이 달라지는 작업이요.
애매하면 단일 에이전트를 추천드립니다. 현재로서는 OKF와 같은 자료를 잘 요약하는 포맷을 탐색하고, 작업 단위로 세션을 새로 불러와 진행하는 것이 효율적인 것처럼 보이네요.
지난번 글에서 에이전트가 긴 작업을 못 버티는 이유를 다뤘는데요. 병렬화는 그 문제를 컨텍스트를 쪼개서 푸는 시도입니다. 다만 쪼갠 걸 다시 합칠 때 정보를 잃습니다. 같은 문제의 다른 해법인데, 공짜인 해법은 아니었네요.
#AI #Agent #LLM #ClaudeCode #MultiAgent