
Deepseek-V4.1-Flash, 더 작지만 강력한 모델
송찬우 4분 분량
지난주(9/10) DeepSeek이 새 모델을 냈습니다. V4.1 Flash인데요.
9월 14일부터 V4-Pro를 호출하면 전부 이 Flash 모델로 넘어갑니다. 요금도 Flash 기준으로요.
이름부터 “작은 모델”인데 그게 플래그십을 밀어낸 겁니다.
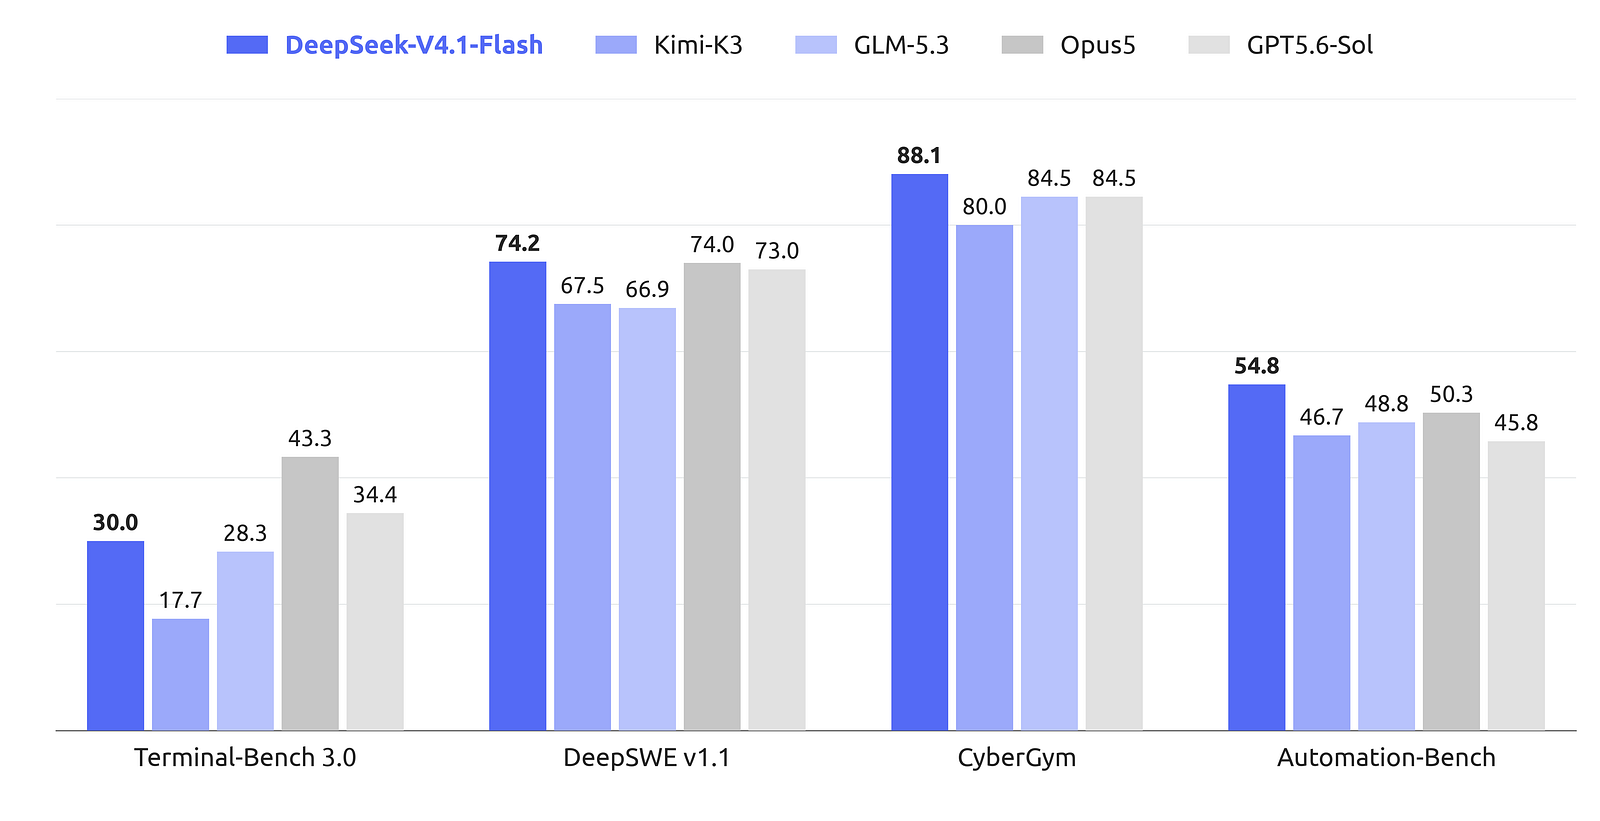
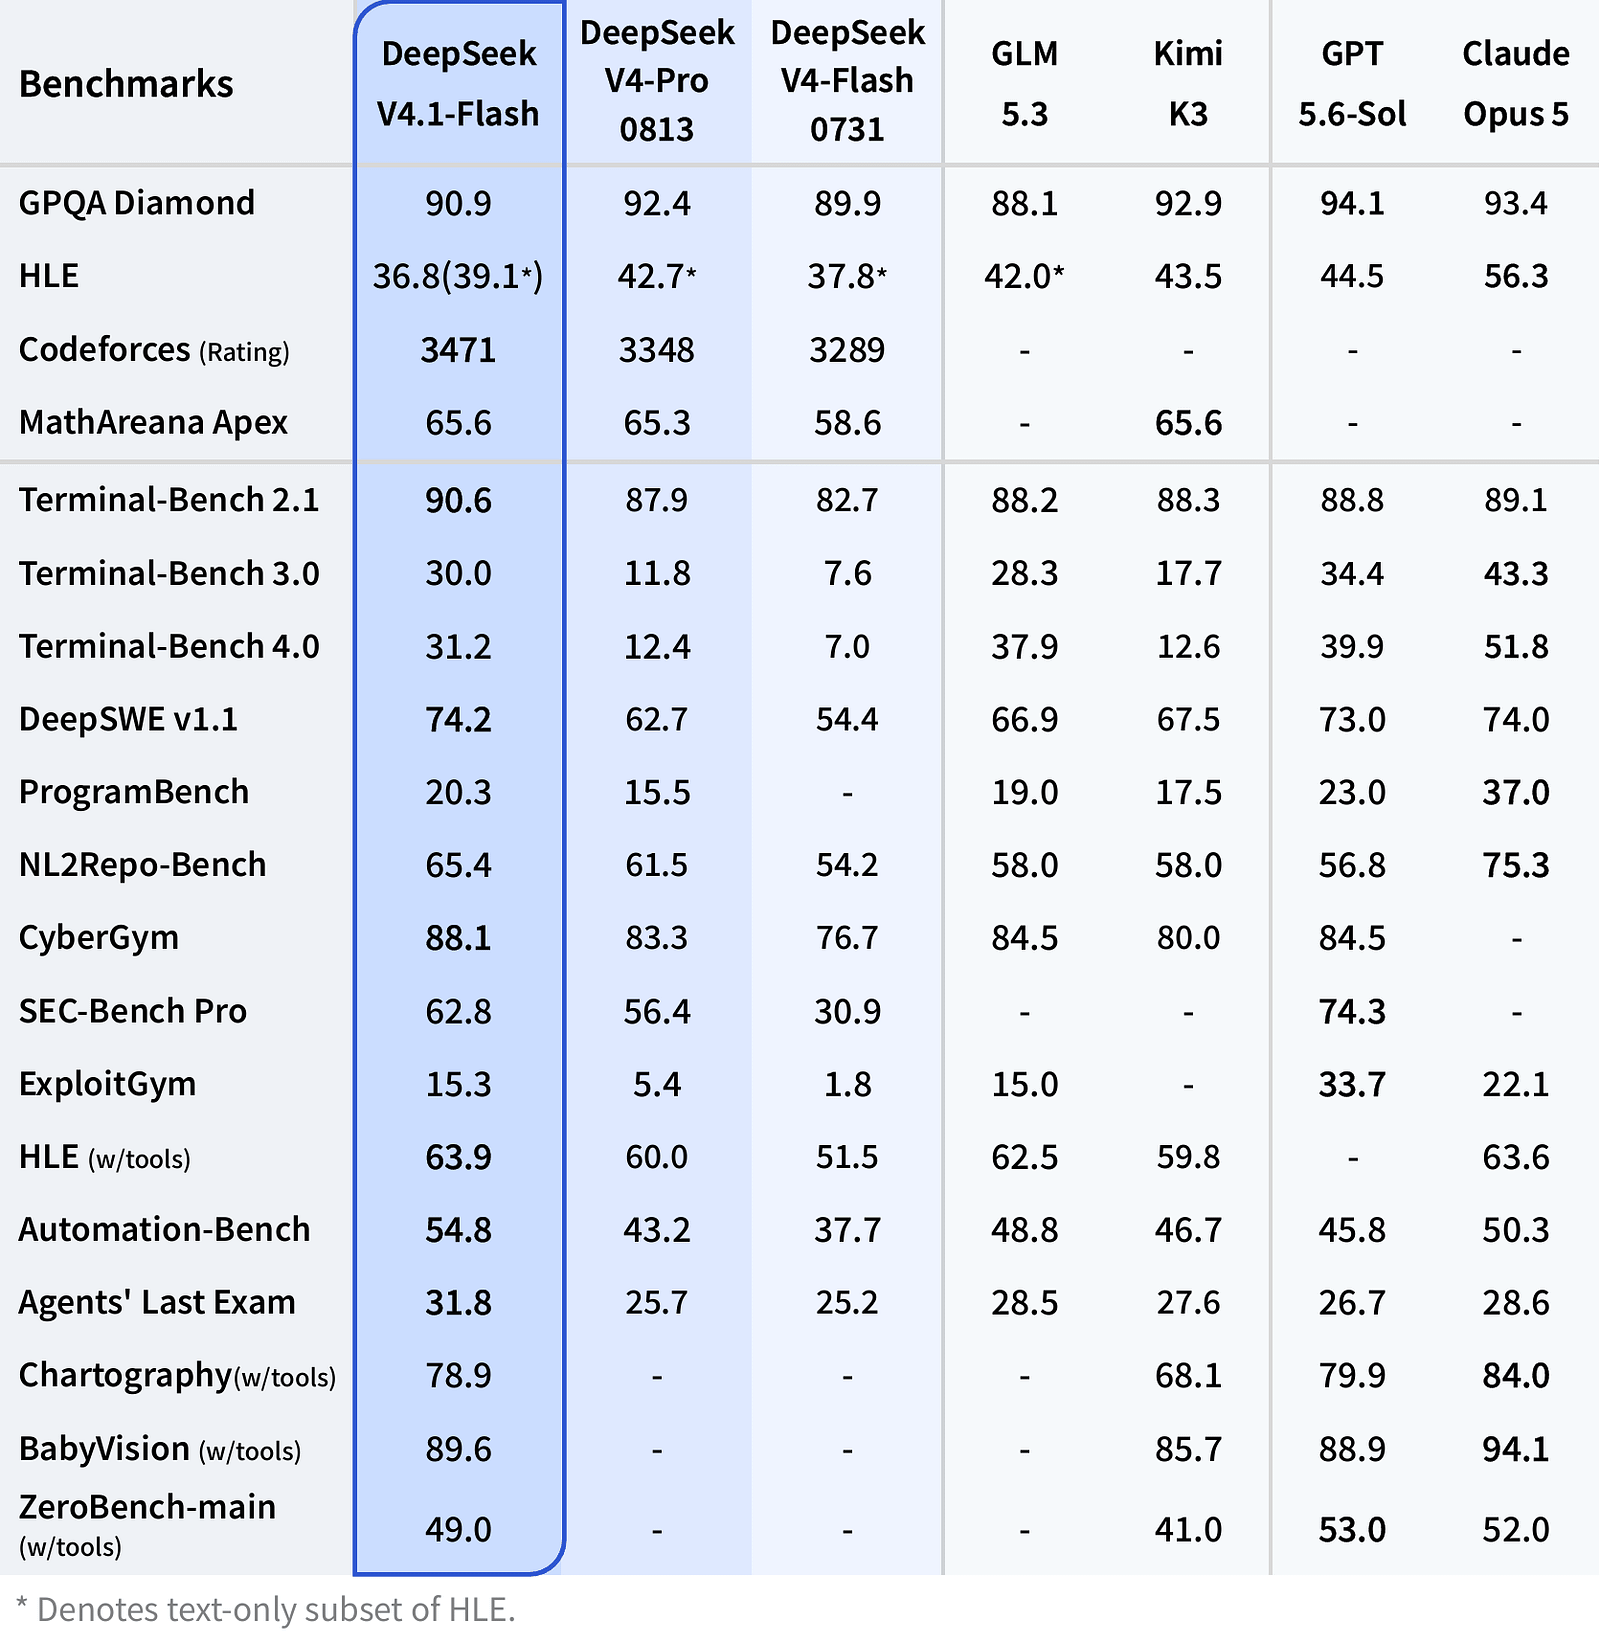
숫자를 보니 이유를 알겠더군요.
552B짜리 모델인데, 실제로 도는 건 8B입니다.
정확히는 이렇습니다. 우리가 넣은 질문을 읽을 때는 8B, 답을 쓸 때는 16B를 씁니다. 나머지는 그냥 잠들어 있어요. 전문가를 잔뜩 모아두고 매번 필요한 몇 명만 깨우는 방식입니다.
그런데 읽을 때와 쓸 때 다르게 쓴다는 게 이번의 핵심입니다.
생각해보면 말이 됩니다. 긴 문서를 읽는 일과 답을 지어내는 일은 난이도가 다르거든요. 읽는 건 훑으면 되지만 쓰는 건 머리를 써야 하니까요. 그래서 읽는 쪽은 싸게, 쓰는 쪽은 두 배로 배분한 겁니다.
그리고 싸고 효율적인 이유가 따로 있었습니다.
토큰 하나당 890바이트.
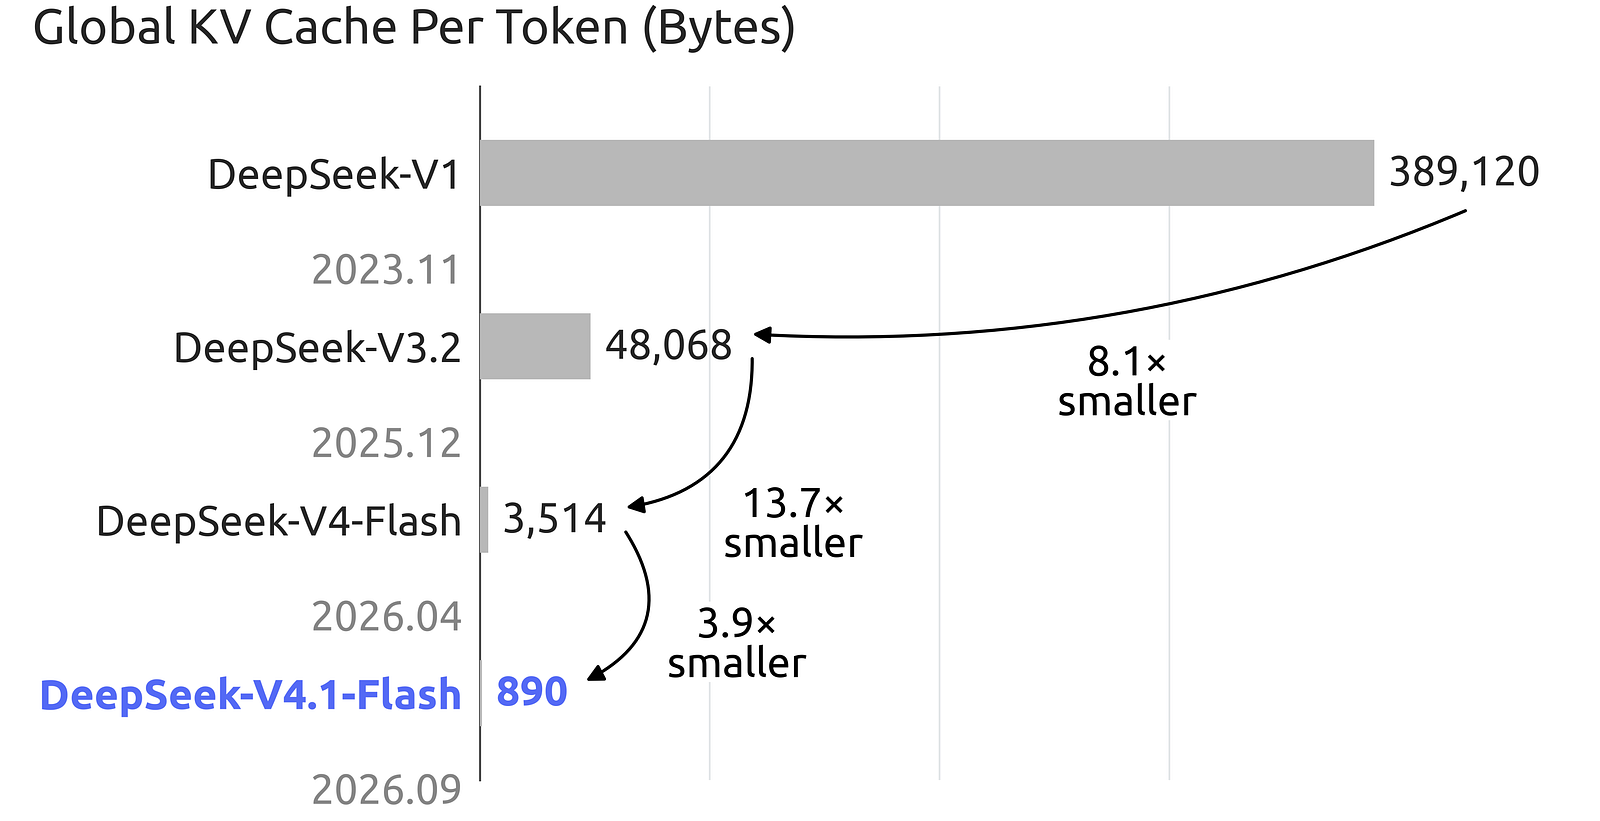
이게 무슨 말이냐면요. AI는 대화가 길어질 때 앞부분을 매번 다시 읽지 않습니다. 읽어둔 걸 메모로 저장해두고 그걸 참고해요. 문제는 대화가 길어질수록 이 메모가 계속 커진다는 겁니다. 그리고 그 메모를 들고 있는 비용이 곧 요금이 됩니다.
에이전트를 오래 돌릴 때 돈이 많이 드는 이유가 여기 있었던 거죠.
V4.1 Flash는 이 메모를 직전 세대의 4분의 1로 줄였습니다. 디스크에 오래 보관하는 쪽은 8분의 1이고요. DeepSeek은 이게 가격을 내릴 수 있었던 이유라고 밝혔습니다.
실제로 가격이 이렇게 됐습니다.
한 번 읽은 내용을 다시 쓸 때 100만 토큰당 0.003달러, 처음 읽는 내용은 0.15달러, 답을 쓰는 건 0.60달러입니다. 위안화 기준으로 직전 모델보다 각각 60%, 33%, 11% 내렸다고 하고요.
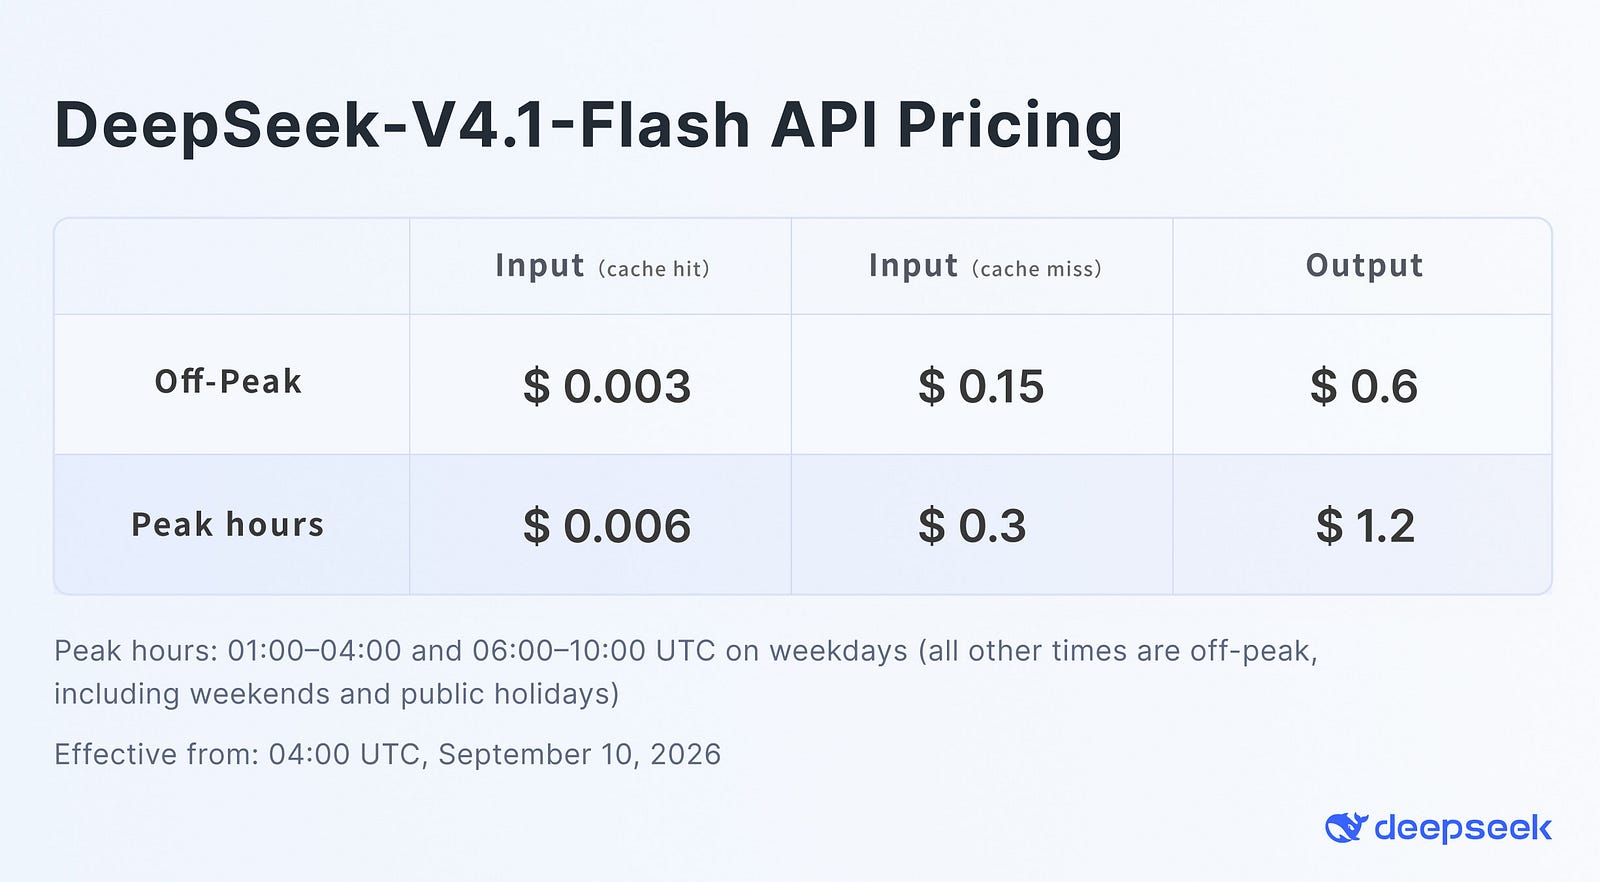
첫 번째 숫자가 중요합니다. 에이전트는 같은 맥락을 계속 반복해서 읽거든요. 그 비용이 전체에서 큰 몫을 차지하는데, 메모를 줄였더니 거기가 확 떨어진 겁니다.
나머지 사양도 정리하면 이렇습니다. 컨텍스트는 100만 토큰, 이미지도 바로 이해하고, 45조 토큰으로 처음부터 새로 학습시켰습니다. 그리고 가중치가 MIT 라이선스로 공개돼 있습니다. 상업적으로 자유롭게 쓸 수 있다는 뜻이죠.
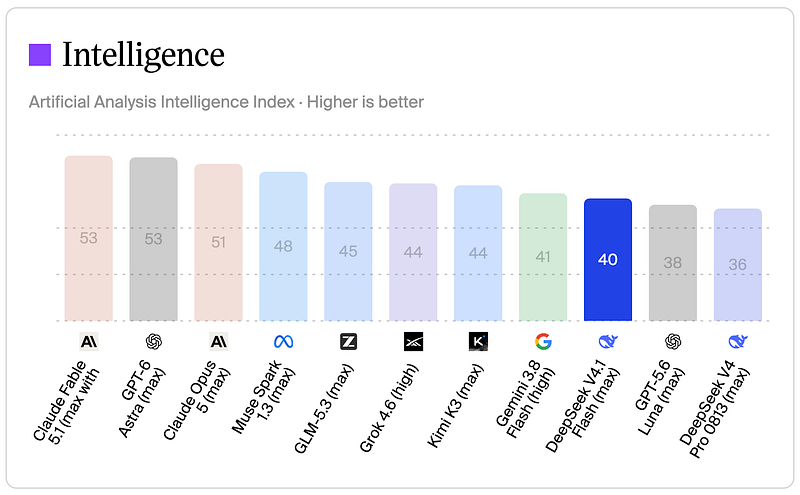
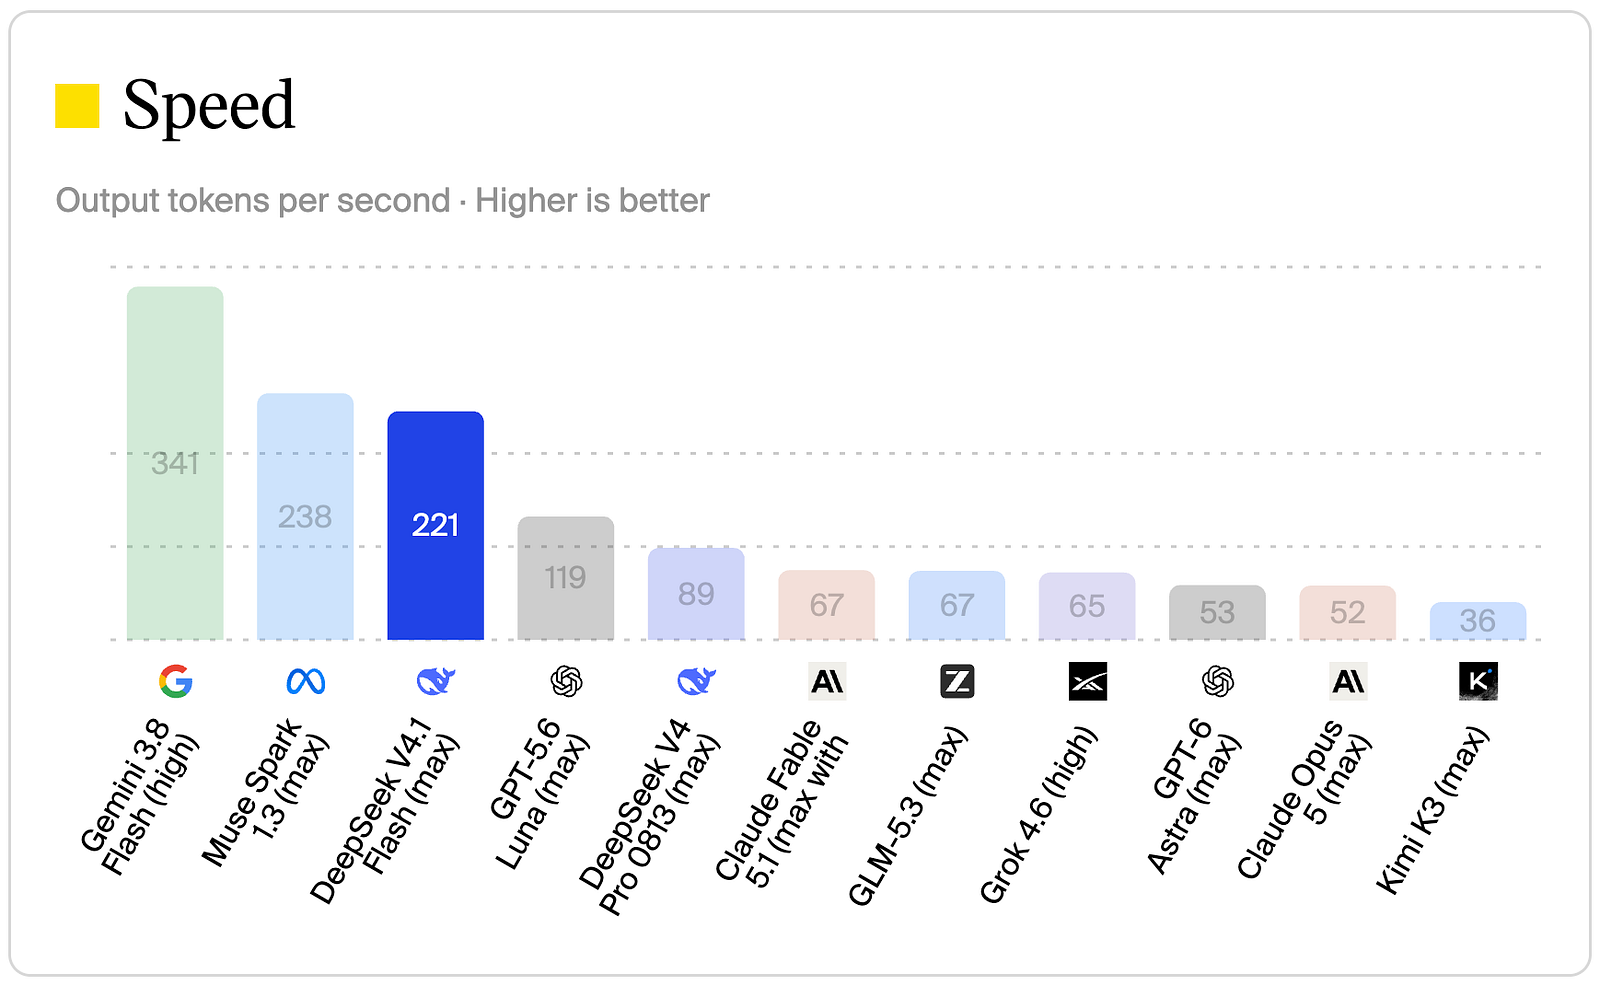
Artificial Analysis에서도 지능 지수는 40점을 받았고, 출력 속도도 초당 221 토큰으로 기존 V4 Pro보다 약 2.4배 높은 수준입니다.
전에 “데이터가 다 떨어졌는데 AI는 왜 계속 좋아지나”를 다룬 적이 있는데요. 그때 답이 “새 데이터가 아니라 학습 환경”이었잖아요.
이번 건 또 다른 답입니다. 모델을 키운 게 아니라 구조를 바꿨습니다.
읽을 때와 쓸 때 쓰는 양을 다르게 하고, 기억해둘 메모를 압축하고, 그래서 같은 돈으로 더 오래 굴릴 수 있게 만든 것. 성능 경쟁이 아니라 운영 비용 경쟁으로 무게가 옮겨간 느낌입니다.
에이전트를 오래 돌리는 게 당연해진 시대라 그런 것 같기도 하고요.
작은 모델이 자기네 플래그십을 은퇴시킨 게 그 증거인 것 같습니다.