
Google이 예고한 재귀개선 AI
송찬우 6분 분량
지난 12일, AI 유출 정보를 올리는 X 계정 라이라(@lyraxana)가 구글 딥마인드 공식 계정을 태그하며 짧은 글을 올렸습니다.
“huge RegratulationS Indeed!”
대문자만 뽑으면 R, S, I가 됩니다. 재귀적 자기개선(Recursive Self-Improvement)이죠.
커뮤니티가 뒤집혔습니다. 곧이어 Lentils80(@Lentils80)이라는 X 뉴스 계정이 화면 캡처를 하나 올렸는데요. 개발자가 구글 AI를 가져다 쓸 때 “지금 쓸 수 있는 모델 목록 (카탈로그)”을 확인하는 화면이 있습니다. 거기에 아직 세상에 공개된 적 없는 이름이 하나 끼어 있었다는 겁니다. ‘rsi-model’로 시작하는 코드명이었고요.
배경이 받쳐준 탓도 큽니다. 지난달 로이터 보도로 구글이 1,000명 넘는 인력을 AI 자체 개선과 차세대 제미나이에 투입 중이라는 게 알려졌고, 공동창업자 세르게이 브린이 4월 전 직원 회의에서 모든 자원을 RSI에 집중하라고 촉구했다고 전해졌거든요.
그리고 이틀 뒤인 14일, 구글이 진짜로 논문을 냈습니다.
이름은 Dream-RSI입니다. 구글과 구글 딥마인드, 메릴랜드대, 버지니아대가 함께 냈고, 부제가 ‘세계 진화를 통한 재귀적 자기개선’입니다.
미리 말씀드리면, 유출설의 그 모델과 이 논문이 같은 것이라는 근거는 없습니다. 저 캡처도 검증된 게 아니고요.
발상이 이렇습니다.
AI가 어려운 문제를 풀 때는 여러 경로를 시도합니다. 이 방법으로 가보고, 안 되면 저 방법으로 가보고요. 당연히 스크립트 등을 활용해 가설 검증이 되지 않는다면 버립니다. 조건에 맞는 가설, 데이터가 있다면 그것을 집중적으로 파고요.
Dream-RSI는 그 버려지는 기록을 안 버립니다. 성공한 경로와 실패한 경로를 전부 나무 모양으로 저장해두고, 그걸 가상 실험실처럼 재활용합니다.
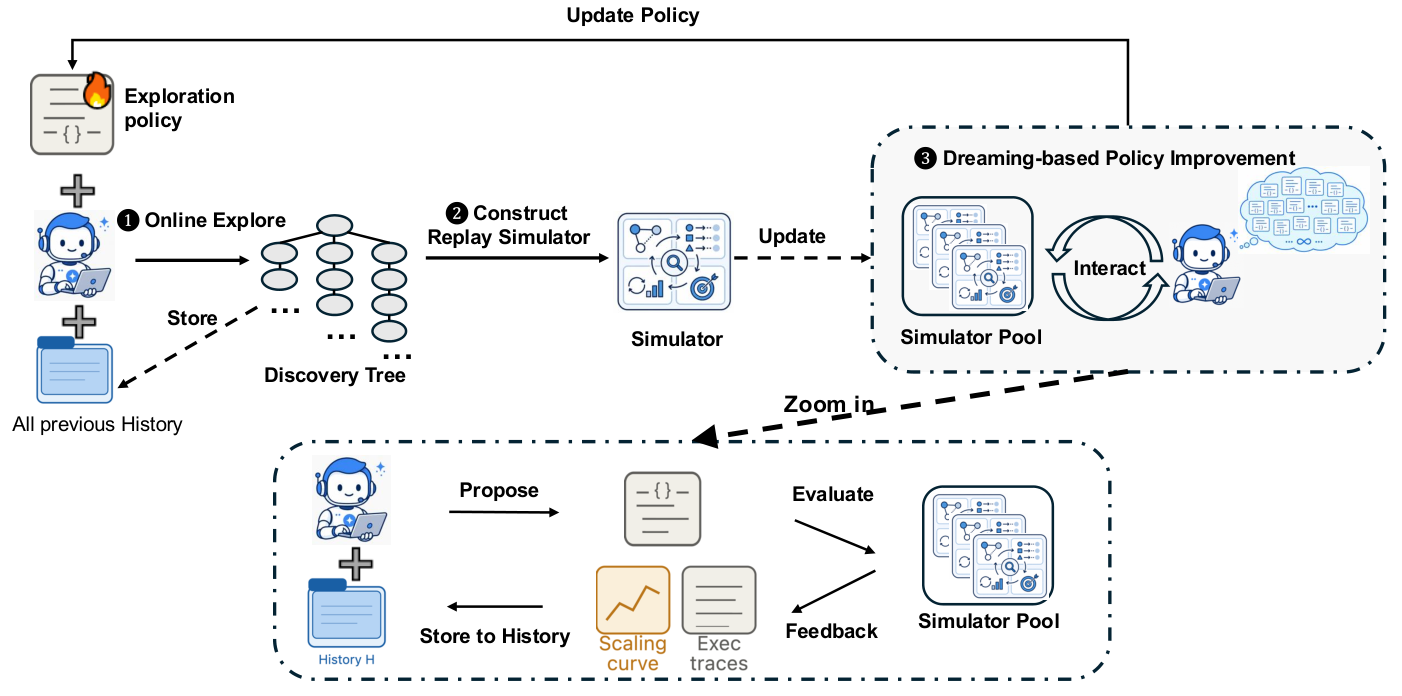
그러면 이런 게 가능해집니다. “어떤 경로를 먼저 가볼까”, “몇 개를 동시에 해볼까”, “언제 포기하고 다른 길로 갈까” 같은 전략을 수천 가지 시험해보는데, 모델을 다시 돌리지 않습니다. 이미 기록해둔 결과를 보고 판단하니까요.
그중 제일 효율적인 전략을 골라 실제 문제에 적용하고, 거기서 새로 쌓인 기록을 다시 실험실에 넣습니다. 이걸 반복하면서 탐색 방식 자체가 계속 좋아집니다.
여기서 중요한 구분이 하나 있습니다.
이름이 ‘자기개선’이라 AI가 스스로를 뜯어고치는 그림이 떠오르는데, 그게 아닙니다.
모델의 가중치는 건드리지 않습니다. 기초 모델도 그대로, 채점하는 평가 시스템도 그대로예요. 고치는 건 “어디를 먼저 찾아보고 언제 멈출지”를 결정하는 코드 한 겹입니다.
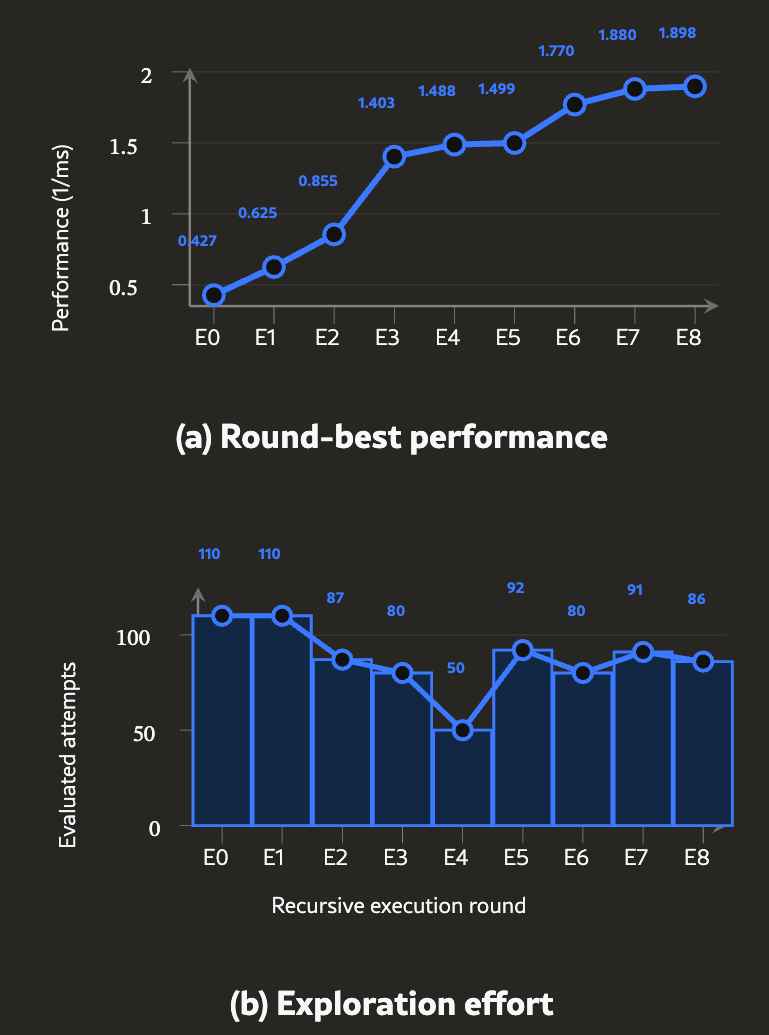
위는 성능, 아래는 그 성능을 내려고 시도한 횟수입니다. 성능이 오르는 동안 시도 횟수는 110에서 50까지 줄었습니다. 그러다 성능이 정체되자(E4~E5) 다시 시도를 늘립니다. 아무도 이렇게 하라고 안 가르쳤는데 스스로 찾아낸 패턴입니다.
비유하면 요리사가 바뀌는 게 아니라 레시피를 찾는 방법이 바뀌는 겁니다. 실력은 그대로인데 헤매는 시간이 줄어드는 거죠.
숫자로 보면 이렇습니다.
알고리즘 설계, 수학 최적화, GPU 코드 최적화 등 8개 과제에서 시험했는데요.
알고리즘 설계에서는 기존 방식 대비 AI를 부르는 횟수를 최대 162분의 1로 줄였습니다. 같은 모델과 조건을 쓴 고정 탐색과 비교해도 1.7배 적은 호출로 같은 결과를 냈고요.
GPU 코드 쪽에서는 비슷한 성능을 내는 데 필요한 시도를 1.79~2.43배 줄이거나, 같은 예산에서 성능을 최대 2.09배 높였습니다.
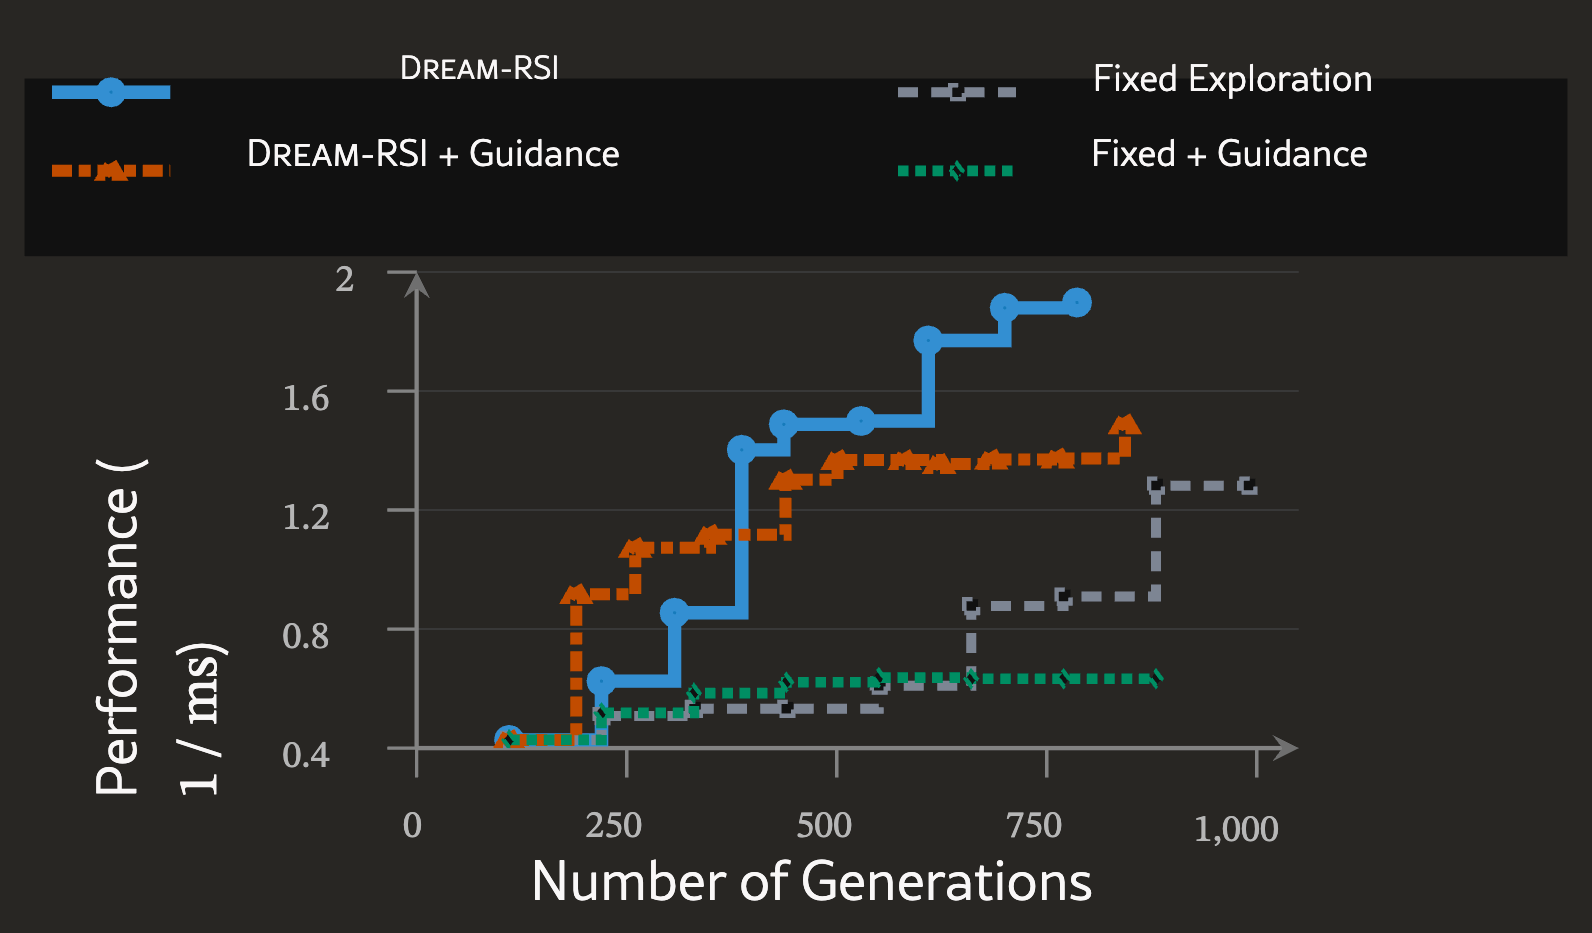
재밌는 결과도 있습니다. Dream-RSI 모델에 “이런 방향으로 찾아봐”라며 힌트를 주면 오히려 성능이 떨어진다는 점입니다.
이게 왜 중요하냐면, 요즘 경쟁이 그쪽으로 옮겨가고 있어서입니다.
구글 딥마인드는 이미 AlphaEvolve가 만든 데이터센터 스케줄링 알고리즘으로 전 세계 구글 컴퓨팅 자원의 0.7%를 추가 확보했다고 밝혔습니다. 제미나이에 쓰이는 핵심 연산을 23% 빠르게 만들어 전체 학습 시간을 1% 줄이기도 했고요. 사람이 몇 주씩 하던 GPU 최적화 작업은 며칠로 줄었습니다.
퍼센트가 작아 보이지만 구글 규모에서 0.7%는 엄청난 숫자입니다.
예전에 쓴 글이 여기서 이어집니다.
“데이터는 다 떨어졌는데 AI는 왜 더 좋아질까”에서, 답이 새 데이터가 아니라 모델이 굴러다니며 배울 환경을 늘리는 것이라고 정리했었죠.
Dream-RSI는 거기서 한 칸 더 갑니다. 환경을 자기가 실패한 기록으로 만듭니다. 논문 제목의 ‘세계 진화’가 그 뜻이고요. 헛수고가 자산이 되는 구조입니다.
다만 말을 조심해서 써야 할 것 같습니다.
대문자 세 개짜리 트윗에 커뮤니티가 뒤집힌 게 그 증거이기도 한데요. RSI라는 용어가 지금 좀 남용되고 있습니다. 개념이 명확히 정의되지 않은 채로, 기술력을 자랑하려는 쪽이나 AI가 너무 빠르다고 경고하려는 쪽이나 각자 입맛에 맞게 쓰고 있다는 지적이 있어요.
사실 ‘AGI’도 그렇죠. 다들 쓰는데 정작 무엇을 가리키는지는 말하는 사람마다 다릅니다. 단어가 커질수록 각자 원하는 그림을 거기 얹게 되는 것 같아요.
7월에 나온 서베이 논문이 이걸 정리했는데, 2024년부터 2026년까지 arXiv 논문 1,250편을 훑어서 두 가지를 갈랐습니다. 하나는 결과가 수렴하고 평가가 가능한 실무적 개선이고, 다른 하나는 끝이 열려 있는 진짜 RSI인데요. 후자는 측정한 모든 축에서 여전히 한계에 묶여 있다고 결론 냈습니다.
Dream-RSI는 분명히 앞쪽입니다. 가중치도 안 바뀌고, 평가 시스템도 고정이고, 개선되는 건 탐색 코드 한 겹이니까요.
그러니 “AI가 사람 없이 스스로 진화하기 시작했다”로 읽으면 과합니다. 정확히는 “AI가 자기 연구 방식을 고쳐서 비용을 줄이기 시작했다” 쪽이죠.
그래도 이게 작은 얘기는 아닙니다. 지금 AI 개발에서 제일 비싼 게 컴퓨팅 자원인데, 같은 자원으로 더 많이 시도할 수 있게 되는 거니까요.
그리고 무엇보다, 실패한 기록을 버리지 않는다는 발상이 오래 남네요. 사람이 일하는 방식에도 그대로 적용되는 얘기라서요.
#AI #구글 #딥마인드 #RSI #재귀적자기개선