
대한민국 대학생 2명이 만들어버린 가장 빠른 TTS/STT 모델
송찬우 7분 분량
지난주 음성 AI 벤치마크에서 Nari Labs라는 이름의 한국 스타트업이 등장하였습니다.
음성 AI 성능을 실시간으로 비교하는 Coval 벤치마크에서, 9월 14일 기준 음성을 글자로 바꾸는 부문(STT) 속도 1위에 올랐습니다. 상대는 Deepgram, Soniox, Inworld AI 같은 음성 AI 전문 회사들이었고요.
이 팀 이력이 재밌습니다.
작년에 대학생 두 명이 창업했습니다. 구글 NotebookLM의 팟캐스트 기능에 반해서 비슷한 걸 만들어보려고 시중의 음성 합성 API를 전부 써봤는데, 자연스러운 게 하나도 없었다고 합니다. 그래서 직접 만들기로 했고요.
투자금은 0원이었습니다. 구글이 연구자에게 AI 전용 칩(TPU)을 무료로 빌려주는 TPU Research Cloud라는 프로그램으로 학습시켰고, Hugging Face의 무료 GPU 지원도 받았습니다. 그렇게 나온 게 Dia라는 대화용 음성 모델입니다. 두 사람이 대화하는 소리를 웃음이나 기침 같은 소리까지 섞어서 만들어내는 모델인데, 공개 직후 꽤 화제가 됐습니다. 지금까지 200만 번 넘게 내려받혔고요.
그런데 이번엔 모델을 만든 게 아닙니다.
이번에 1위를 한 건 알리바바가 공개한 Qwen3-TTS와 Qwen3-ASR입니다. 누구나 가져다 쓸 수 있는 공개 모델이죠.
Nari Labs가 만든 건 그 모델을 실제로 돌리는 엔진입니다.
본인들 문제의식이 이랬습니다. 공개 음성 모델이 이만큼 좋아졌는데 왜 시장은 여전히 폐쇄형 모델이 차지하고 있을까. 답은 모델이 아니라 돌리는 방식에 있다고 봤습니다. 기존에 AI 모델을 돌리는 데 쓰던 도구들이 글자 모델에 맞춰져 있어서, 음성처럼 여러 단계를 거치는 모델에는 잘 안 맞는다는 거죠.
그래서 Qwen3 음성 모델 전용 엔진을 따로 만들어 공개했습니다.
결과가 이렇습니다.
Coval은 음성 AI 서비스들을 미국 동부에서 실제 네트워크로 호출해 속도를 재는 독립 벤치마크입니다. 순위를 실시간으로 갱신하고요.
그런데 이 글을 쓰는 동안 순위가 바뀌었습니다.
9월 14일엔 음성을 글자로 바꾸는 쪽(STT)에서 Nari가 44ms로 1위였는데, 오늘 확인해보니 2위입니다. 1위는 Soniox가 38ms로 가져갔고요. 글자를 음성으로 바꾸는 쪽(TTS)도 2위에서 3위(71ms)로 내려왔습니다.
재밌는 건 Nari가 느려진 게 아니라는 점입니다. 음성 인식은 44ms 그대로예요. 경쟁사가 60ms에서 38ms로 확 빨라진 겁니다. 일주일 만에요. 이 판이 얼마나 빨리 돌아가는지 보여주는 장면이죠.
순위도 겉보기보다 복잡합니다. 글자를 음성으로 바꾸는 쪽 1위인 Fluxions의 모델은, Nari에 따르면 크기가 Qwen3-TTS의 6분의 1 정도라고 합니다. 여섯 배 가까이 큰 모델을 돌리면서 상위권을 다투는 셈이죠.
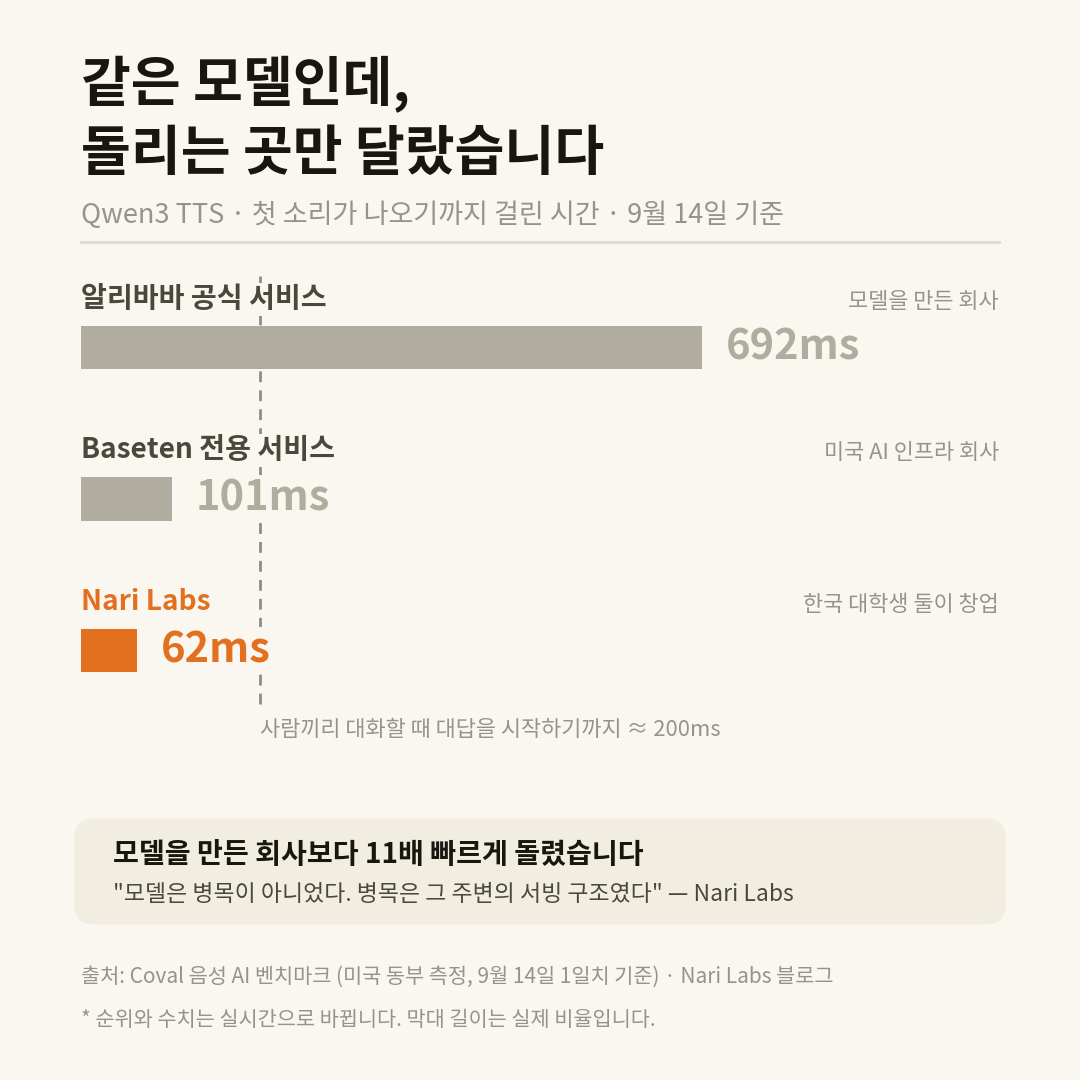
참고로 사람끼리 대화할 때 한 사람이 말을 마치고 다른 사람이 대답을 시작하기까지 평균 200ms 정도 걸린다고 합니다. 상위권은 전부 그 안에 여유 있게 들어오는 셈입니다.
그래도 순위보다 중요한 비교가 따로 있습니다.
9월 14일 기준으로, 알리바바가 직접 운영하는 Qwen3 TTS 공식 서비스는 첫 소리까지 692ms였습니다. 같은 시점에 Nari는 63ms였고요.
모델을 만든 회사가 돌리면 692ms, Nari가 돌리면 63ms. 똑같은 모델인데 11배 차이입니다.
같은 모델을 전용으로 돌려주는 미국의 Baseten 서비스도 101ms였습니다. 순위는 매일 바뀌어도, 누가 어떻게 돌리느냐가 이만큼 차이를 만든다는 건 그대로죠.
그럼 어떻게 11배가 됐을까요.
Qwen3-TTS는 안에서 세 단계를 거쳐 목소리를 만듭니다.
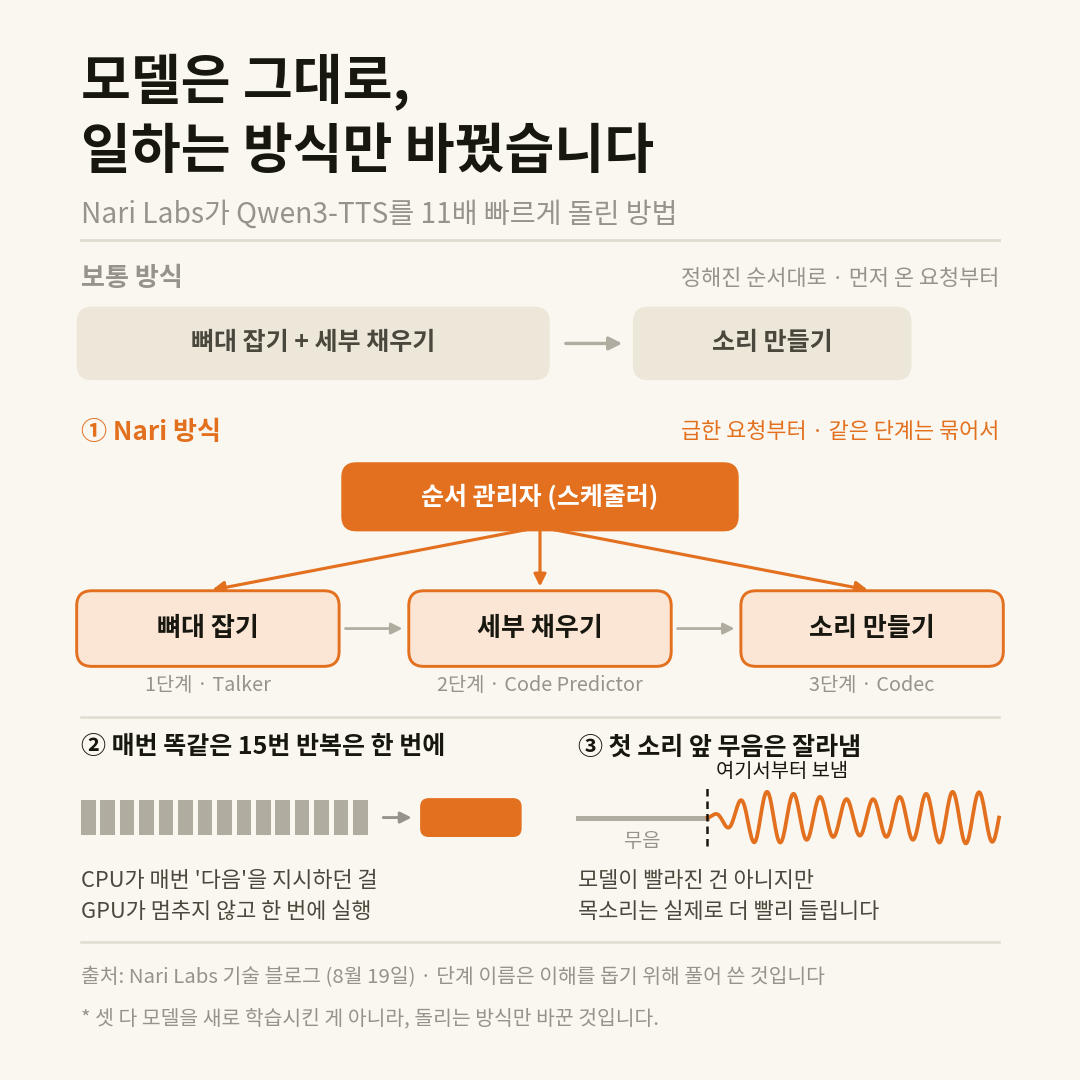
1단계, 뼈대 잡기. 다음에 나올 소리의 큰 틀을 정합니다. 2단계, 세부 채우기. 그 틀에 세밀한 소리 정보를 채웁니다. 3단계, 소리 만들기. 실제로 귀에 들리는 소리로 바꿔 내보냅니다.
Nari가 바꾼 건 크게 세 가지입니다.
첫째, 세 단계를 떼어놓고 관리자 한 명이 전부 지켜보게 했습니다.
보통은 1·2단계를 한 덩어리로 묶고 3단계만 따로 돌립니다. 정해진 순서대로, 먼저 들어온 요청부터요.
Nari는 세 단계를 완전히 떼어놓고, 순서를 정하는 관리자(스케줄러) 하나가 모든 요청의 모든 단계를 한눈에 보게 했습니다. 그래서 “어느 요청을 먼저 할지”뿐 아니라 **”그 요청의 몇 단계를 먼저 돌릴지”**까지 고릅니다.
기준은 급한 순서입니다. 소리가 곧 끊길 것 같은 요청부터 챙기고, 같은 단계를 기다리는 요청들은 묶어서 한 번에 처리합니다. 식당으로 치면 먼저 온 손님 순이 아니라 기다림이 어색해지기 직전인 테이블부터 챙기고, 같은 메뉴는 한꺼번에 볶는 셈이죠.
둘째, 매번 똑같은 반복은 한 번에 실행하게 묶었습니다.
2단계는 소리 한 조각마다 같은 계산을 정확히 15번 반복합니다. 원래는 한 번 끝날 때마다 CPU가 GPU에게 “다음 거 해”라고 지시를 내려야 했는데, Nari는 이 15번을 GPU가 멈추지 않고 한 번에 끝내는 고정 프로그램으로 묶었습니다. 지시를 주고받는 시간이 통째로 사라진 거죠.
셋째, 앞의 침묵을 잘라냈습니다.
모델이 내놓는 첫 소리에는 목소리가 시작되기 전 수십 ms의 무음이 섞여 있는 경우가 많다고 합니다. Nari는 진짜 목소리가 시작되는 지점을 찾아 그 앞을 잘라냅니다. 모델이 더 빨리 생각하는 건 아니지만, 듣는 사람 입장에선 목소리가 실제로 더 빨리 들리죠.
셋 다 모델을 새로 학습시킨 게 아닙니다. 일하는 순서와 방식을 바꿨을 뿐이에요.
그리고 같은 GPU로 더 많이 처리하니 값도 따라 내려갑니다. Nari가 밝힌 요금은 글자→음성이 100만 글자당 10달러인데, 본인들 비교로는 ElevenLabs의 대화용 모델이 5배, Cartesia가 6.5배 비싸다고 합니다.
그리고 이런 기록도 공개했습니다. 115.6시간 분량 오디오 837개를 88.6초에 처리했다고요. GPU 한 장으로, 누가 말했는지 화자 구분까지 하면서요.
전에 쓴 글과 같은 얘기가 여기서 또 나옵니다.
OpenAI의 법률 AI를 다루면서 **”모델은 안 바꾸고 주변만 갖췄더니 38.7%가 54.0%가 됐다”**고 쓴 적이 있는데요. Nari Labs가 8월에 올린 기술 블로그 한 줄이 딱 그겁니다.
“모델은 병목이 아니었다. 병목은 그 주변의 서빙 구조였다.”
같은 모델을 누가 어떻게 돌리느냐로 속도가 11배 차이 납니다. 모델 경쟁만 보면 안 보이는 싸움이죠.
다만 짚어둘 게 있습니다.
Coval 순위는 실시간으로 바뀝니다. 30분마다 갱신되고, 위에서 보신 것처럼 일주일 사이에도 순위가 달라졌습니다. 이 글을 읽으실 때쯤엔 또 다를 수 있어요. 궁금하시면 benchmarks.coval.ai에서 직접 확인하실 수 있습니다.
그리고 Nari가 자기 블로그에 올린 수치와 Coval 수치가 조금 다릅니다. Nari는 자체 실험에서 TTS 첫 소리까지 50ms 미만이 나왔다고 했는데, Coval이 네트워크 너머에서 재면 60~70ms대입니다. 측정 조건이 달라서 생기는 차이라 독립 측정치 쪽을 보시는 게 맞습니다.
정확도 순위도 Nari 블로그는 TTS 1위, STT 2위라고 했는데, 이건 9월 14일 기준 수치라 지금 시점에서는 따로 확인하지 못했습니다.
그러니 “세계에서 가장 빠른”보다는 “음성 AI 속도 벤치마크 상위권을 다투는”이 정확합니다.
그리고 지금 음성 부문은 영어 중심입니다. 한국어 성능은 따로 봐야 하고요.
그래도 이 팀 궤적이 인상적입니다.
작년엔 돈 한 푼 없이 모델을 만들었고, 올해는 남이 만든 모델을 누구보다 빠르게 돌리는 쪽으로 방향을 틀었습니다. 모델을 만드는 경쟁은 거대 기업들 판이 됐지만, 그 모델을 잘 굴리는 일에는 아직 작은 팀이 들어갈 자리가 있다는 걸 보여준 것 같아요.
그리고 그걸 한국 대학생 둘이 해냈다는 게 괜히 반갑네요.