
Haiku 5.5 출시
송찬우 5분 분량
10월 7일(미국 시간), Anthropic이 Claude Haiku 5.5를 내놨습니다.
Haiku는 Claude의 막내입니다.
Claude는 보통 큰 순서대로 Opus, Sonnet, Haiku로 나뉩니다. Haiku가 가장 작고 빠르죠. Anthropic은 이번 Haiku를 요약, 분류, 데이터 조회처럼 짧고 반복되는 일을 많이 처리하는 데 쓰라고 소개합니다. Jev와 Decisions API가 노린 자리와 같습니다.
다만 이건 ‘말을 안 하는’ 모델이 아니라 평소처럼 글을 쓰는 보통 모델입니다. 그런데 값은 그쪽과 비슷해졌습니다.
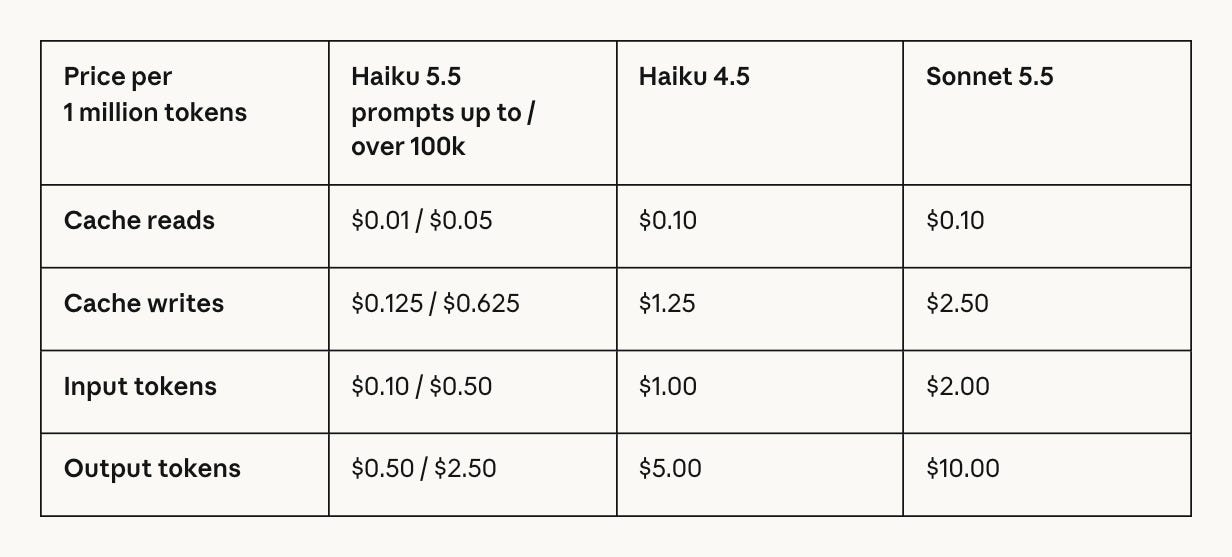
값은 10분의 1입니다.
입력 100만 토큰당 1달러이던 게 0.1달러, 출력은 5달러에서 0.5달러가 됐습니다. 지난 글의 Decisions API와 같은 입력 값이고, 그 바탕 모델인 OpenAI GPT-6 Luna와도 같은 값입니다.
조건이 하나 있습니다. 한 번에 보내는 글이 10만 토큰을 넘으면 값이 5배(입력 0.5달러, 출력 2.5달러)가 됩니다. Anthropic은 이전 Haiku에 들어온 요청의 90%쯤이 10만 토큰 이하였다고 합니다. 그래서 평균으로 따지면 75%쯤 싸졌다고 설명하고요.
성능은 크게 올랐습니다.
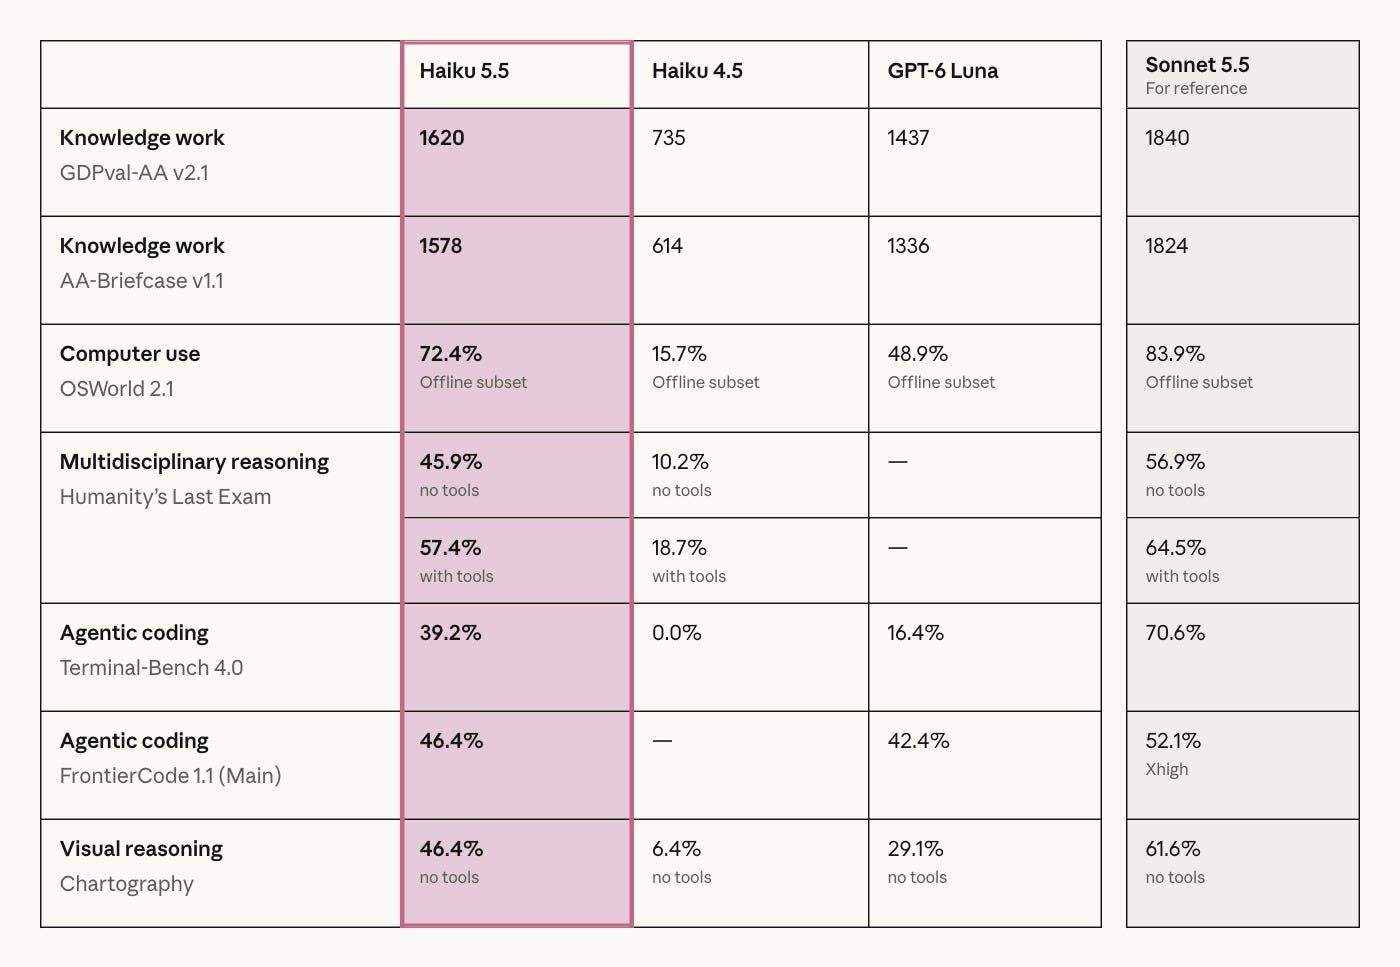
Anthropic이 낸 표를 보면, 컴퓨터 화면을 보고 마우스와 키보드로 일을 처리하는 시험(OSWorld)에서 이전 Haiku 4.5는 15.7%였는데 Haiku 5.5는 72.4%입니다. 개발자처럼 터미널에서 코딩 과제를 푸는 시험(Terminal-Bench)은 0%에서 39.2%가 됐고요.
Luna 점수가 있는 항목에서는 모두 Luna보다 높았습니다. 한 단계 위인 Sonnet 5.5보다는 여전히 낮고요.
독립 평가 점수도 비슷합니다.
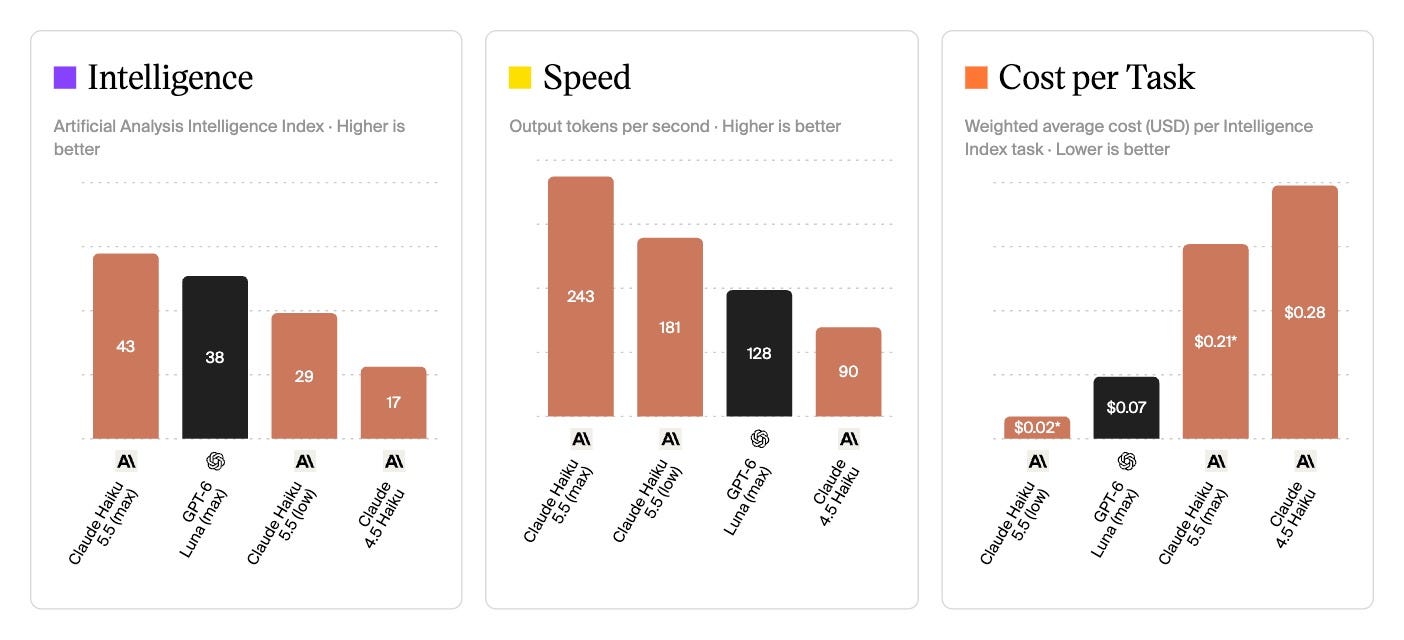
회사가 직접 낸 숫자라 독립 측정도 찾아봤습니다. AI 모델을 따로 시험해 비교하는 Artificial Analysis(AA)의 종합 점수에서 Haiku 5.5는 43점입니다. 이전 Haiku 4.5는 17점, GPT-6 Luna는 38점이에요. 글을 써내는 속도도 초당 243토큰으로 Luna(128토큰)의 두 배쯤입니다.
AA가 직접 돌린 시험 10개 가운데 Haiku가 앞선 건 5개, Luna가 앞선 건 2개, 나머지 3개는 같았습니다.
그런데 ‘태스크 처리’의 값은 다릅니다.
토큰 값이 같다고 일하는 비용까지 같은 건 아닙니다. AI가 답하기 전에 생각을 길게 하면 그만큼 토큰을 더 쓰거든요.
AA 종합 점수 시험을 한 번 다 돌리는 데 Haiku 5.5(max)는 출력 토큰을 4억 개 넘게 썼고, Luna는 1억 4천만 개쯤 썼습니다. 세 배쯤 더 쓴 셈이죠. 그래서 문제 하나 푸는 값은 Haiku 5.5가 0.21달러, Luna가 0.07달러입니다.
그래서 ‘Effort 조절’이 붙었습니다.
이번 Haiku에는 처음으로 얼마나 생각할지 정하는 설정(effort)이 붙었습니다. 가장 적게 생각하게 하면 AA 점수는 29점으로 내려가지만, 문제 하나에 0.02달러로 Luna보다도 쌉니다. 쓰는 토큰도 3,200만 개로 줄고요.
Anthropic 그래프에서도 같은 모양이 보입니다. 다이얼을 올릴수록 점수와 값이 함께 오릅니다. 가장 낮은 단계(Low)에서도 이전 Haiku 4.5보다 점수는 두 배 넘게 높고, 값은 훨씬 쌉니다.
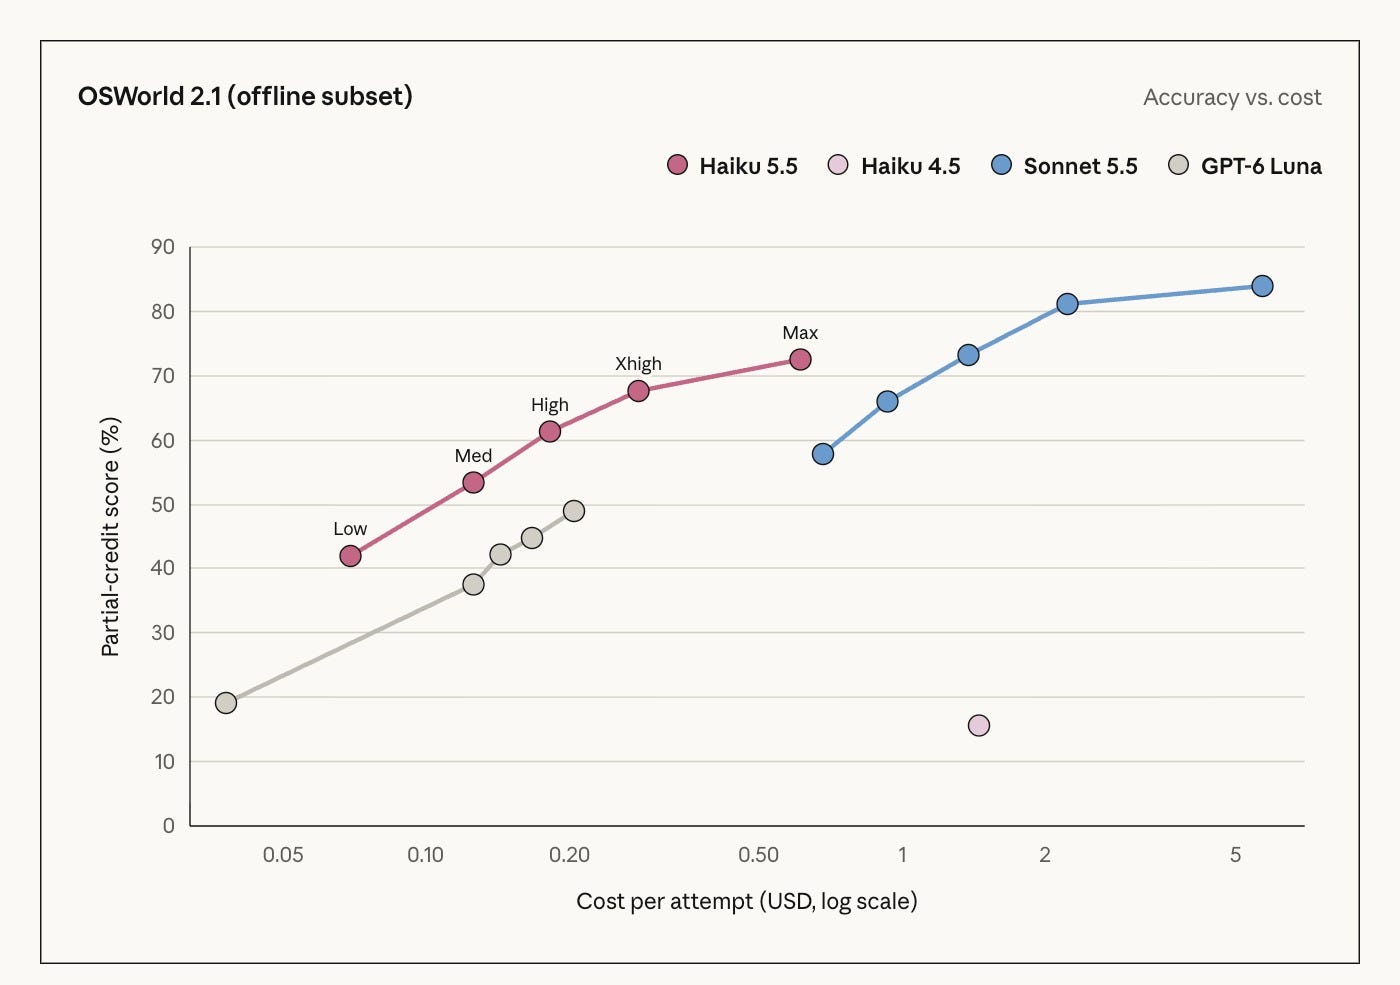
어려운 판단은 오래 생각하게 하고, 쉬운 분류는 짧게 끝내게 하는 식으로 고를 수 있다는 거죠.
큰 모델 옆에서 잔심부름을 하는 식으로.
고객사 사례도 그런 쪽입니다. 금융 AI 회사 Rogo는 큰 모델이 발표 자료를 만드는 동안, Haiku 5.5가 기업 연차 보고서에서 필요한 사업부 매출 숫자를 찾아오게 한다고 합니다. 시장 조사 플랫폼 AlphaSense는 문서 질문 기능 하나로만 모델을 일주일에 800만 번쯤 부른다고 하고요. 이렇게 자주 부르는 일에서는 한 번 값이 10분의 1이 되는 게 크게 와닿겠죠.
이제 고를 건 ‘얼마나 생각하게 할까’입니다.
3주 남짓 사이에 Jev, OpenAI Decisions API, 그리고 이번 Haiku 5.5까지 나왔습니다. 판단 한 번의 값이 계속 내려가고 있죠. 이 정도 값이면 “이 일을 AI에게 맡길까”보다 “이 판단에는 생각을 얼마나 사 줄까”를 먼저 고르게 될 것 같습니다.