
말을 안 하는 AI, 이번엔 OpenAI가 냈습니다
송찬우 5분 분량
지난달 ‘말을 안 하는 AI 모델’ Jev를 소개했었죠. 문장을 쓰는 대신 선택지 중에서 고르고, 확률을 붙여 돌려주는 모델이었습니다.
3주 만에 OpenAI도 비슷한 걸 내놨습니다. 10월 6일(미국 시간), Decisions API를 모든 개발자에게 공개 베타로 열었습니다. DevDay 때 일부에게만 먼저 보여줬던 기능이에요.
하는 일은 Jev와 같습니다.
질문과 보기를 주면 문장이 아니라 값을 돌려줍니다. 방식은 세 가지예요.
- 예/아니오: “사진 속 물건에 찌그러진 데가 있나?” → 찌그러졌을 확률
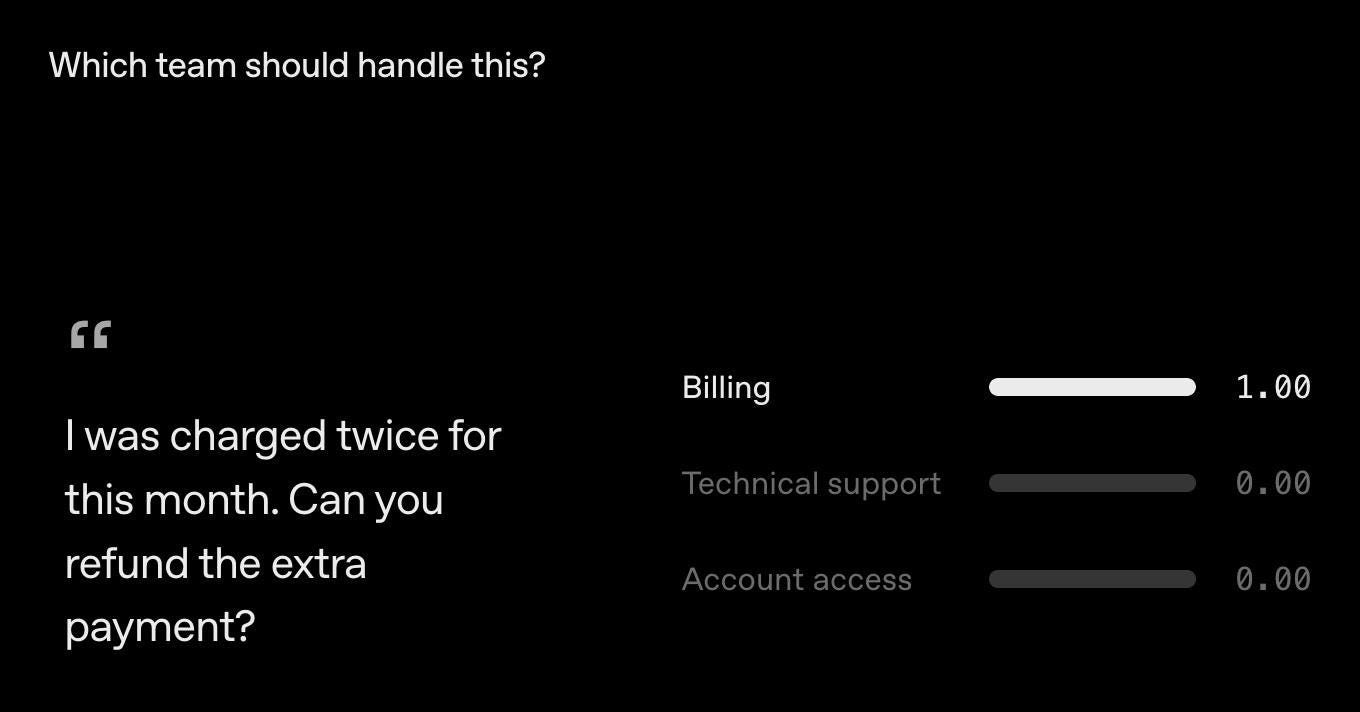
- 고르기: “이 문의는 결제, 기술 지원, 계정 중 어느 팀이 맡을까?” → 고른 팀과 보기별 확률
- 점수: “이 택배 상자는 얼마나 망가졌나? (멀쩡함 / 조금 망가짐 / 크게 망가짐)” → 몇 단계쯤인지
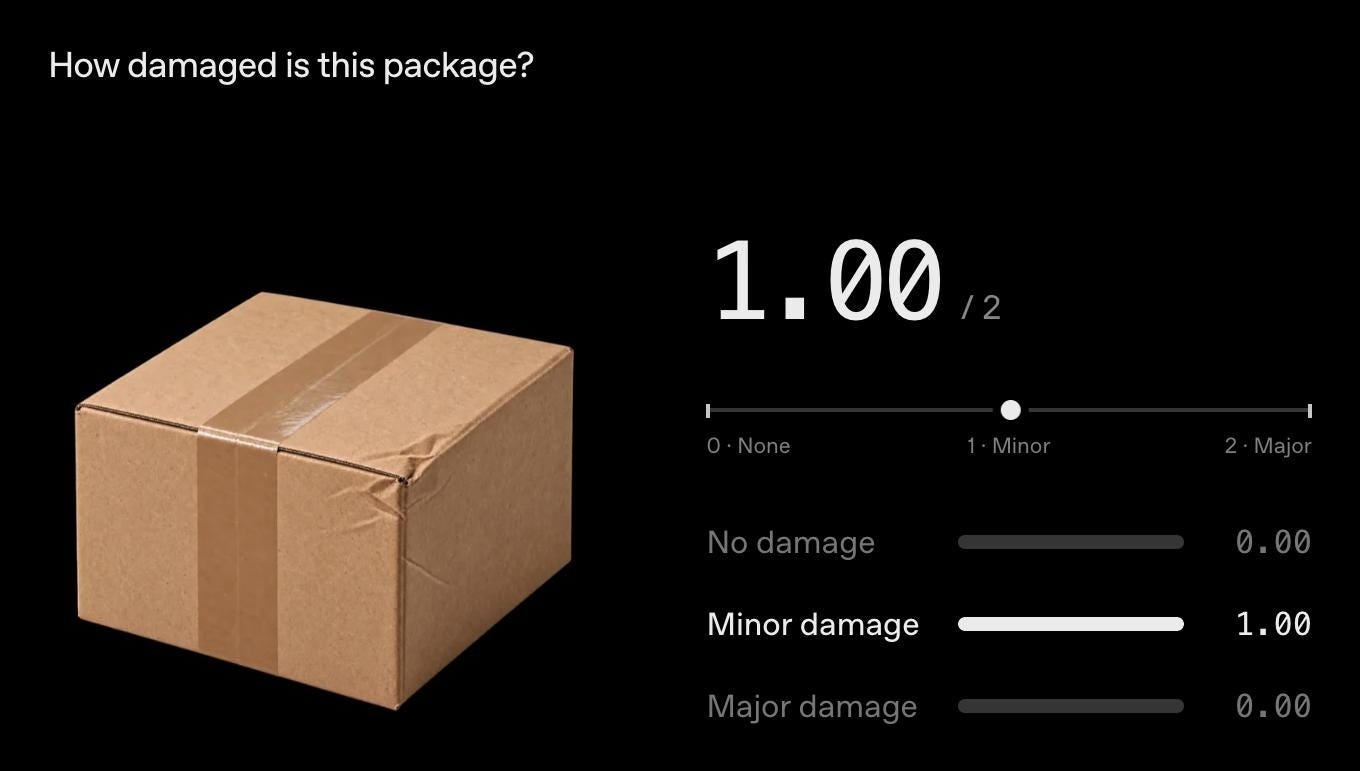
점수는 단계별 확률을 섞어서 내기 때문에, ‘조금 망가짐’과 ‘크게 망가짐’ 사이 어디쯤이라는 값도 나옵니다.
같은 글이나 사진에 여러 질문을 한 번에 묶어 물을 수 있는 것도 Jev와 같고요. 첫 번째 예처럼 사진을 넣을 수도 있습니다.
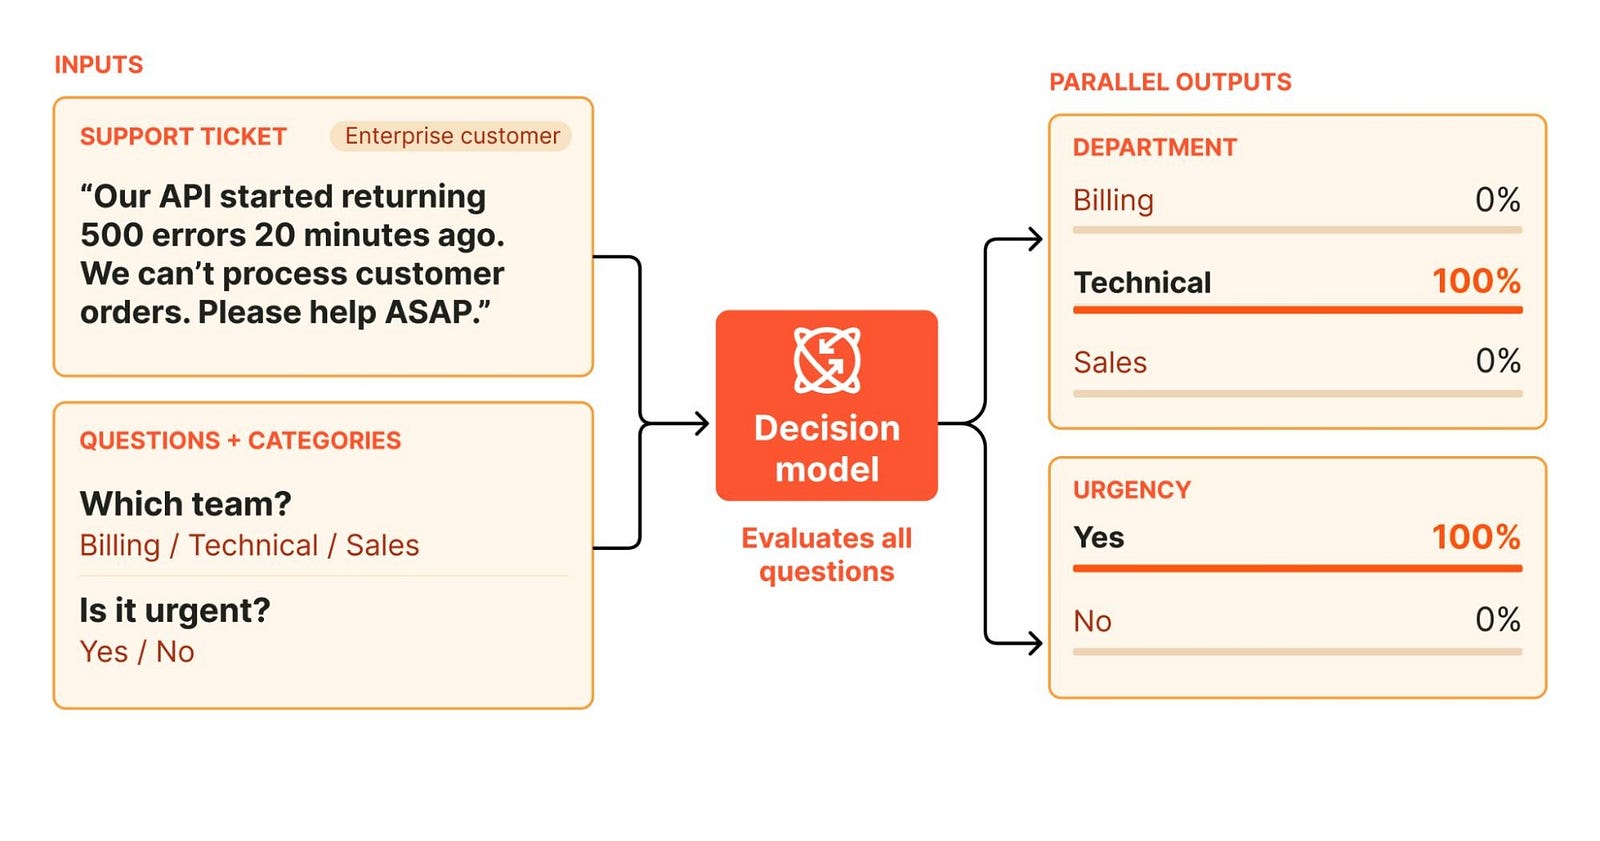
다른 건 만든 방식입니다.
지난 글에서 한 개발자의 평을 전했었죠.
“사실 구조화된 출력을 쓰는 평범한 LLM과 크게 다르지 않다. 다만 인터페이스가 아주 좋다.”
OpenAI가 내놓은 게 딱 그 모양입니다. 새 모델을 따로 내놓은 게 아니라, 평소엔 글을 쓰는 보통 모델 GPT-6 Luna에 ‘고르기 전용’ 창구를 하나 더 낸 거거든요.
그렇다고 겉만 바꾼 건 아닙니다. 같은 Luna를 평소처럼 부를 때보다 10배쯤 빠르다고 합니다. 같은 모델이라도 말을 시키지 않고 고르게만 하면 그만큼 빨라진다는 거죠.
값은 아직 Jev가 쌉니다.
입력 100만 토큰당 0.1달러이고, 출력은 무료입니다. Jev가 0.042달러였으니 Jev 쪽이 절반도 안 되죠.
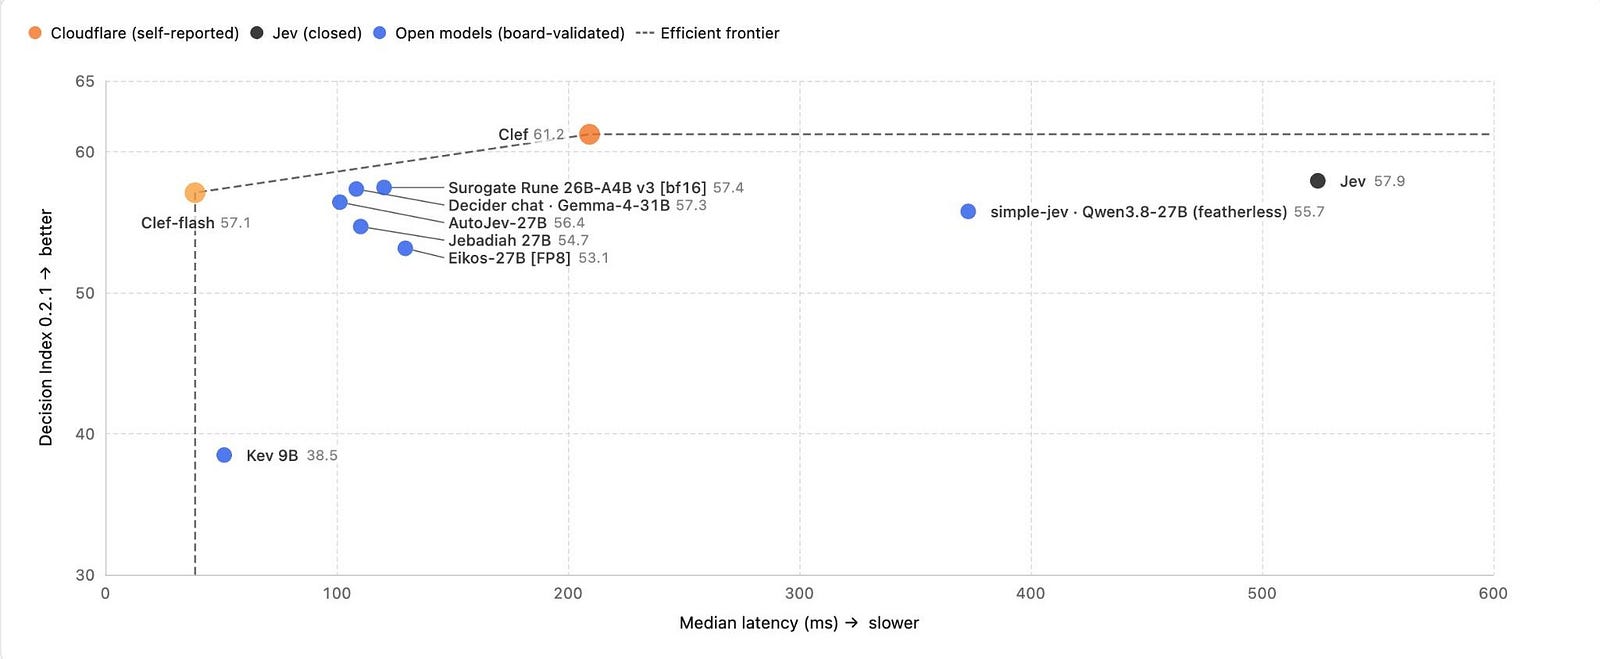
다만 경쟁자는 OpenAI만이 아닙니다. 10월 1일에는 클라우드플레어(Clef)와 아마존(Strands Decider 2B)도 비슷한 모델을 내놨는데, 둘 다 누구나 내려받아 쓸 수 있게 공개했습니다.
조심할 점도 그대로입니다.
Jev의 ‘수학적으로 환각이 불가능하다’는 주장을 두고, ‘형식이 틀릴 수 없다’는 뜻이지 ‘판단이 맞다’는 뜻이 아니라고 짚었었는데요. OpenAI 것도 마찬가지입니다. 보기 안에서만 답하니 없는 말을 지어낼 수는 없지만, 틀린 보기를 자신 있게 고를 수는 있습니다.
지난번에 “내 데이터에서 실제로 얼마나 맞는지는 직접 재봐야 한다”고 썼는데, OpenAI 문서에도 같은 얘기가 있습니다. 어디까지 자동으로 처리하고 어디부터 사람이 볼지, 그 판단의 기준은 정답을 아는 내 서비스 예시로 직접 정하라고요. 잘못 통과시키는 것과 잘못 걸러내는 것 중 어느 쪽 손해가 더 큰지 따져서요.
결국 남는 건 그 판단 기준입니다.
지난번 글은 제번스 역설로 마무리했었죠. 판단 하나가 충분히 싸지면, 사람들이 판단을 훨씬 더 많이 하게 될 거라고요. 3주 만에 OpenAI, 아마존, 클라우드플레어까지 들어왔으니 판단은 앞으로 더 싸지고 흔해질 겁니다.
우리가 보낸 문의가 어느 팀으로 갈지, 올린 사진에 흠이 있는지 같은 판단도 점점 이런 모델이 먼저 내리게 되겠죠. 사람에게 넘어오는 건 확신도가 기준선 아래인 것들뿐이고요. 그 선을 어디에 긋느냐가, 사람이 어디까지 들여다볼지를 정하게 될 것 같습니다.
https://developers.openai.com/api/docs/guides/decisions
#AI #OpenAI #DecisionsAPI #Jev #LLM #개발