
Gemini 4 Argon은 정말 1등일까?
송찬우 10분 분량
구글이 9월 30일(미국 시간) 새 최상위 모델 Gemini 4 Argon을 발표했습니다. Flash보다 윗급 모델로는 7개월여 만입니다.
게시글 부제는 이렇습니다. “Gemini 4 Argon은 실제 소프트웨어 개발, 법률·금융 같은 기업 지식 업무, 사이버 보안 방어 분야의 복잡한 작업에서 최전선의 성능을 낸다.”
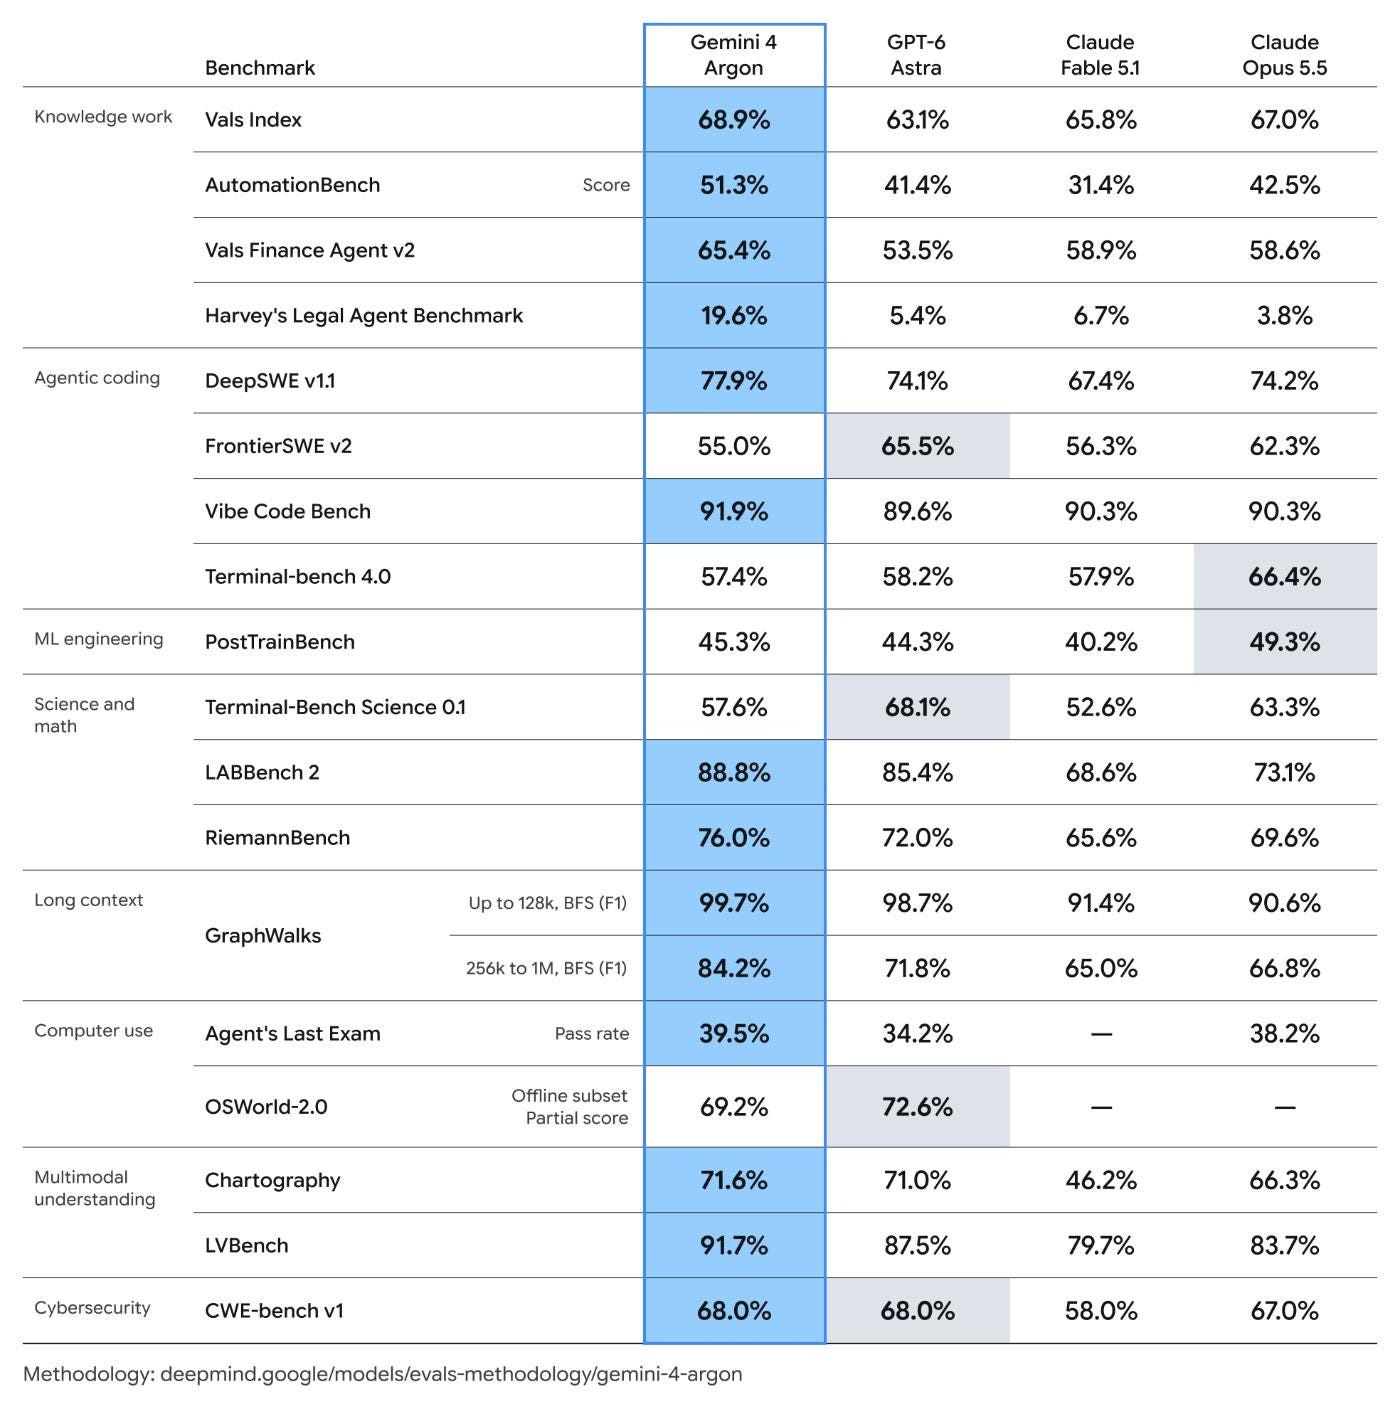
자신감의 근거는 함께 공개한 성적표입니다. GPT-6 Astra, Claude Fable 5.1, Claude Opus 5.5와 18개 시험을 나란히 놓았는데, 13개에서 1등이거나 공동 1등입니다.
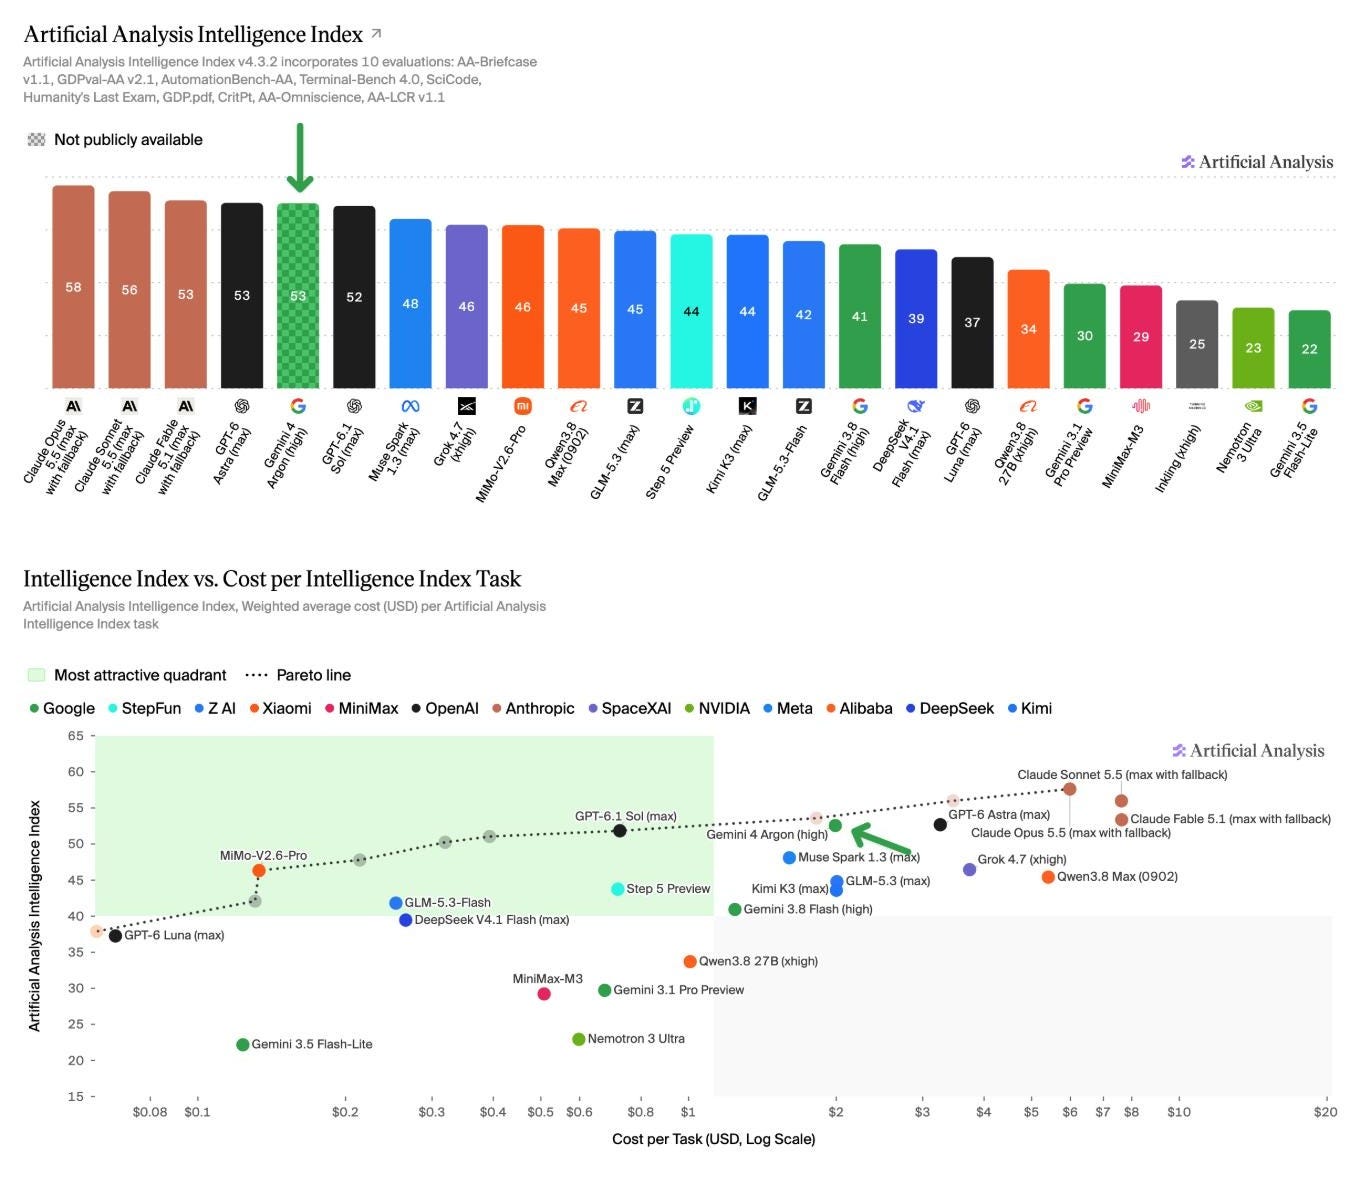
그런데 같은 날, AI 모델을 독립적으로 시험하는 Artificial Analysis(이하 AA)가 매긴 종합 점수는 53점입니다. GPT-6 Astra, Claude Fable 5.1과 같은 점수이고, Claude Opus 5.5(58점)와 Sonnet 5.5(56점)보다는 낮습니다. 모델별로 보면 공동 3위입니다.
13관왕인데 공동 3위. 결론부터 말씀드리면 이번에도 둘 다 맞습니다. 어떤 시험지로, 누구와 비교했느냐가 달랐을 뿐입니다. 뭐가 좋아졌는지부터 보겠습니다.
뭐가 좋아졌나
구글 표에서 차이가 가장 큰 건 업무 쪽입니다. 법률 리서치와 문서 작성을 시키는 시험(Harvey’s Legal Agent Benchmark)에서 Argon은 19.6%로, 2등인 Claude Fable 5.1(6.7%)의 세 배 가까이 됩니다. 재피어(Zapier)가 만든 업무 자동화 시험(AutomationBench)도 51.3%로, 2등인 Opus 5.5(42.5%)보다 9점 가까이 높고요.
긴 자료를 다루는 것도 강합니다. 아주 긴 자료 속에서 연결 관계를 따라가는 시험(GraphWalks)의 가장 긴 구간에서 84.2%로 GPT-6 Astra(71.8%)보다 12점 넘게 높고, 긴 영상을 이해하는 시험(LVBench)은 91.7%로 가장 높습니다.
한 번에 쓸 수 있는 분량도 크게 늘었습니다. 출력 한도가 6만 4천 토큰에서 100만 토큰으로, 15배 넘게 커졌습니다. 여기서 토큰은 AI가 글을 읽고 쓰는 단위입니다. 대략 글자 조각이라고 보시면 되는데, 뒤에서 가격 얘기할 때 이게 중요해집니다. 구글은 “깊이 생각하며 수십만 토큰을 한 번에 써 내려갈 여유가 생기면, 어려운 문제를 한 번에 풀 수 있을 만큼 추론이 깊어진다”고 설명합니다.
구글 안에서 먼저 써본 사례도 흥미롭습니다. Argon 에이전트들이 구글 데이터센터 전반의 메모리 사용 기록을 분석해 스스로 최적화를 적용했더니, 300TiB가 넘는 메모리를 확보했다고 합니다. 동영상 디코더(libgav1)의 기존 Rust 버전에서는 최적화 코드(SIMD) 3만 2천 줄을 안전한 Rust 코드로 바꿔, 2.7배 빠르게 만들기도 했고요.
1등과 공동 3위 사이
그런데 구글 표를 자세히 보면 빈자리가 있습니다. 비교 대상이 GPT-6 Astra, Claude Fable 5.1, Claude Opus 5.5 세 모델뿐입니다. 이틀 전 나온 Claude Sonnet 5.5와 하루 전 나온 GPT-6.1 Sol은 없습니다. 발표 직전에 나온 모델이라 빠진 건 이해가 됩니다. 다만 Sonnet 5.5는 AA 종합 2위(56점)이고, GPT-6.1 Sol은 Argon보다 1점 낮은 52점을 훨씬 적은 과제당 비용으로 내는 모델입니다.
Argon이 약한 시험도 표에 그대로 있습니다. 명령어 창에서 여러 단계짜리 코딩 작업을 해내는 시험(Terminal-bench 4.0)은 57.4%로 네 모델 중 꼴찌이고, 다른 코딩 시험(FrontierSWE v2)도 55.0%로 꼴찌입니다.
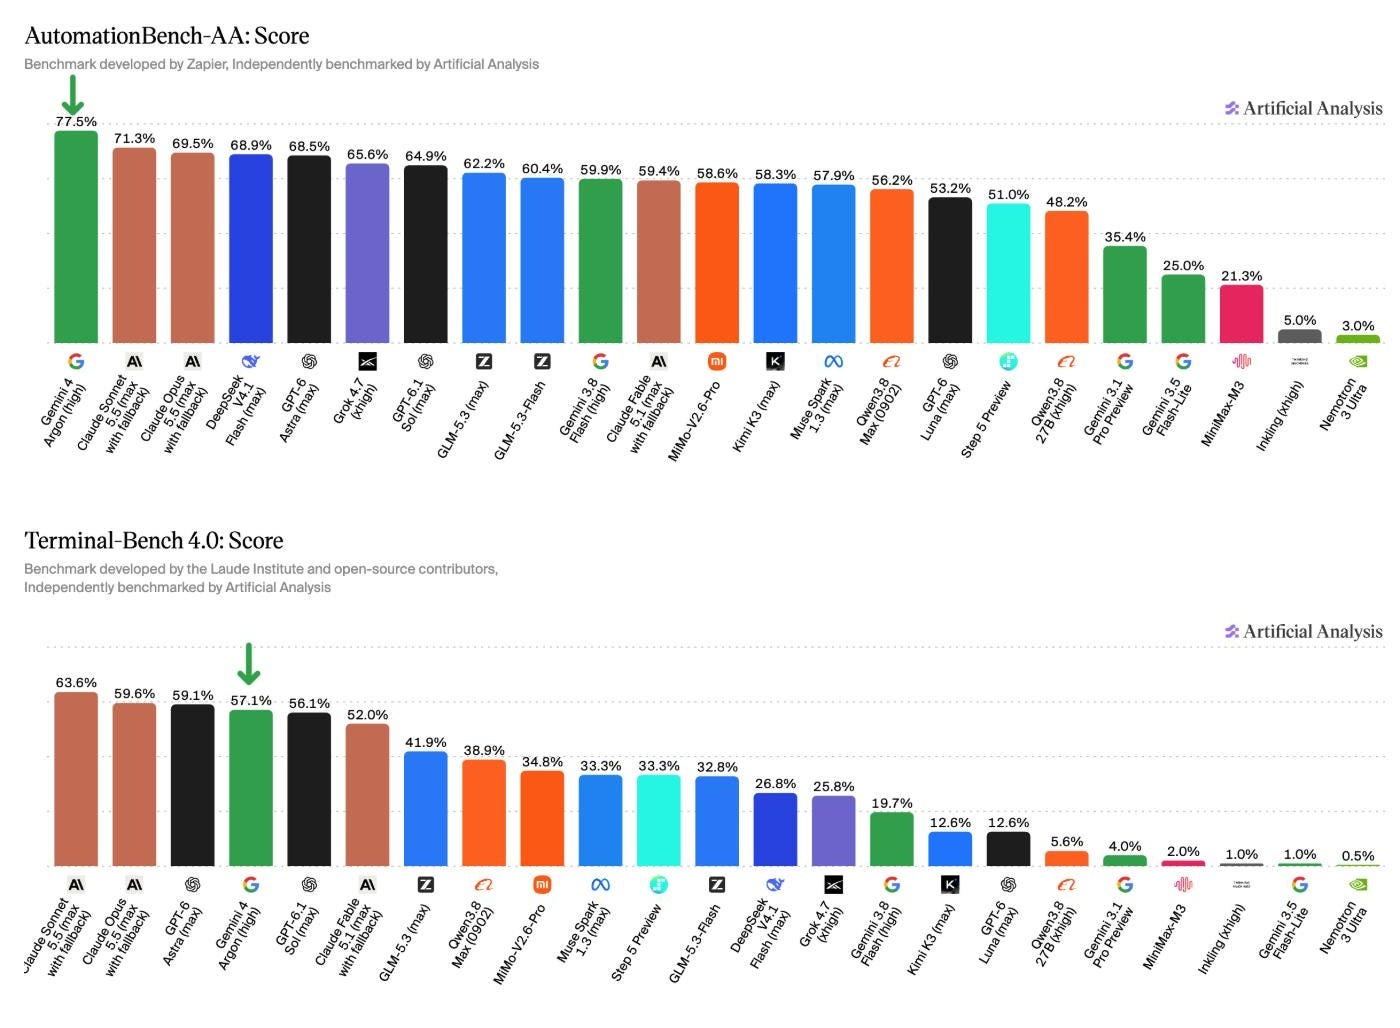
AA의 시험지는 이 약점을 피해 가지 않습니다. 열 가지 시험을 묶은 종합 점수 안에 Terminal-Bench 4.0이 들어 있는데, 여기서 Argon은 57.1%로 Sonnet 5.5(63.6%), Opus 5.5(59.6%), GPT-6 Astra(59.1%)에 이어 4위입니다. 반대로 AA가 직접 돌린 업무 자동화 시험(AutomationBench-AA)에서는 77.5%로 1위입니다. 2위 Sonnet 5.5(71.3%)보다 6점 넘게 높습니다.
업무 결과물을 만들어 내는 시험(AA-Briefcase)에서도 비슷한 성격이 보입니다. 평가 기준을 통과한 비율은 65%로 AA가 잰 모델 중 가장 높았는데, 분석의 질과 결과물을 정리해 보여주는 점수는 상대적으로 낮았습니다. 요구사항은 가장 잘 챙기는데, 분석의 질과 모양새는 아쉬운 셈이죠.
정리하면 업무 자동화는 독립 평가에서도 1위이고, 코딩은 시험에 따라 엇갈립니다. 법률·금융 리서치나 긴 자료를 다루는 쪽은 아직 구글 자체 비교에서의 1위고요. 구글 표의 13관왕과 AA의 공동 3위는 같은 모델의 다른 면을 본 겁니다.
제일 눈에 띄는 건 ‘모른다’는 말
개인적으로 이번 AA 결과에서 제일 인상적인 건 따로 있습니다. 지식을 묻는 시험(AA-Omniscience)에서 Argon이 모르는 걸 지어내는 비율은 15%로, 종합 점수 45점 이상인 모델 중 가장 낮습니다. GPT-6 Astra는 51%, GPT-6.1 Sol은 54%, Claude Opus 5.5는 59%입니다.
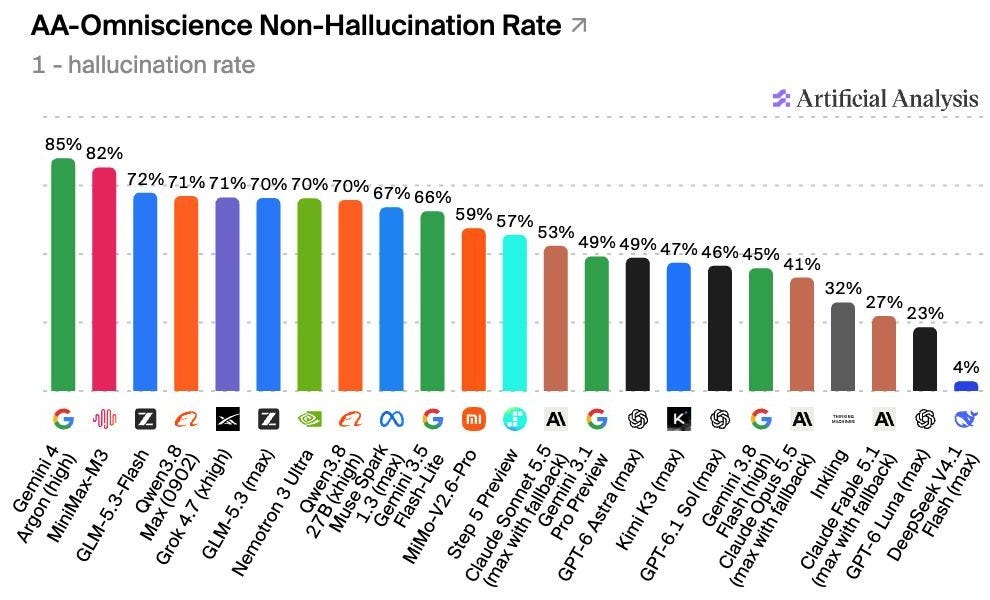
대신 아는 것 자체가 많은 건 아닙니다. 정답률은 50%로 GPT-6 Astra(63%)보다 13점 낮습니다. 그래서 둘을 합친 점수는 비슷합니다(Argon 42점, Astra 43점). 시험에 비유하면, 아는 문제는 Astra가 더 많은데 Argon은 모르는 문제를 찍지 않고 비워 두는 학생입니다.
AI를 매일 쓰는 입장에서는 이게 꽤 중요합니다. 자신 있게 틀린 답을 내놓는 것보다 “모르겠다”가 나을 때가 많으니까요. 법률이나 금융처럼 틀리면 곤란한 일에서는 더 그렇고요.
싸 보이지만, 말이 많습니다
가격은 입력 100만 토큰에 2달러, 출력 100만 토큰에 10달러입니다. GPT-6 Astra(10달러, 50달러)의 5분의 1이고, Sonnet 5.5나 GPT-6.1 Sol과 같습니다.
그런데 이건 출시 기념 50% 할인가입니다. 할인이 끝나면 4달러, 20달러로 Opus 5.5와 같아집니다. 끝나는 날짜는 아직 발표되지 않았고, AA에 따르면 적어도 한 달은 이 가격이 유지됩니다.
그리고 Argon은 토큰을 많이 씁니다. AA 기준으로 과제 하나에 출력 토큰을 약 6만 2천 개 쓰는데, GPT-6 Astra(2만 7천 개)의 2.3배입니다. 오래, 길게 생각하는 모델이라서죠.
그래서 과제 하나를 처리하는 비용은 할인가로 1.99달러, Astra(3.26달러)의 60% 수준입니다. 단가는 5분의 1인데 비용은 5분의 3인 셈이죠. 할인이 끝나면 3.98달러로, 오히려 Astra보다 20%쯤 비싸집니다.
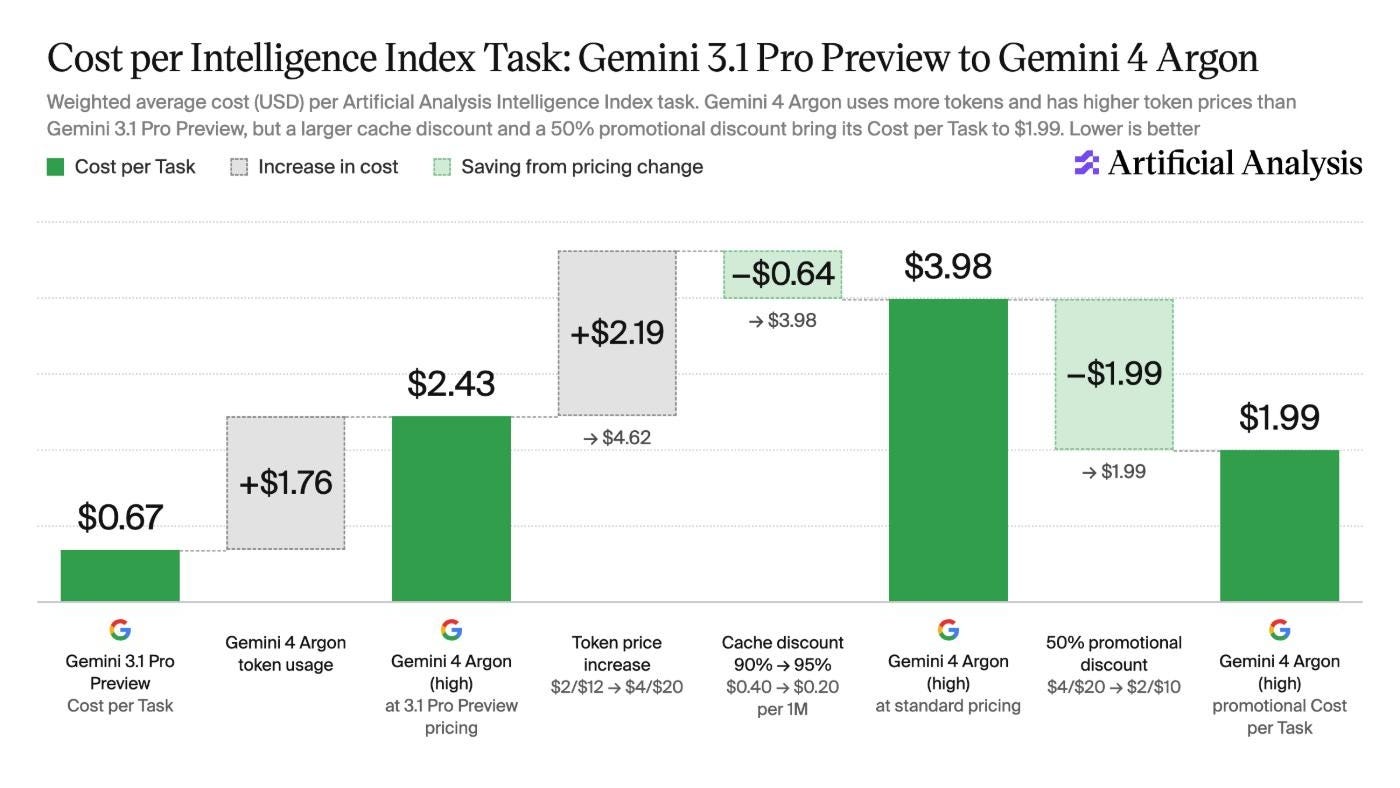
GPT-6.1 Sol을 옆에 놓으면 더 분명해집니다. Sol은 52점으로 Argon보다 1점 낮은데, 과제당 비용은 0.72달러입니다. 할인가로 따져도 Argon이 2.7배 넘게 비쌉니다.
그리고 아직은, 쓸 수 없습니다
마지막으로 중요한 게 하나 남았습니다. 일반 사용자는 아직 쓸 수 없습니다.
Argon은 외부에는 먼저 구글의 Fairwind 프로그램을 통해 검증된 보안 전문가들에게 풀리고 있습니다. 구글은 미국 정부가 출시 전 모델을 미리 점검하는 자발적 절차에도 참여하고 있고, 피드백을 받아 안전장치를 다듬은 뒤 유료 API 고객과 구글의 유료 구독 AI Ultra 가입자부터 열겠다고 했습니다. 날짜는 “가능한 한 빨리”입니다.
보안 쪽부터 챙긴 데는 이유가 있습니다. Argon은 소프트웨어 취약점을 스스로 찾고, 검증하고, 고치도록 훈련됐습니다. 구글이 올해 인수한 보안 기업 Wiz가 미리 써봤더니, 전 세계 병원이 쓰는 의료 소프트웨어에서 민감한 개인정보가 노출되는 심각한 취약점을 찾아냈다고 합니다. 이전 최상위 모델들이 놓친 걸요. 구글은 검증된 보안 전문가와 사내 팀에는 보안 관련 제한을 풀고 Argon을 제공한다고 밝혔습니다. 그리고 “이 수준의 능력을 안전하게 내놓으려면 단계적인 접근이 필요하다”고 적었습니다.
속도도 아직 모릅니다. AA 속도 그래프에 Argon이 빠져 있는데, 느려서가 아니라 일반에 공개된 API가 없어 아직 재지 못해서입니다. 다만 과제 하나에 쓰는 토큰이 GPT-6 Astra의 2.3배라, 속도가 같다고 쳐도 답을 다 받기까지는 더 오래 걸릴 수밖에 없습니다. 실제로 풀리고 나면 숫자가 조금 달라질 수도 있고요.
1등보다 ‘어디서’ 1등인지
그래서 Gemini 4 Argon은 1등일까요?
업무 자동화는 독립 평가에서도 1등이고, 법률·금융 리서치나 긴 자료와 긴 영상을 다루는 일은 구글이 비교한 모델들 사이에서 1등입니다. 모르는 걸 모른다고 하는 것도 지금 가장 잘하고요. 하지만 종합 점수로는 공동 3위이고, 명령어 창 코딩은 Claude와 GPT-6 Astra가 앞섭니다. 가격도 할인을 빼고 보면 싸지 않고, 속도는 아직 재지도 못했습니다.
그래도 구글이 다시 선두권에 돌아온 건 분명합니다. AA 기사 제목도 “구글이 다시 상위 3개 연구소로 돌아왔다”입니다. 직전 Pro급 모델(Gemini 3.1 Pro Preview, 30점)보다 23점이 올랐으니까요.
요즘은 새 모델이 나올 때마다 “1등”이라는 말이 붙습니다. 그런데 이번처럼 13관왕과 공동 3위가 동시에 맞을 수 있습니다. 그러니 질문을 바꿔야 할 것 같습니다. “어떤 모델이 1등이야?”가 아니라, “내가 맡길 일에서는 어떤 모델이 1등이야?”로요.
Argon이 풀리면 직접 써보고 다시 정리해보겠습니다.
https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon/
#AI #Gemini #Gemini4 #Google #ArtificialAnalysis #LLM