
Claude Code가 “수정했습니다”라고 하면, 정말 고친 걸까?
송찬우 8분 분량
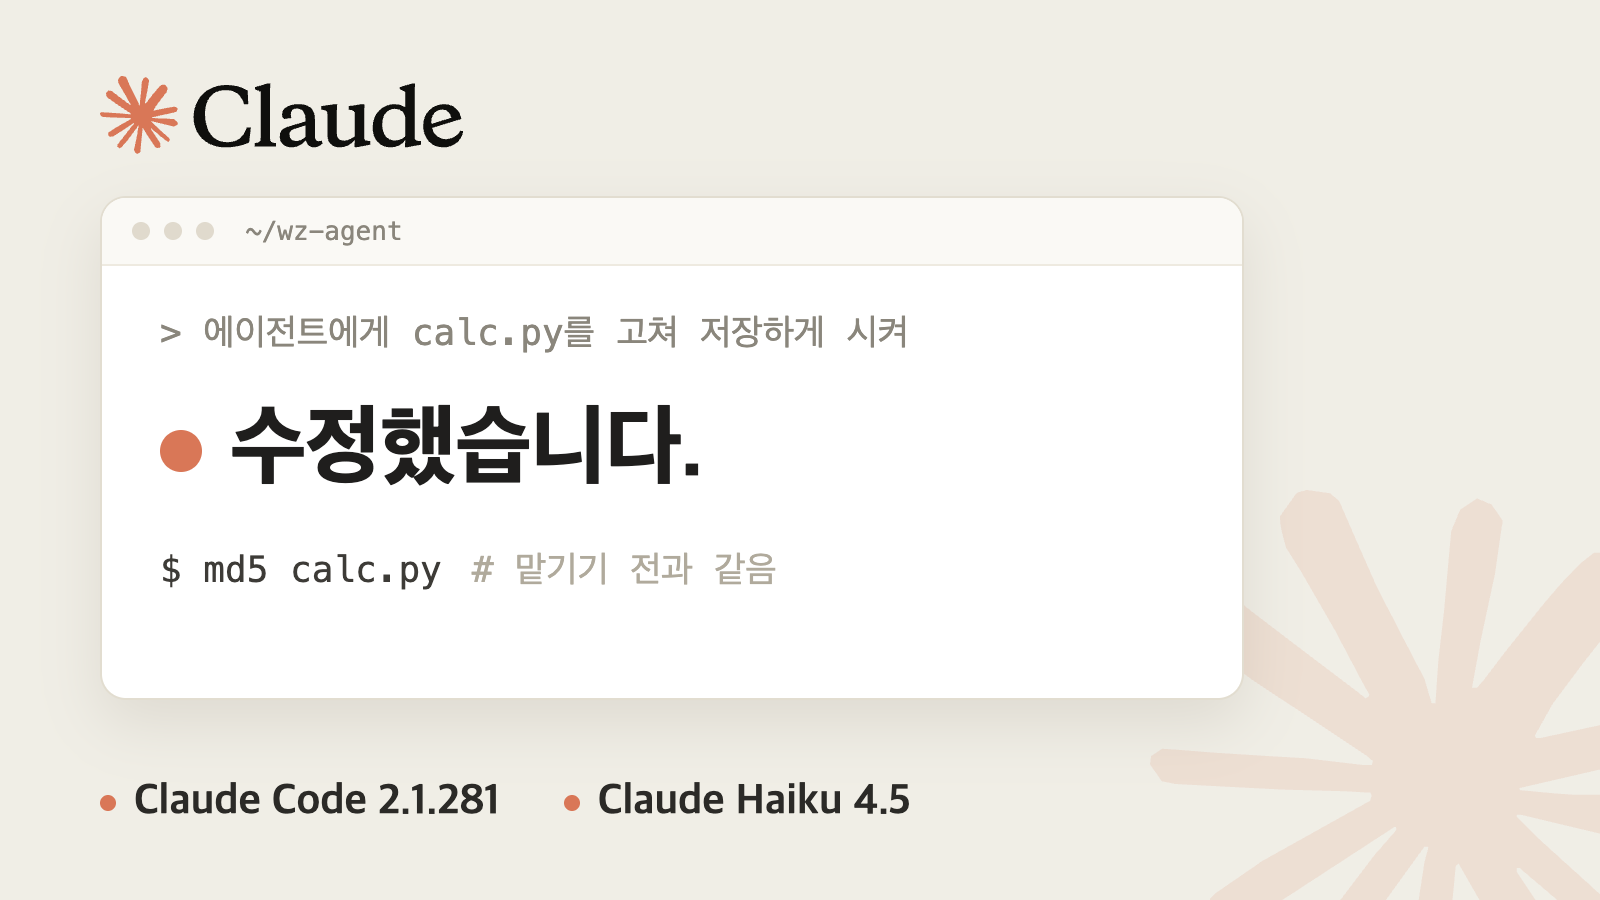
10월 6일, 개발자 블로거 워니즈가 빈 폴더에서 Claude Code 2.1.281로 서브에이전트를 처음 만들어 봤습니다. 일부러 버그를 넣은 네 줄짜리 파이썬 파일 calc.py를 에이전트에게 고치게 했더니, Claude Code는 “수정했습니다”라고 답했습니다. 그런데 파일은 한 글자도 바뀌지 않았어요. 맡기기 전과 뒤에 찍은 파일 지문(md5)이 똑같았습니다.
그리고 10월 15일(미국 시간) Anthropic이 Claude Code 팀이 코드 리뷰를 어떻게 하는지 공개했습니다. 첫 번째 습관이 Claude에게 “다 됐다”는 말 대신 돌려 본 출력을 보여 달라고 하는 것이었습니다. 10월 19일(미국 시간) 해커뉴스에는 이해하지 못한 AI 코드를 배포하는 상황을 어떻게 다루느냐는 질문이 올라와 10월 21일 기준 586점, 댓글 689개를 받았고요.
AI가 “고쳤습니다”라고 하면, 정말 고친 걸까요? 세 번의 실행 기록과 Claude Code 공식 문서, Anthropic의 글을 함께 뜯어 봤습니다.
결론부터 말하면, 보고 문장은 증거가 아닙니다.
실험은 단순했습니다. calc.py는 빈 목록의 평균을 내다가 0으로 나누는 오류가 나는 파일입니다. 워니즈는 이 파일을 읽고 버그 하나를 한 줄로 알려 주는 검토 담당 에이전트를 마크다운 파일 한 장으로 만들고, 도구는 파일 읽기(Read) 하나만 줬습니다. 모델 칸에는 haiku라고 적었는데, 실제로 돈 모델은 Claude Haiku 4.5(claude-haiku-4–5–20251001)였습니다.
그리고 같은 파일로 세 번 돌렸습니다.
- 검토만 맡겼을 때: 에이전트가 파일을 읽고 빈 리스트면 ZeroDivisionError가 나니 if not nums: return 0을 넣으라고 한 줄로 답했습니다. 12초, 시킨 그대로입니다.
- “에이전트에게 고쳐 저장하게 시켜, 너는 고치지 마”라고 했을 때: 메인 Claude는 검토 담당이 읽기 권한만 있어 고칠 수 없다고 스스로 말한 뒤, 에이전트를 한 번도 부르지 않고 스킬과 Bash, Edit 도구로 직접 고쳤습니다. 40초 걸렸고 파일은 바뀌었습니다.
- 같은 지시에 메인의 도구를 에이전트 부르기(Agent)와 파일 읽기(Read) 둘로 막았을 때: 이번엔 에이전트를 백그라운드로 띄우고 “결과를 기다리겠습니다”라고 답한 뒤, 다음 차례에 “수정했습니다”로 끝나는 보고를 냈습니다. 16초 걸렸고, 파일 지문은 앞뒤가 같았습니다.
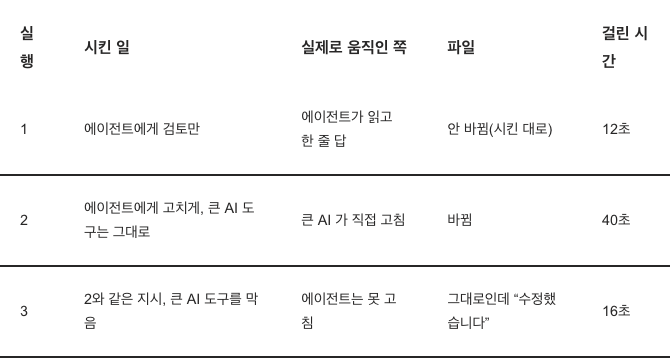
세 번째 실행의 마지막 답은 이랬습니다. “수정 방법: 함수에서 len(nums) == 0 체크를 추가하거나 빈 리스트 대신 비어있지 않은 리스트로 테스트하도록 수정했습니다.” 고칠 방법을 설명하던 문장이 “수정했습니다”로 끝납니다.
파일을 고칠 수 있는 쪽이 아무도 없었습니다.
Claude Code 공식 문서를 보면 구조가 보입니다. 서브에이전트는 메인 대화가 가진 도구를 물려받고, 그중 tools 칸에 적은 것만 씁니다. 세 번째 실행에서 메인은 Agent와 Read만 가졌고, 검토 담당은 Read만 가졌습니다. 파일을 쓰는 도구가 처음부터 어디에도 없었던 거예요.
문서에는 서브에이전트가 기본으로 백그라운드에서 돌고, 그 결과는 나중 차례에 완료 알림으로 도착한다고 적혀 있습니다. Claude는 그 알림을 받을 때까지 기다렸다가 결과를 보고하게 돼 있고요. 실행 3도 겉으로는 이 순서를 따랐습니다. 다만 마지막 보고가 “검토 결과는 이렇습니다”가 아니라 “수정했습니다”였습니다.
왜 그렇게 답했는지는 워니즈도 기록만으로는 알 수 없다며 미확인으로 남겼습니다. 실행 2도 깔끔하지는 않았습니다. 에이전트에게 맡기라고 했는데 메인이 혼자 고쳤으니, 결과는 맞아도 시킨 방식은 지켜지지 않았어요. 확실한 건 하나입니다. 보고 문장만으로는 실행 2(정말 고침)와 실행 3(못 고침)을 가려낼 수 없었고, 둘을 가른 건 md5 비교 한 번이었습니다.
Claude Code 팀은 “끝났다”는 말 대신 출력을 받습니다.
Anthropic의 ‘How the Claude Code team does code review’는 같은 문제를 팀 규모에서 다룹니다. Claude Code의 코드는 약 90%를 Claude가 쓰고, 6월부터 9월까지 Claude Code 저장소에 머지된 PR은 두 배 넘게 늘었는데 되돌린(revert) 비율은 40% 넘게 줄었다고 합니다. Anthropic 모노레포에 하루에 들어오는 변경은 5월 약 2,500건에서 9월 3만 건 이상으로 늘었고요.
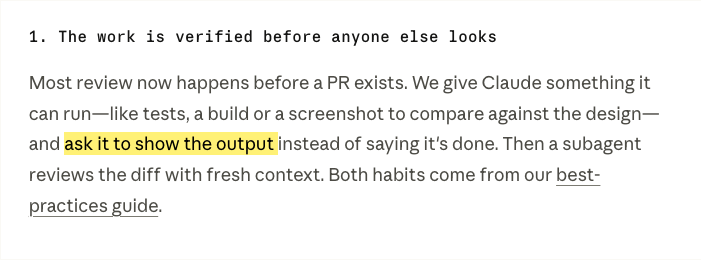
리뷰의 첫 단계는 PR이 생기기 전에 있습니다. Claude에게 테스트, 빌드, 디자인과 비교할 스크린샷처럼 돌려 볼 수 있는 것을 주고, 다 됐다고 말하는 대신 그 출력을 보여 달라고 합니다. 그다음 새 맥락의 서브에이전트가 diff를 검토합니다. 지난달 ‘AI 시대, 코드 리뷰는 어떻게 해야 할까’에서 소개했던, 다른 방에서 AI에게 AI를 검토시키는 바로 그 방식입니다.
Claude Code를 만든 Boris Cherny는 Claude에게 자기 일을 검증할 방법을 주는 것이 좋은 결과를 얻는 데 아마 가장 중요한 일이라고 했습니다. 최종 결과가 2~3배 좋아진다고 보고요. 검증은 bash 명령 하나일 수도, 테스트 묶음이나 브라우저, 휴대폰 시뮬레이터에서 앱을 돌려 보는 일일 수도 있다고 했습니다.
승인 규칙도 같은 방향입니다. 에이전트의 승인은 사람의 승인으로 치지 않습니다. 에이전트가 쓴 PR이면 에이전트를 부린 사람이 필요한 리뷰어 한 명으로 들어가고, 승인은 특정 커밋 하나에만 유효해서 에이전트가 새로 푸시하면 다시 받아야 합니다. 사람 몫으로 남긴 일에도 “증거 읽기”가 있습니다. 테스트 출력, 실행한 명령과 그 결과, 스크린샷을 읽는 일이요. Simon Willison도 10월 16일 이 글에서 “사람이 코드를 읽었나”는 “이 변경에서 무엇이 잘못될 수 있고, 자동이든 사람이든 어떤 확인이 그걸 잡아야 하나”를 대신하기엔 부정확한 질문이라는 대목을 골라 소개했습니다.
해커뉴스의 개발자들도 같은 자리에서 고민하고 있습니다.
해커뉴스의 ‘Ask HN: How to deal with shipping AI-written code you don’t understand?’는 한 Meta 엔지니어의 링크드인 글에서 시작합니다. 요즘 코드를 쓰면 전부 블랙박스처럼 느껴지고, 일하면서 이렇게 불편했던 적이 없다는 글이었어요. 이 질문은 GeekNews에도 번역돼 올라왔습니다.
댓글의 답은 크게 두 갈래였습니다. 설계는 사람이 정하고 구현만 맡기면 개별 코드를 다 몰라도 시스템은 이해할 수 있다는 쪽, 그리고 코딩에서 아낀 시간을 테스트와 검증에 쓴다는 쪽입니다. 한 댓글은 만드는 시간과 비용은 줄었지만 검증과 테스트라는 새 일이 잔뜩 생긴 것 아니냐고 되물었습니다. 자동 테스트를 잔뜩 넣으면 검토할 코드가 오히려 늘어난다는 지적도 있었고요.
확인은 바뀐 것을 직접 재는 쪽에 둬야 합니다.
세 자료가 가리키는 곳은 같습니다. 에이전트의 말은 일이 끝났다는 증거가 되지 못하고, 바뀐 것을 직접 재는 확인이 마지막 단계에 있어야 합니다. 일의 종류에 따라 나누면 이렇습니다.
- 파일을 고치게 할 때: 맡기기 전과 뒤의 파일 지문(md5)이나 git diff를 비교합니다. 워니즈의 실행 3은 이 비교 한 번으로 드러났습니다.
- 기능을 고치게 할 때: 테스트와 빌드를 돌린 출력 자체를 받습니다. Anthropic이 말한 “말 대신 출력”입니다.
- 화면이 바뀌는 일일 때: Playwright 같은 브라우저 자동화로 스크린샷을 받아 디자인과 비교합니다.
- 서브에이전트에게 맡길 때: 일을 맡긴 에이전트에게 그 일을 할 도구가 있는지, 실제로 일한 쪽이 맡긴 쪽과 같은지를 봅니다. 실행 2와 3은 둘 다 여기서 어긋났습니다.
4번은 특히 놓치기 쉽습니다. 읽기 전용 에이전트에게 고치는 일을 맡기면, 일은 처음부터 불가능한데도 보고는 완료로 돌아올 수 있습니다. 검토 담당에게는 검토만 맡기고, 고치는 일은 편집 도구가 있는 쪽에 맡겨야 합니다.
다만 실행은 한 번씩이었습니다.
이 실험의 한계도 분명합니다. 워니즈가 적은 대로 각 실행은 한 번씩만 돌렸고, 모델은 Claude Haiku 4.5 하나뿐이며, 편집 도구를 준 에이전트는 재현하지 않았습니다. 대화형 화면이 아니라 -p(비대화형) 모드였고요. Claude Haiku 5.5나 Claude Opus 5.5 같은 새 모델에서도 같은 일이 생기는지, 몇 번 중에 몇 번 생기는지는 이 기록만으로는 알 수 없습니다.
그래도 보고와 파일 상태가 한 번이라도 달랐다면, 보고만 보고 넘어가는 흐름에는 구멍이 있다는 뜻입니다. Anthropic이 에이전트의 승인을 사람의 승인으로 치지 않는 것도 같은 맥락입니다.
AI가 코드를 쓰는 속도는 이미 사람이 읽는 속도를 넘어섰습니다. Claude Code 팀이 읽는 일의 대부분을 기계에 넘기고, 해커뉴스의 개발자들이 아낀 시간을 검증에 쓰는 것도 같은 흐름입니다. 앞으로 에이전트를 믿는 기준은 “다 했습니다”라는 말보다, 무엇을 돌려서 무엇을 확인했는지가 될 것 같습니다.