
HybridAgent는 왜 말 대신 숫자로 생각할까?
송찬우 8분 분량
10월 13일(미국 시간), 스탠퍼드와 Together AI, UIUC, Meta 연구진이 arXiv에 45쪽짜리 논문 ‘Hybrid Reasoning Agents’를 올렸습니다. 이름은 HybridAgent입니다. AI 에이전트가 속으로는 단어 없이 숫자로 생각하고, 도구를 쓰거나 답을 낼 때만 글로 바꾸는 방식입니다. 10월 19일 해커뉴스 1면에 오른 뒤 10월 20일 아침까지 502점, 댓글 236개가 달렸어요.
지금 쓰는 AI는 생각도 글로 합니다. Claude Code나 Codex가 일하는 화면을 보면, 답을 내기 전에 “먼저 파일 구조를 확인하고…” 같은 문장을 길게 써 내려가죠. 이 문장이 전부 토큰이고, 토큰이 곧 값이고 시간입니다. 그렇다면 말로 생각하지 않으면 더 싸고 빨라질까요? 그리고 말로 생각하지 않는 AI를 사람은 어떻게 지켜볼 수 있을까요?
결론부터 말하면, 더 싸고 빨라졌습니다.
논문이 내놓은 숫자는 세 가지입니다. 같은 문제를 푸는 데 쓰는 토큰이 35.5~54.7% 줄었고, 추론은 1.8~2.6배 빨라졌고, 비용은 2.7~3.7배 아꼈습니다.
비용은 문제 100만 개를 푼다고 놓고 계산했습니다. 8B 모델 기준으로 글로 생각하는 에이전트는 439달러(약 58만 원), HybridAgent는 121달러(약 16만 원)가 듭니다. 4B는 359달러(약 48만 원)에서 98달러(약 13만 원)로, 14B는 470달러(약 62만 원)에서 176달러(약 23만 원)로 줄었어요. 다만 H100 한 장을 시간당 2.5달러(약 3천 3백 원)에 빌려 성능의 10%를 쓴다고 가정한 값이고, 답을 만들어 내는 연산만 셌습니다.
생각은 숫자로, 행동은 글로 합니다.
AI 모델은 한 단계마다 속에서 숫자 덩어리(벡터)를 만들고, 마지막에 그 숫자를 단어 하나로 바꿔 내보냅니다. 그리고 그 단어를 다시 읽어 다음 단계를 이어 가요. 생각을 글로 쓴다는 건, 매번 풍부한 숫자를 단어 하나로 줄였다가 다시 읽는다는 뜻입니다.
HybridAgent는 이 과정을 건너뜁니다. HybridLink라는 작은 연결부가 마지막 층의 숫자를 입력 쪽으로 바로 돌려보내서, 단어로 바꾸지 않고 다음 생각을 이어 가게 합니다. 이걸 잠재 모드라고 부릅니다. 파이썬을 돌리거나 검색을 하거나 답을 쓸 때는 글 모드로 돌아옵니다. 숫자로 한 생각과 글, 도구 결과는 모두 작업 기억에 그대로 남아서 여러 차례 이어집니다.
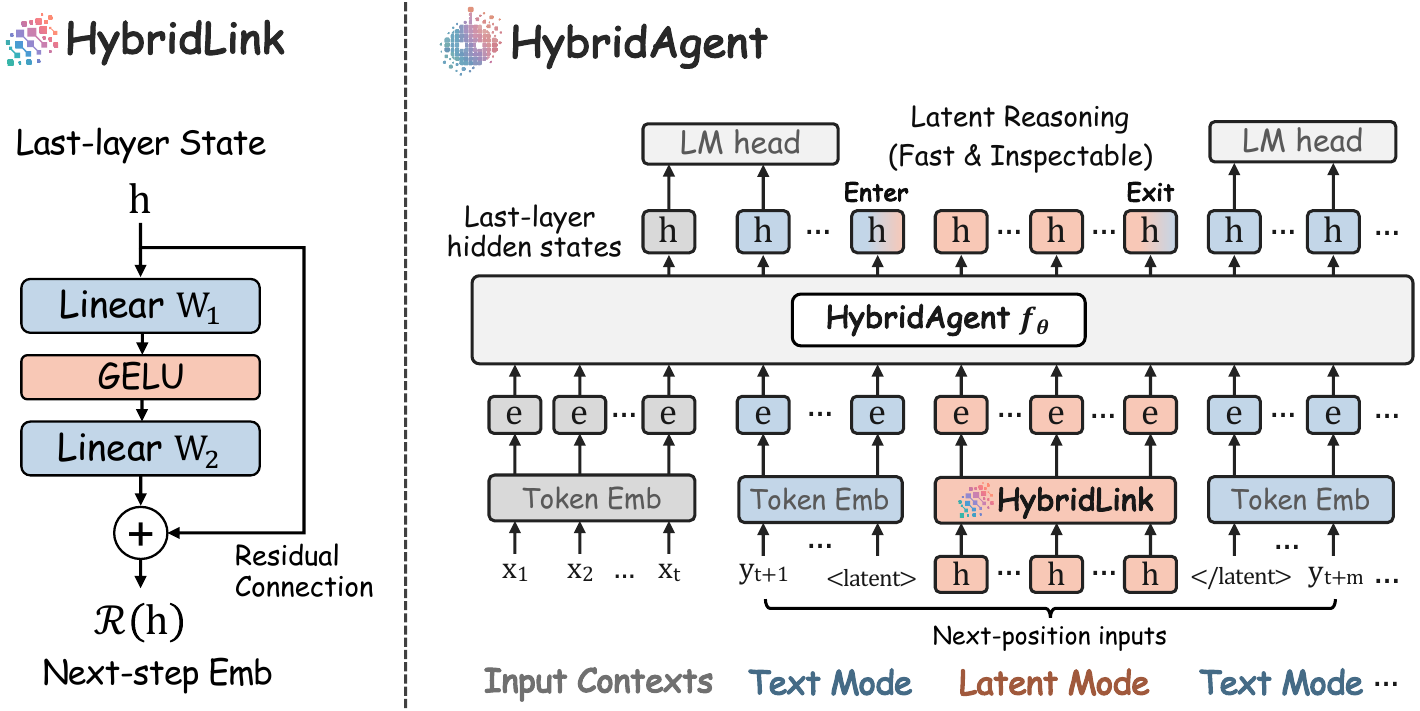
뼈대는 알리바바의 Qwen3–8B-Base와 Qwen3–14B-Base입니다. 4B로도 실험했고요. 여기에 학습을 두 단계 얹었습니다. HybridSFT로 글과 숫자를 오가는 법을 익히고, HybridRL로 언제 숫자로 생각하고 언제 글로 행동할지를 스스로 정하게 했습니다.
생각을 전부 글로 쓰면 맥락도 그만큼 길어집니다. 지난 9월 ‘AI는 왜 오래 일하면 바보가 될까?’에서 소개했던, 맥락이 길어질수록 흐려지는 바로 그 문제입니다.
작은 모델이 큰 모델을 이긴 곳도, 진 곳도 있습니다.
연구진은 수학, 과학, 의학, 검색, 에이전트 작업에 걸친 벤치마크 11개로 시험했습니다. 에이전트 벤치마크에서 HybridAgent (14B)는 GAIA 평균 52.4점으로 GPT-5.6 Luna(37.9점), Kimi-K3(41.7점), DeepSeek V4.1 Flash(39.8점)를 앞섰습니다. 웹사이트를 돌아다니며 답을 찾는 WebWalker에서는 49.5점 대 11.0점, 10.0점, 16.5점으로 차이가 더 컸어요.
반대로 어려운 지식 문제를 모은 HLE에서는 16.0점으로 Kimi-K3(31.4점)의 절반 수준이었고, DeepSearchQA에서도 GPT-5.6 Luna에 조금 밀렸습니다. 비교 대상도 지금의 GPT-6 Luna가 아니라 한 세대 전인 GPT-5.6 Luna입니다.
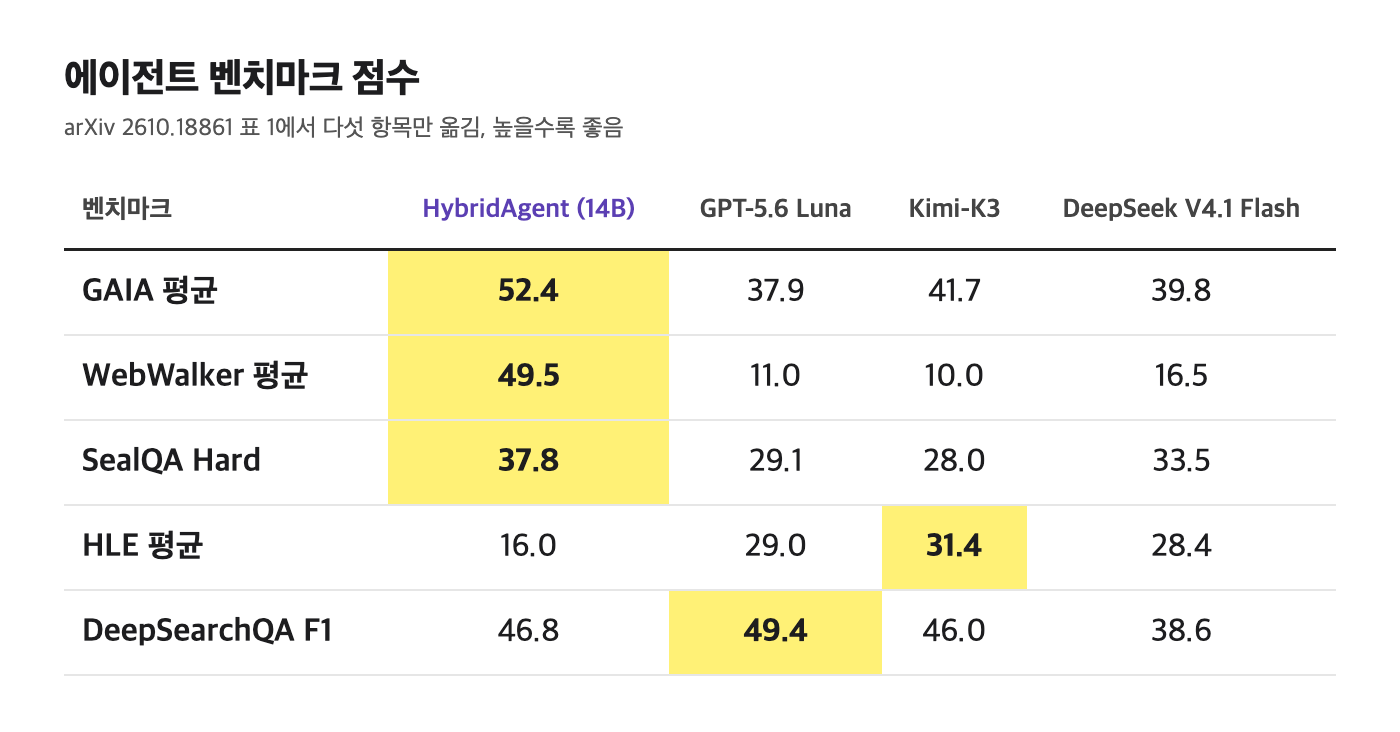
그래서 초록에 적힌 ‘평균 10.4% 향상’도 읽는 법이 중요합니다. 본문을 보면 이 숫자는 같은 크기, 같은 학습 예산으로 만든 글 기반 에이전트와 잠재 추론 에이전트에 견준 값입니다. 프런티어 모델보다 10.4% 낫다는 뜻은 아니에요. 14B 모델이 가장 강한 에이전트 기준 모델보다 평균 17.4% 높았다는 숫자도 함께 실려 있습니다.
숫자로 한 생각도 읽을 수는 있습니다.
말로 생각하지 않으면 사람이 그 생각을 볼 수 없게 됩니다. 그래서 연구진은 숫자로 한 생각을 단계마다 가장 가까운 단어로 바꿔 읽는 방법을 같이 내놨습니다. 깃허브에 실린 예시에서 HybridAgent-14B는 소리가 10km를 가는 데 몇 초 걸리는지 묻자 속으로 “Wait, I me the the speed of speed in air at 20° is about 343 meters per second. But I should verify that.”이라고 생각했습니다. 뜻은 통하지만 문장은 거칩니다. 그다음 검색으로 초속 343m를 확인하고, 파이썬으로 계산해 29초라고 답했어요.
사람이 지켜보기 어려워지는지도 쟀습니다. HybridAgent가 겉으로 쓰는 글은 같은 크기의 글 기반 에이전트보다 43~49% 적었습니다(8B는 302토큰 대 596토큰, 14B는 284토큰 대 497토큰). 그런데 다른 AI(GPT-4o-mini)에게 겉으로 드러난 글만 보여 주고 답이 맞았을지 가려내게 했더니, 정확도(AUROC, 1에 가까울수록 좋음)가 8B에서 0.840 대 0.772, 14B에서 0.860 대 0.818로 오히려 높았습니다. 글 100토큰에 담긴 핵심 단계도 0.72개 대 0.57개로 더 많았어요. 처음 틀린 단계를 짚어 낸 비율은 8B에서 99.2% 대 94.2%로 높았고, 14B에서는 98.1% 대 100.0%로 조금 낮았습니다.
해커뉴스에서는 ‘가장 금지된 기술’이라는 말이 나왔습니다.
해커뉴스에서 가장 긴 댓글 타래(답글 76개)는 “Most Forbidden Technique”이라는 한 줄에서 시작됐습니다. AI 안전 쪽에서 쓰는 말로, AI의 생각을 들여다보는 수단을 학습으로 망가뜨리는 일을 가리킵니다. 생각이 글로 남아 있어야 이상한 낌새를 잡을 수 있는데, 그 창을 스스로 닫는다는 걱정입니다.
연구진의 답은 논문 8장에 있습니다. 숫자로 한 생각은 제공자가 가진 HybridLink로만 읽을 수 있어서 글로 새어 나갈 일이 없고, 제공자는 사용자에게 보이지 않는 부분까지 전부 읽어 안전을 점검할 수 있다는 겁니다. 사용자는 도구 호출, 중요한 결정, 최종 답처럼 꼭 필요한 글만 봅니다. 논문은 OpenAI와 Anthropic도 이미 API 고객에게 추론 과정을 감추고 있다고 짚습니다. 결국 생각을 읽을 수 있는 쪽이 제공자 하나로 좁혀지는 셈이에요.
직접 돌리려면 24GB GPU 한 장이면 됩니다.
모델은 허깅페이스에 MIT 라이선스로 올라와 있습니다. HybridAgent-8B-Agentic은 파라미터 82억 개로 BF16 파일이 약 16.4GB라서, 메모리 24GB짜리 GPU 한 장에 올라갑니다. AWS에서 이런 GPU 한 장짜리 서버(g5.xlarge)는 시간당 1.006달러(약 1천 3백 원), 한 달 내내 켜 두면 약 724달러(약 96만 원)입니다. HybridAgent-14B-Agentic은 148억 개, 약 29.5GB라서 48GB GPU가 필요하고, AWS g6e.xlarge가 시간당 1.861달러(약 2천 5백 원), 한 달이면 약 1,340달러(약 178만 원)입니다.
다만 아무 실행 도구로나 돌릴 수는 없습니다. 숫자로 생각하는 모드를 쓰려면 깃허브에 공개된 전용 생성 엔진과 엔비디아 GPU(CUDA)가 필요합니다. 맥이나 일반 PC에서 많이 쓰는 llama.cpp용 양자화 파일(GGUF)도 올라와 있지만 잠재 모드를 지원하지 않아서, 해커뉴스에서 써 본 사람들은 같은 문단이 되풀이된다고 했습니다. 직접 학습까지 하려면 HybridSFT에 GPU 8~16장, HybridRL에 32장(8장짜리 서버 4대)을 권장합니다.
아직은 연구 단계입니다.
한계도 분명합니다. 비교한 프런티어 모델이 한 세대 전 버전이고, HLE처럼 지식이 많이 필요한 문제에서는 큰 모델에 크게 밀립니다. 비용은 가정을 깔고 답을 만드는 연산만 센 값이라 실제 서비스 비용과는 다를 수 있습니다. 기존 서빙 엔진으로는 돌릴 수 없어서 연구진이 추론 환경을 직접 만들었고, 서비스에 붙이려면 이 부분부터 손봐야 합니다. 벤치마크 밖의 일반 대화에서 어떤지도 아직 알 수 없어요.
지금까지 AI를 더 똑똑하게 만드는 방법은 더 길게 생각하게, 그러니까 더 많이 쓰게 하는 쪽이었습니다. HybridAgent는 덜 쓰고 더 생각하게 하는 반대 방향을 보여 줍니다. 값과 속도를 보면 이 방향으로 가는 곳이 늘어날 것 같은데, 그럴수록 AI의 생각을 누가 읽을 수 있느냐가 더 중요한 질문이 될 듯싶습니다.